Reglyph
Reglyph 可将扫描件和纯图像 PDF 文件翻译成多种语言,同时保留原始页面的排版格式、表格结构和所有视觉元素。
翻译及抄录翻译扫描件或纯图像 PDF 文件,同时保留原始页面几何结构和排版。在翻译过程中保留多栏布局、表格行和单独的单元格结构。在原位保持原始签名、图章、印章、图形和照片。将翻译结果导出为标准 PDF 或逐页对照的双语文档。扫描 PDF 翻译PDF 翻译器翻译扫描文档文档翻译证书翻译双语 PDFOCR 翻译保留版式的翻译
Reglyph 可将扫描件和纯图像 PDF 文件翻译成多种语言,同时保留原始页面的排版格式、表格结构和所有视觉元素。
产品用途与官方定位
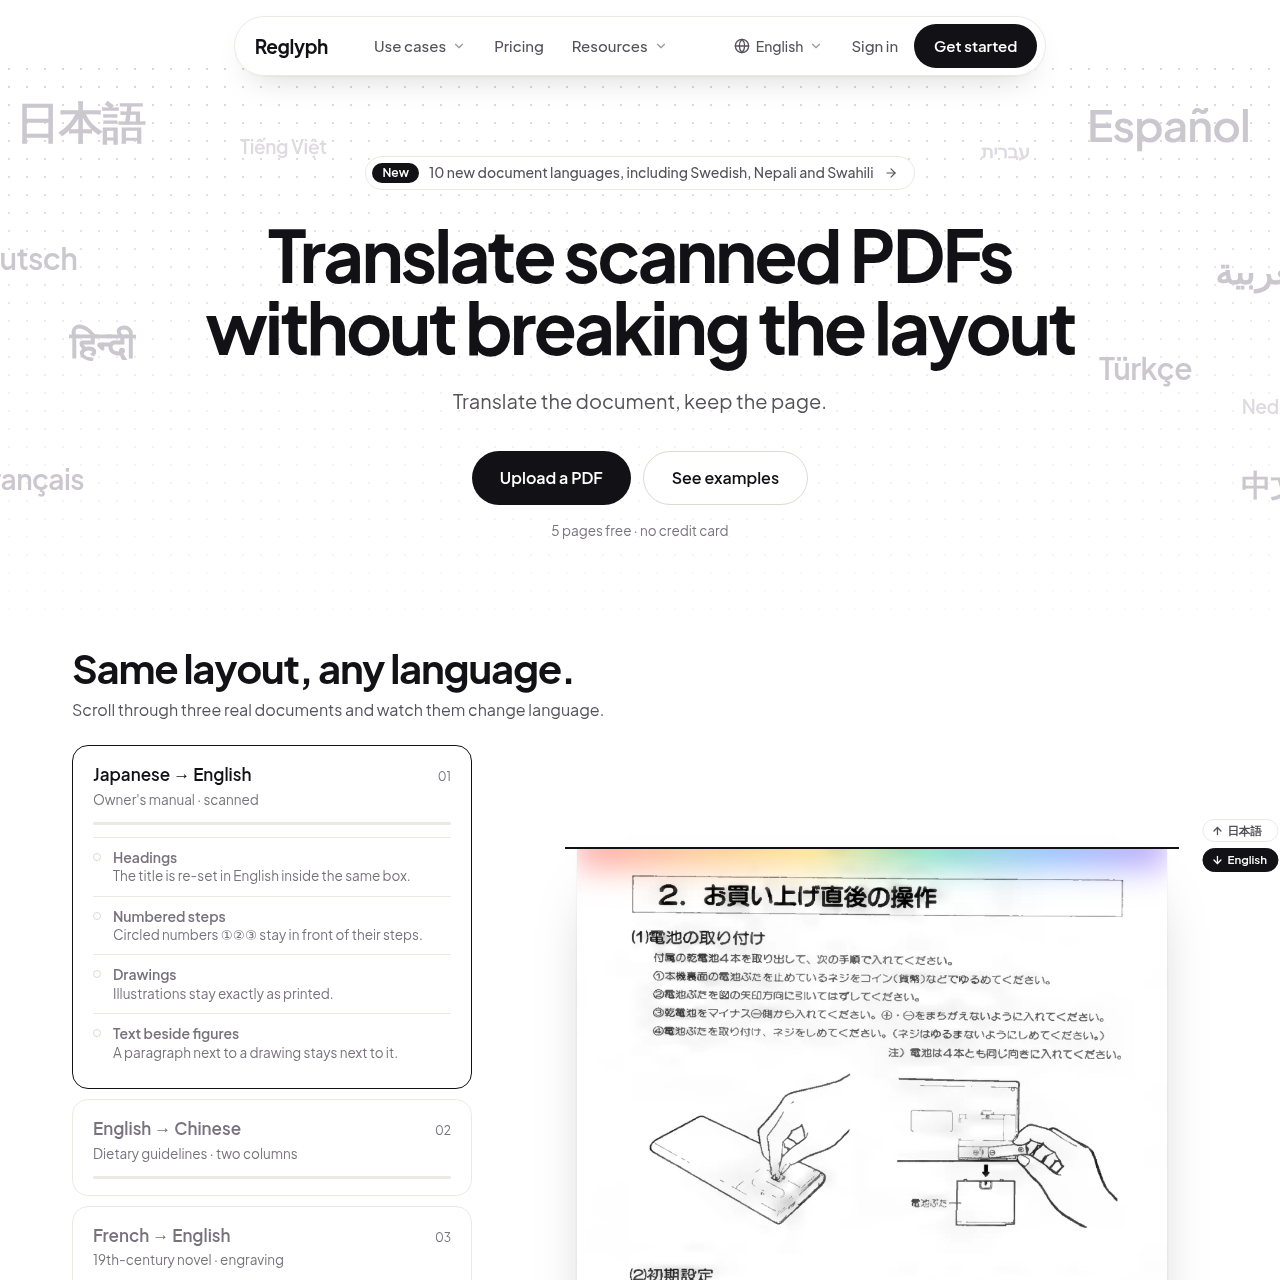
Reglyph 可翻译扫描版和仅含图像的 PDF,并以原始版式交付。它会读取每一页,移除源文本,再将译文放回相同位置,因此栏、表格、印章、签名和数字都会保持原位。 它专为普通翻译工具难以处理的文档而设计:出生证明和结婚证、成绩单和文凭、合同、银行对账单、手册、书籍和学术论文。它支持 40+ 种语言的双向翻译,也能处理数字 PDF。 您可以下载翻译后的 PDF,或下载并排对照的双语 PDF,以便将每一行与原文进行核对。输入格式仅限 PDF:扫描件、数字文件,或通过手机扫描应用生成的 PDF。 这是机器翻译,不是认证翻译。对于官方提交材料,认证译员可以直接根据这份忠实保留版式的草稿工作,而无需重新输入文档。
Reglyph 是一款专门为缺乏可选文本层的扫描件和基于图像的 PDF 文件而设计的文档翻译工具。
该服务对上传的页面执行自动光学字符识别,在多栏布局和表格中原位替换文本,并提供标准和双语 PDF 下载功能。
有官方来源支持的使用场景
在翻译成绩单时保留成绩表格行、列对齐方式和标题结构。
转换银行对账单时保留表格中的余额行和账号,确保它们位于原始位置。
翻译协议和合同时保持条款编号、子句顺序以及原始的布局排版格式。
官网提供的使用流程
上传最大 100 MB 和 300 页的扫描件或图像 PDF,支持自动识别源语言。
系统应用光学字符识别技术,并将翻译后的文本直接插入到原始页面的位置。
将翻译页面与原始文档进行比对,并下载翻译后的 PDF 或并排双语 PDF。
标准翻译工具经常在处理扫描 PDF 文件时失败,因为基于图像的文档不包含底层文本层,导致输出空白或字符乱码。Reglyph 通过在翻译前直接对图像运行光学字符识别来解决此问题,无需手动转录或使用单独的 OCR 工具。
系统不会将文本提取到无格式的文档中,而是直接在原始边界区域内替换源文本。多栏结构、表格、标题和编号步骤保持与打印时相同的位置,同时印章、签名、图章和照片等非文本图形保持不变。
由用户或管理员维护的商业信息
价格可能变化。购买前请到官方网站确认最新套餐和计费条款。
用自己的素材和工作流完成验证
核对了哪些信息以及核对时间
基于已核对产品资料的回答
扫描 PDF 由没有嵌入文本层的图像组成。期望可选择文本的翻译系统如果不先执行光学字符识别来提取可读字符,就会失败或产生乱码。
不需要手动 OCR 步骤。Reglyph 在开始翻译之前,直接对扫描件和图像 PDF 执行自动光学字符识别。
上传的 PDF 文档最多可包含 300 页,且每个文件的最大文件大小限制为 100 MB,请务必遵守此限制。
图章、印章、签名、数字、图画和照片不会被翻译或重绘;它们会被原样保留在页面上的原始位置。
用户可以下载保留原始布局的翻译版 PDF,或者下载一份并排显示原始页面和翻译页面的双语 PDF 文件。