Reglyphとは?製品概要
製品の機能と公式な位置づけ
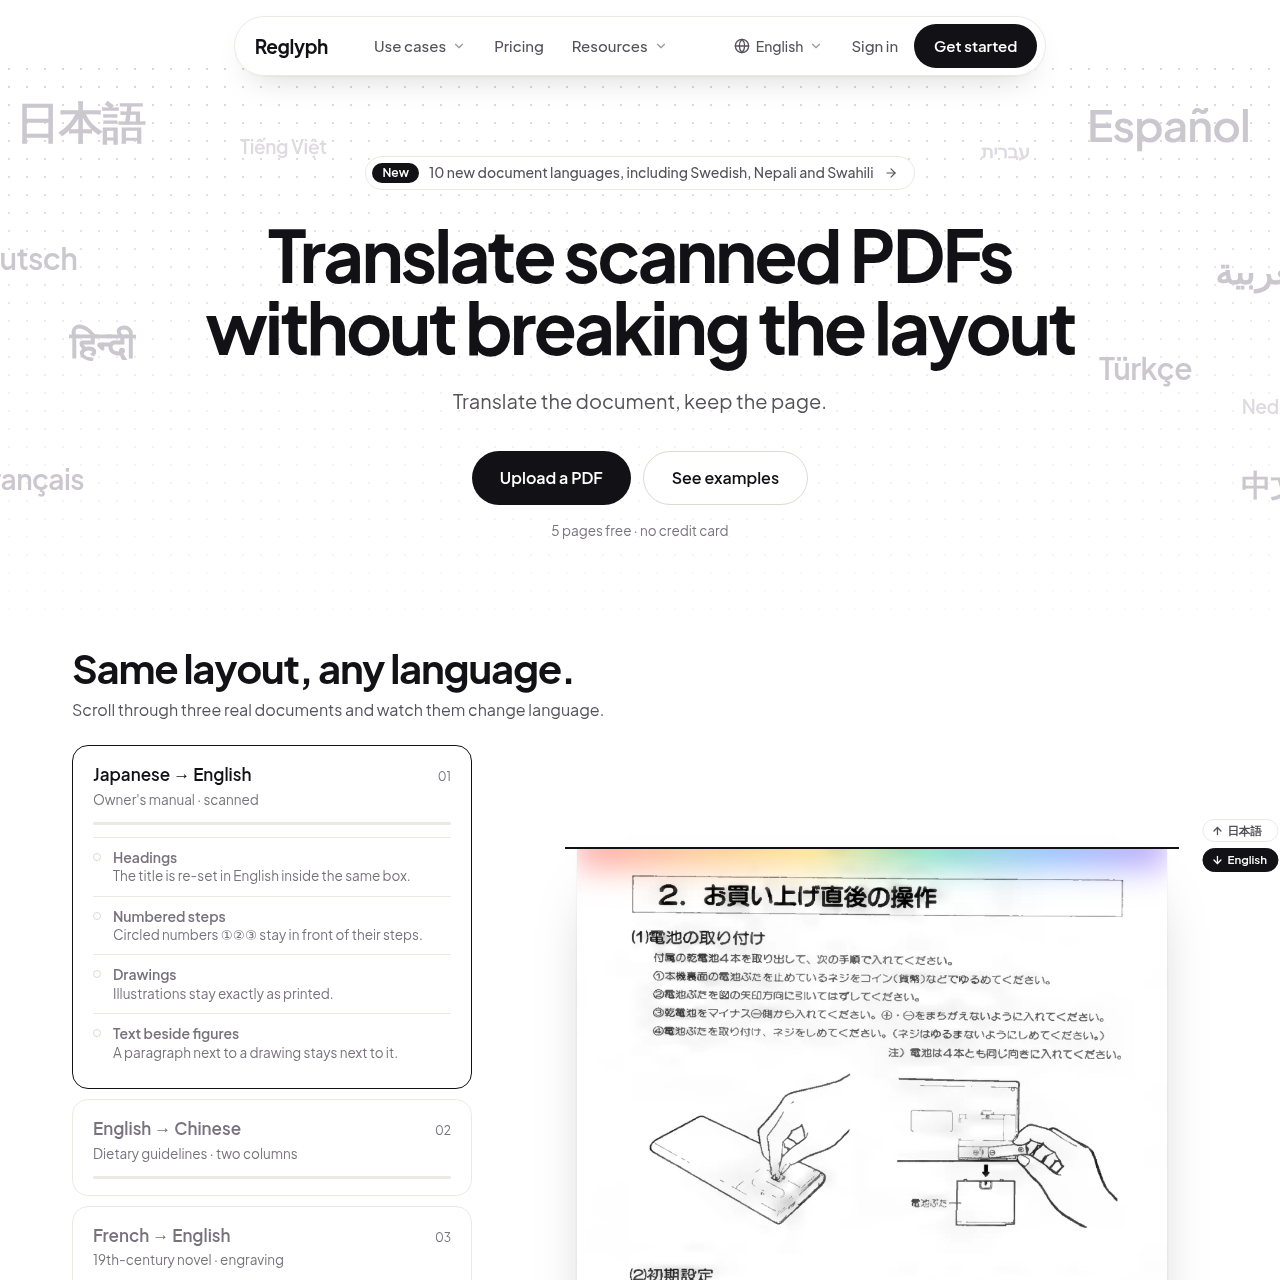
ReglyphはスキャンされたPDFや画像のみのPDFを翻訳し、元のレイアウトのまま返します。各ページを読み取り、原文テキストを削除して、同じ場所に翻訳文を戻すため、段組み、表、スタンプ、署名、数字は元の位置に残ります。
通常の翻訳ツールでは崩れてしまう文書向けに作られています:出生証明書や婚姻証明書、成績証明書や卒業証書、契約書、銀行取引明細書、マニュアル、書籍、学術論文などです。40以上の言語に対応し、双方向で利用でき、デジタルPDFも処理できます。
翻訳済みPDF、または原文とすべての行を照合できる横並びのバイリンガルPDFをダウンロードできます。入力はPDFのみです:スキャン、デジタルファイル、またはスマートフォンのスキャナーアプリから作成したPDFです。
機械翻訳であり、認証翻訳ではありません。公的な提出用には、認証翻訳者が文書を再入力する代わりに、レイアウトを忠実に保った下書きを使って作業できます。
Reglyphは、選択可能なテキストレイヤーが存在しないスキャン文書や画像ベースのPDFファイル専用に設計されたドキュメント翻訳ツールです。
本サービスはアップロードされたページに対して自動光学文字認識(OCR)を実行し、段組みレイアウトや表内のテキストをその場で置換して、標準PDFと対訳PDFの両方のダウンロードを提供します。
Reglyphで何ができますか?
公式情報で確認できる活用例
学業成績証明書
成績表の行、列の配置、およびヘッダー構造を維持しながら教育記録を翻訳します。
銀行取引明細書
表形式の残高行や口座番号を元の位置に保持したまま、財務明細書を別の言語へと変換します。
法的文書・契約書
条項の番号付け、条文の順序、および元のレイアウト形式を維持しながら合意書や契約書を翻訳します。
Reglyphの使い方
公式情報に記載された利用手順
- 1
ドキュメントのアップロード
最大100MBかつ300ページまでのスキャン済みまたは画像PDFをアップロードします。元の言語の自動検出も利用可能です。
- 2
インプレース翻訳
システムが光学文字認識を適用し、元のページの配置位置に翻訳されたテキストを直接挿入します。
- 3
確認とダウンロード
元のドキュメントと翻訳されたページを照合・確認し、翻訳済みPDFまたは見開き対訳PDFのいずれかをダウンロードします。
元の配置の再構築とレイアウトの保持
一般的な翻訳ツールは、画像ベースの文書にテキストレイヤーが含まれていないためスキャン済みPDFで失敗することが多く、空白が出力されたり文字化けが発生したりします。Reglyphは翻訳前に画像に対して直接光学文字認識(OCR)を実行することでこの問題に対処し、手動での書き起こしや個別のOCRツールの必要性を排除します。
書式のないドキュメントにテキストを抽出するのではなく、システムは元の領域内に原文テキストを直接置き換えます。段組み構造、表、見出し、番号付き手順は最初に印刷された通りの位置に留まり、署名、印鑑、スタンプ、写真などの非テキストグラフィックは変更されないまま保持されます。
- 翻訳前にスキャンされたページに対して光学文字認識を実行。
- 表のセル、行の境界線、複数列の段組みフォーマットを保持。
- 印鑑、スタンプ、署名、写真要素を元の位置にそのまま維持。
- 標準的な翻訳済みPDFまたは並列比較可能な見開き対訳文書を出力。
Reglyphの料金
ユーザーまたは管理者が提供した商用情報
料金は変更される場合があります。購入前に公式サイトで最新のプランと請求条件を確認してください。
Reglyphを選ぶ前に確認すること
自分の素材とワークフローで確認したい項目
- ドキュメントファイルがプラットフォームの上限である1ファイルあたり100MBまたは300ページを超えていないことを確認すること。
- プラットフォームはスタンプ、印鑑、署名などの非テキスト要素を翻訳せず画像として保持するため、それらの翻訳が必要かどうかを確認すること。
- 対象となるドキュメントの言語ペアがプラットフォームでサポートされていることを確認すること。
Reglyphの情報源と確認日
確認した情報源とその日時
- 最終確認日
Reglyphのよくある質問
情報源を確認した製品情報に基づく回答
なぜ一般的な翻訳サービスはスキャンされたPDFで失敗したり、文字化けを起こしたりするのですか?+
スキャンされたPDFはテキストレイヤーが埋め込まれていない画像で構成されています。選択可能なテキストを前提とする翻訳システムは、読み取り可能な文字を抽出するために事前に光学文字認識(OCR)を実行しない限り、処理に失敗するか文字化けを発生させます。
Reglyphを使用する前に、手動でOCR処理を行う必要がありますか?+
手動でのOCR処理ステップは一切必要ありません。Reglyphは、翻訳プロセスを開始する前に、スキャン済みPDFや画像PDFに対して自動光学文字認識を直接実行します。
アップロードにはどのようなドキュメントサイズの制限が適用されますか?+
アップロードするPDFドキュメントには、1ファイルあたり最大300ページまで、かつ最大ファイルサイズ100MB以下という制限が適用されます。
スタンプ、印鑑、署名なども翻訳されますか?+
スタンプ、印鑑、署名、数字、図表、写真は翻訳や再描画の対象にはならず、ページ内の元の位置にそのまま完全な状態で残されます。
翻訳後はどのようなファイル形式で提供されますか?+
元のレイアウトを完全に維持した単一言語の翻訳済みPDF、または元のページと翻訳後のページを左右に並べて表示する見開き対訳PDFをダウンロードできます。