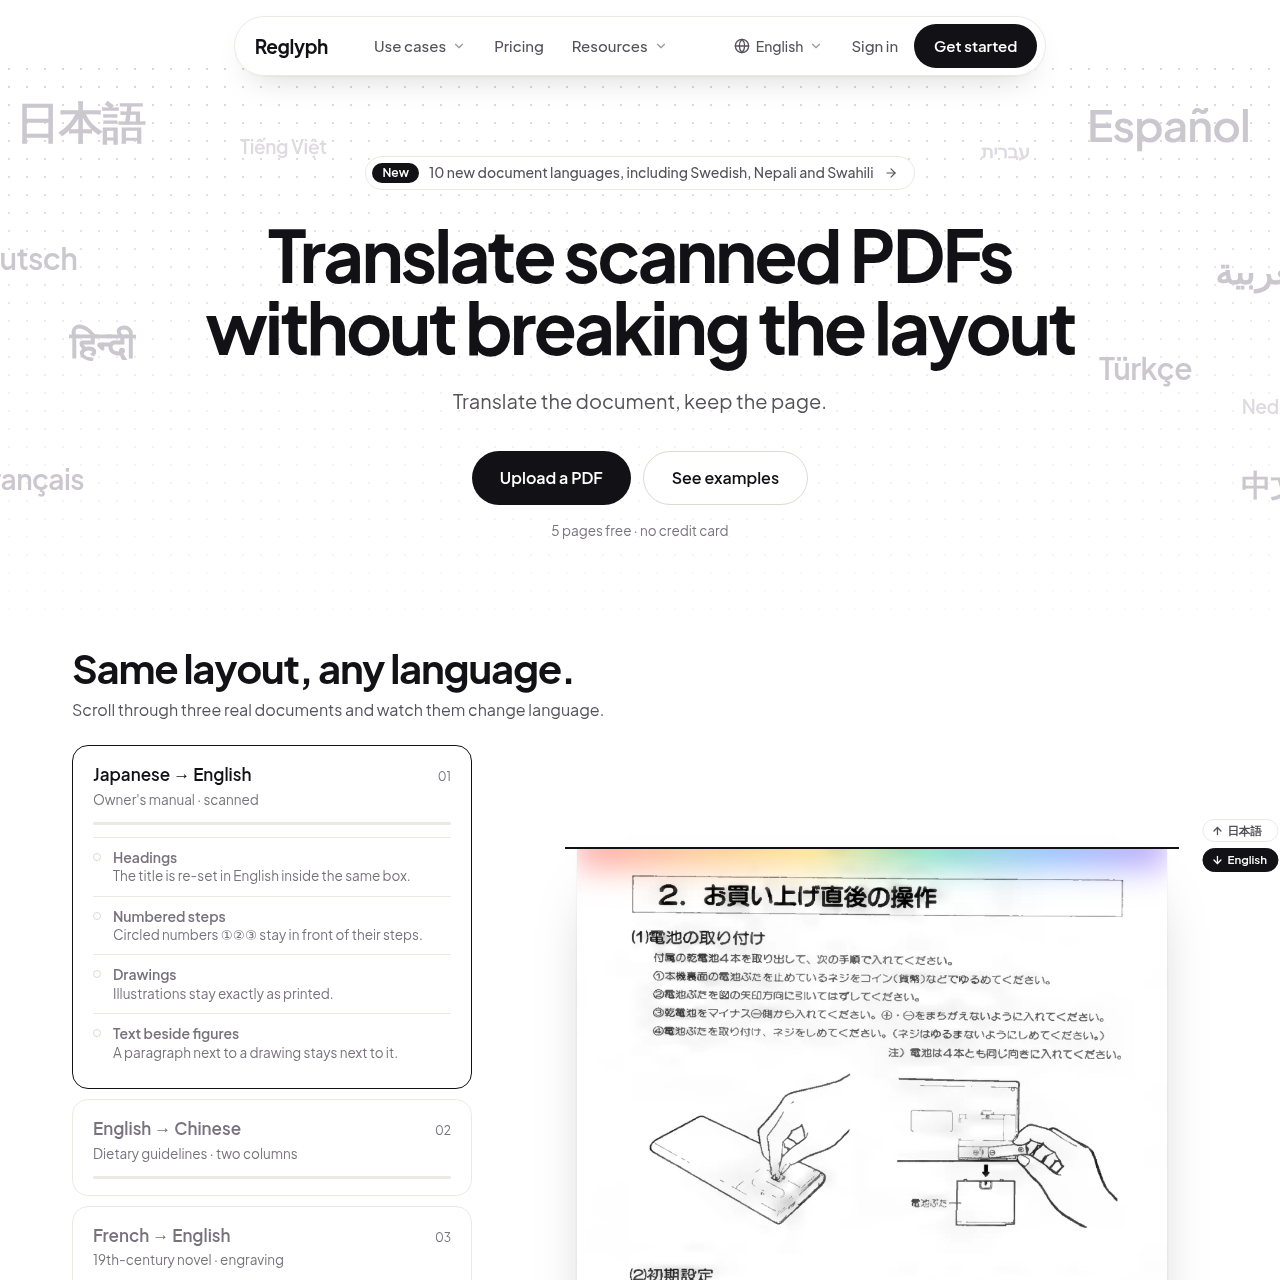
Reglyph übersetzt gescannte und bildbasierte PDF-Dateien in ausgewählte Sprachen, während das ursprüngliche Seitenlayout, Tabellen und visuelle Elemente erhalten bleiben.
Übersetzung und TranskriptionÜbersetzung gescannter oder…Bewahrung von mehrspaltigen Layouts,…Beibehaltung der ursprünglichen…Export der übersetzten Ausgabe als…Übersetzung gescannter PDFsPDF-Übersetzergescannte Dokumente übersetzenDokumentenübersetzungUrkundenübersetzungzweisprachiges PDFOCR-Übersetzunglayoutgetreue Übersetzung
Geschätzte monatliche Besuche
1000
Datenzeitraum:
Bei AIToolly gelistet
Was ist Reglyph? Produktübersicht
Funktion und offizielle Positionierung des Produkts
Reglyph übersetzt gescannte und bildbasierte PDFs und gibt sie im ursprünglichen Layout zurück. Jede Seite wird gelesen, der Quelltext entfernt und die Übersetzung wieder an der gleichen Stelle eingefügt, sodass Spalten, Tabellen, Stempel, Unterschriften und Zahlen dort bleiben, wo sie waren.
Es wurde für Dokumente entwickelt, die gewöhnliche Übersetzer zerstören: Geburts- und Heiratsurkunden, Transkripte und Diplome, Verträge, Kontoauszüge, Handbücher, Bücher und wissenschaftliche Arbeiten. Es funktioniert in über 40 Sprachen, in beide Richtungen und verarbeitet auch digitale PDFs.
Sie können das übersetzte PDF herunterladen oder ein zweisprachiges PDF zum direkten Vergleich, um jede Zeile mit dem Original zu prüfen. Die Eingabe ist nur im PDF-Format möglich: ein Scan, eine digitale Datei oder ein PDF aus einer Telefon-Scanner-App.
Es handelt sich um eine maschinelle Übersetzung, keine beglaubigte Übersetzung. Für offizielle Einreichungen kann ein beeidigter Übersetzer mit dem layoutgetreuen Entwurf arbeiten, anstatt das Dokument neu abzutippen.
Reglyph ist ein Dokumentenübersetzungstool, das speziell für gescannte und bildbasierte PDF-Dateien ohne auswählbare Textebene entwickelt wurde.
Der Dienst führt eine automatisierte optische Zeichenerkennung auf hochgeladenen Seiten aus, ersetzt Text direkt in mehrspaltigen Layouts und Tabellen und bietet sowohl Standard- als auch zweisprachige PDF-Downloads an.
Wofür kann Reglyph verwendet werden?
Durch offizielle Quellen belegte Anwendungsfälle
Akademische Zeugnisse
Übersetzung von Bildungsunterlagen unter Beibehaltung von Zeugniszeilen, Spaltenausrichtungen und Kopfzeilenstrukturen.
Bankauszüge
Konvertierung von Finanzberichten in eine andere Sprache bei gleichzeitiger Beibehaltung von Tabellenzeilen für Kontostände und Kontonummern an ihren ursprünglichen Positionen.
Rechtliche Dokumente
Übersetzung von Vereinbarungen und Verträgen unter Beibehaltung von Abschnittsnummerierungen, Klauselsequenzen und der ursprünglichen Layout-Formatierung.
So verwenden Sie Reglyph
Der dokumentierte Ablauf, sofern verfügbar
1
Dokument hochladen
Laden Sie ein gescanntes oder Bild-PDF mit bis zu 100 MB und 300 Seiten hoch; eine Quellsprachenerkennung ist verfügbar.
2
In-Place-Übersetzung
Das System wendet optische Zeichenerkennung an und fügt den übersetzten Text direkt an den ursprünglichen Seitenpositionen ein.
3
Überprüfen und herunterladen
Überprüfen Sie die übersetzten Seiten anhand des Originaldokuments und laden Sie entweder ein übersetztes PDF oder ein zweisprachiges PDF zum Vergleich herunter.
In-Place-Rekonstruktion und Layout-Erhaltung
Standard-Übersetzungstools scheitern häufig bei gescannten PDF-Dateien, da bildbasierte Dokumente keine zugrunde liegende Textebene enthalten, was zu leeren Ausgaben oder beschädigten Zeichen führt. Reglyph löst dieses Problem durch die Anwendung optischer Zeichenerkennung direkt auf das Bild vor der Übersetzung, wodurch manuelle Transkriptionen oder separate OCR-Tools überflüssig werden.
Anstatt Text in ein unformatiertes Dokument zu extrahieren, ersetzt das System den Quelltext direkt innerhalb seines ursprünglichen Begrenzungsbereichs. Mehrspaltige Strukturen, Tabellen, Überschriften und nummerierte Schritte bleiben wie ursprünglich gedruckt positioniert, während Nicht-Text-Grafiken wie Unterschriften, Siegel, Stempel und Fotos unverändert bleiben.
Führt vor der Übersetzung eine optische Zeichenerkennung auf gescannten Seiten durch.
Bewahrt Tabellenzellen, Zeilengrenzen und mehrspaltige Formatierungen.
Belässt Siegel, Stempel, Unterschriften und fotografische Elemente an ihren ursprünglichen Positionen.
Gibt standardmäßige übersetzte PDFs oder zweisprachige Vergleichsdokumente nebeneinander aus.
Reglyph Preise
Von Nutzern oder Administratoren gepflegte Preisangaben
creditsfreemium
USD 3
Preise können sich ändern. Prüfen Sie vor dem Kauf die aktuellen Tarife und Abrechnungsbedingungen auf der offiziellen Website.
Was Sie vor der Wahl von Reglyph testen sollten
Prüfungen mit eigenen Inhalten und Arbeitsabläufen
Stellen Sie sicher, dass die Dokumentdateien die Plattformgrenzen von 100 MB oder 300 Seiten pro Datei nicht überschreiten.
Prüfen Sie, ob Nicht-Text-Elemente wie Stempel, Siegel oder Unterschriften übersetzt werden müssen, da die Plattform diese als Bilder ohne Übersetzung beibehält.
Bestätigen Sie, dass die Zielsprachenkombination für das Dokument von der Plattform unterstützt wird.
Antworten auf Basis des quellengeprüften Produkteintrags
Warum scheitern Standard-Übersetzungsdienste bei gescannten PDFs oder produzieren unleserlichen Text?+
Gescannte PDFs bestehen aus Bildern ohne eingebettete Textebene. Übersetzungssysteme, die auswählbaren Text erwarten, scheitern oder produzieren unleserlichen Text, es sei denn, es wird zuerst eine optische Zeichenerkennung durchgeführt, um die lesbaren Zeichen zu extrahieren.
Erfordert Reglyph eine manuelle OCR vor dem Hochladen eines Dokuments?+
Nein, es ist kein manueller OCR-Schritt erforderlich. Reglyph führt automatisch eine optische Zeichenerkennung direkt auf gescannten und Bild-PDFs aus, bevor die Übersetzung gestartet wird.
Welche Dokumentgrößenbeschränkungen gelten für Uploads?+
Hochgeladene PDF-Dokumente können bis zu 300 Seiten enthalten und dürfen eine maximale Dateigröße von 100 MB pro Datei nicht überschreiten.
Werden Stempel, Siegel und Unterschriften übersetzt?+
Stempel, Siegel, Unterschriften, Nummern, Zeichnungen und Fotos werden nicht übersetzt oder neu gezeichnet; sie bleiben intakt an ihren ursprünglichen Positionen auf der Seite.
Welche Dateiformate werden nach der Übersetzung bereitgestellt?+
Benutzer können ein übersetztes PDF herunterladen, das das ursprüngliche Layout beibehält, oder ein zweisprachiges PDF, das die Original- und übersetzten Seiten nebeneinander darstellt.
Weitere KI-Tools für Übersetzung und Transkription
Entdecken Sie weitere kürzlich hinzugefügte Tools derselben Kategorie.