Transcribe Audio to Text
Audio Converter AI 推出的 Transcribe Audio to Text 可将音频与视频口语录音转换为支持搜索和编辑的文本转录稿,支持超过200种语言,并提供说话人识别、时间戳以及自动化摘要生成功能。
产品用途与官方定位
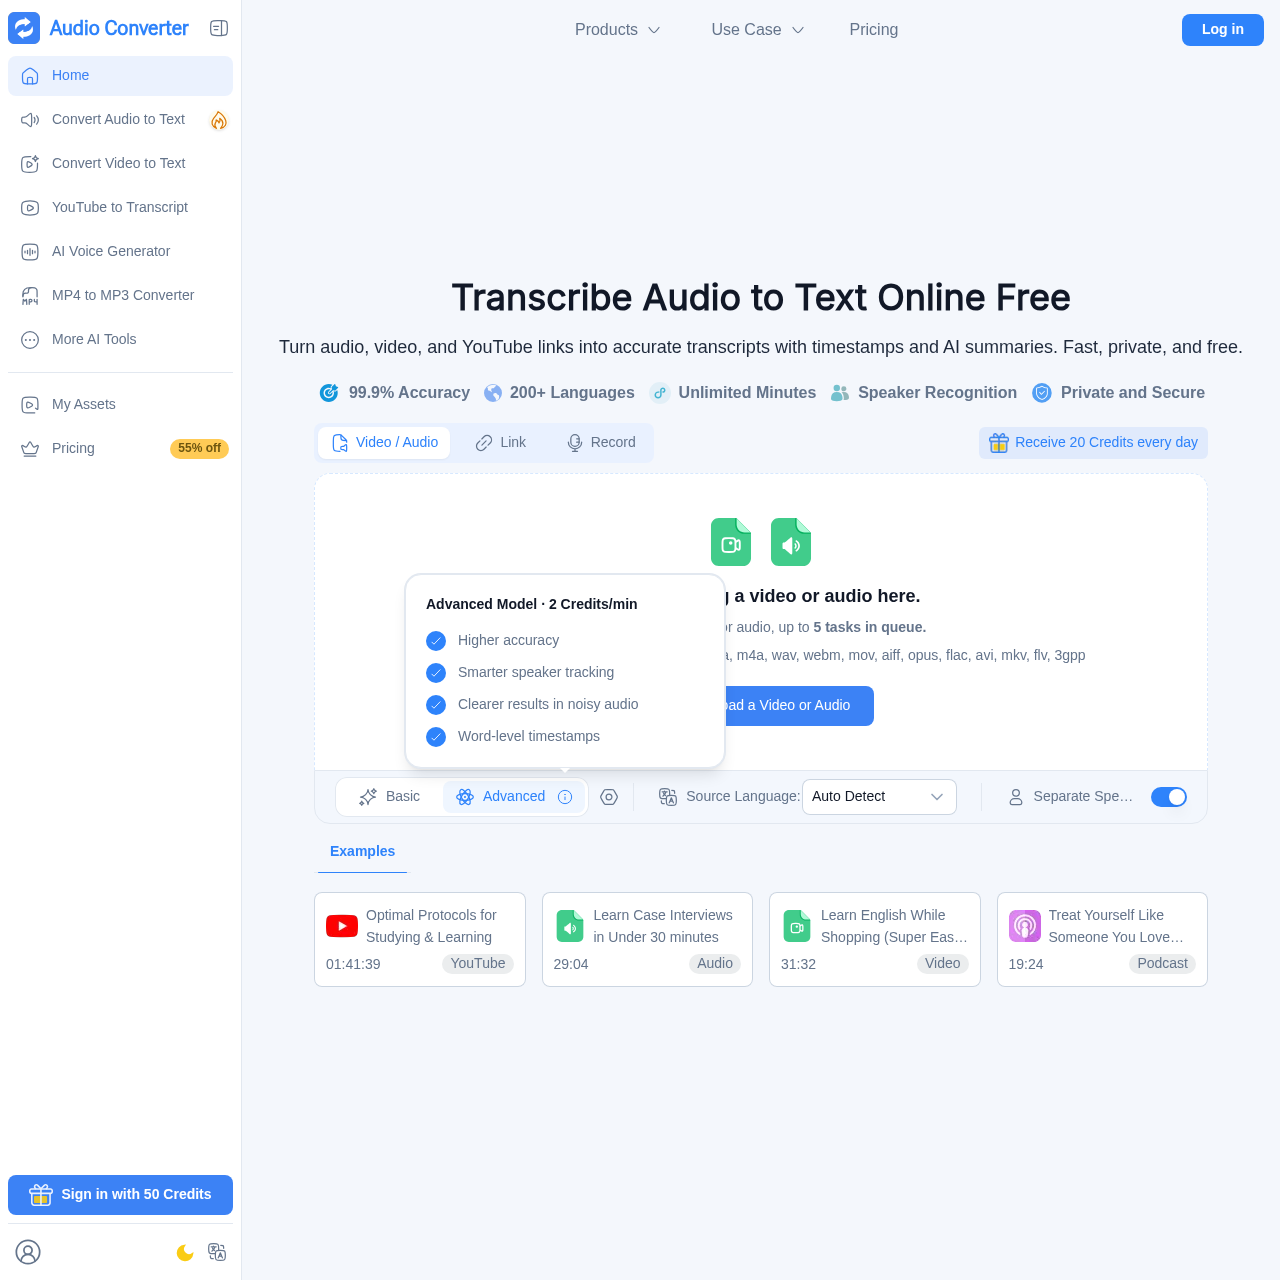
Transcribe Audio to Text 利用 AI 快速且准确地从音频文件、视频、YouTube、TikTok、Instagram、Facebook、X、Bilibili、Google Drive、Dropbox 以及公开可访问的 MP3 或 MP4 链接中将音频转录为文本。它专为需要将口述内容转化为可搜索、可编辑文本的内容创作者、播客主播、学生、教育工作者、记者、研究人员、营销人员以及企业而设计。 Transcribe Audio to Text 支持 200+ 种语言,并可处理高达 10GB 的单个文件,使其适用于从简短语音录音到长播客、采访、讲座、网络研讨会、会议以及大型视频文件的各种内容。说话人识别有助于区分不同的发言者,而时间戳则便于在原始录音中定位特定时刻。 转录文本可用于创建会议记录、摘要、字幕、说明文字、文章、研究资料和社交媒体内容。AI 驱动的摘要总结与批量处理功能也让处理和整理大量录制内容变得更加轻松。 这种转录工作流程的与众不同之处在于其广泛的来源支持和大文件容量。Transcribe Audio to Text 不受小型音频上传的限制,而是可以在一处集中提取并转换来自各大主流社交平台、云存储服务、媒体直链、音频文件以及视频文件的口述内容。
Transcribe Audio to Text 是由 Audio Converter AI 开发的网页端语音转录工具,可将来自音频、视频及直接链接的语音内容转换为可编辑的转录文本。该工具支持涵盖两百多种语言的自动化语言检测。

该服务集成了用于区分不同声音的说话人识别功能,在整个转录文本中生成时间戳,并能自动生成文本摘要。在文件处理方面,该平台采用隔离加密处理机制,并在处理完成后自动清除文件。
有官方来源支持的使用场景
该公司将学术研究与学习列为典型用例,学生可以转录讲座录音,以便查阅可搜索的文本内容、时间戳以及自动生成的摘要。
该公司重点介绍了专业工作流程,用户可将会议、通话及采访记录转换为带有说话人标签和核心要点的共享转录文本。
该转录引擎支持多种输入格式,包括直接上传的音视频文件、网络链接以及麦克风实时录音。用户在将任务排入队列之前,可以选择支持200多种语言的自动语言检测功能,并配置说话人分离设置。
转录生成后,文本会显示带有时间戳的分段语音,方便用户快速定位源媒体中的特定片段。其高级模型还提供字级时间戳和增强型说话人追踪功能,从而在多人发言或嘈杂的录音环境中保持出色的清晰度。
由用户或管理员维护的商业信息
价格可能变化。购买前请到官方网站确认最新套餐和计费条款。
用自己的素材和工作流完成验证
核对了哪些信息以及核对时间
基于已核对产品资料的回答
该平台支持的格式包括 mp3、mp4、mpeg、mpga、m4a、wav、webm、mov、aiff、opus、flac、avi、mkv、flv 和 3gpp,此外还支持直接输入媒体链接和进行实时录音。
上传的每个音频或视频媒体文件最大限制为 3GB,同时系统处理队列的最大容量限制为最多同时处理五个任务。
可以,该工具提供说话人识别功能,能够自动区分不同的发言者,并在生成的转录文本中为他们分配专属标签。
所有文件在传输过程中与静态存储时均进行加密,处理过程均在隔离环境中完成,且在处理流程结束后文件会自动删除。
用户可以直接在平台内部编辑修改转录文本、添加笔记,并对最终生成的完整转录内容进行导出下载或与他人共享。