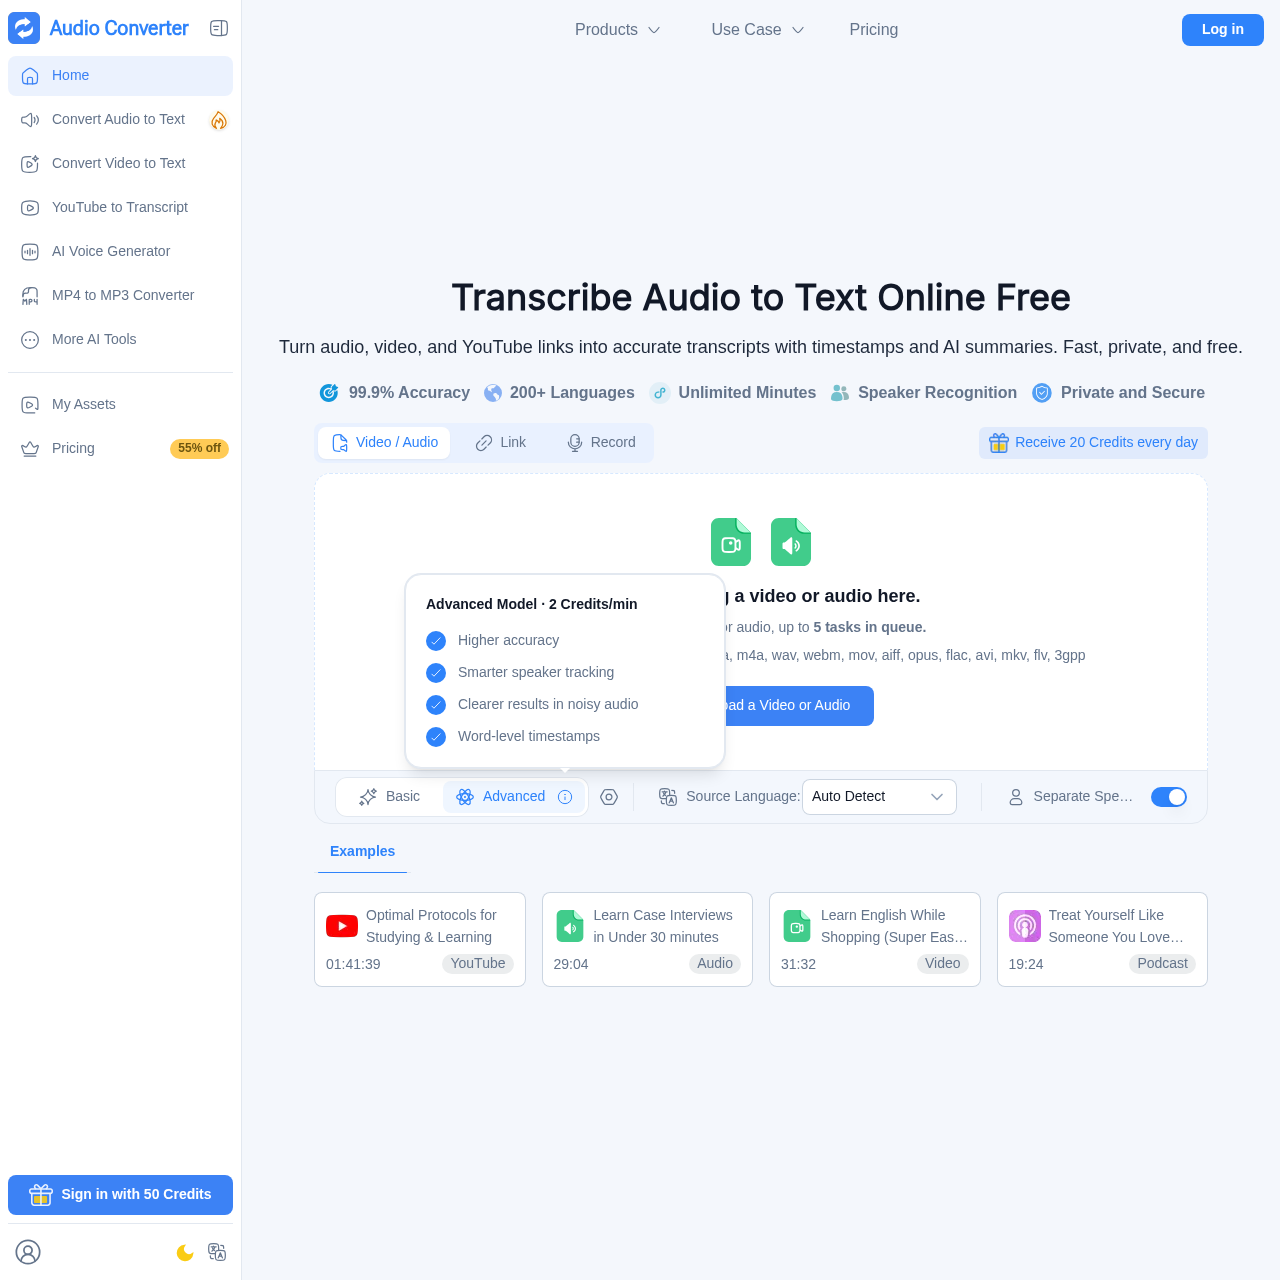
Transcribe Audio to Text permet de transcrire rapidement et avec précision des fichiers audio, des vidéos, YouTube, TikTok, Instagram, Facebook, X, Bilibili, Google Drive, Dropbox et des liens MP3 ou MP4 accessibles au public grâce à l’IA. Il est conçu pour les créateurs de contenu, les podcasteurs, les étudiants, les enseignants, les journalistes, les chercheurs, les spécialistes du marketing et les entreprises qui doivent transformer du contenu parlé en texte interrogeable et modifiable.
Transcribe Audio to Text prend en charge plus de 200 langues et peut traiter des fichiers individuels allant jusqu’à 10GB, ce qui le rend adapté aussi bien aux courts enregistrements vocaux qu’aux podcasts longs, aux interviews, aux cours, aux webinaires, aux réunions et aux fichiers vidéo volumineux. La reconnaissance des locuteurs aide à distinguer les différents intervenants, tandis que les horodatages permettent de localiser facilement des moments précis dans l’enregistrement original.
Les transcriptions peuvent être utilisées pour créer des notes de réunion, des résumés, des sous-titres, des légendes, des articles, des supports de recherche et du contenu pour les réseaux sociaux. La synthèse alimentée par l’IA et le traitement par lots facilitent également le traitement et l’organisation de grandes quantités de contenu enregistré.
Ce qui distingue ce flux de transcription est sa large prise en charge des sources et sa grande capacité en matière de fichiers. Au lieu d’être limité à de petits téléversements audio, Transcribe Audio to Text peut extraire et convertir le contenu parlé depuis les principales plateformes sociales, les services de stockage cloud, les liens multimédias directs, les fichiers audio et les fichiers vidéo en un seul endroit.
Transcribe Audio to Text est un outil de transcription en ligne développé par Audio Converter AI qui convertit les paroles issues de fichiers audio, vidéo et de liens directs en transcriptions modifiables. Il intègre une détection automatique de la langue couvrant plus de deux cents langues.
Le service comprend la reconnaissance des intervenants pour différencier les voix, génère des horodatages tout au long de la transcription et produit des résumés textuels automatisés. La gestion des fichiers inclut un traitement isolé et chiffré ainsi que la suppression automatique des fichiers après traitement.