TheySaid 4.0
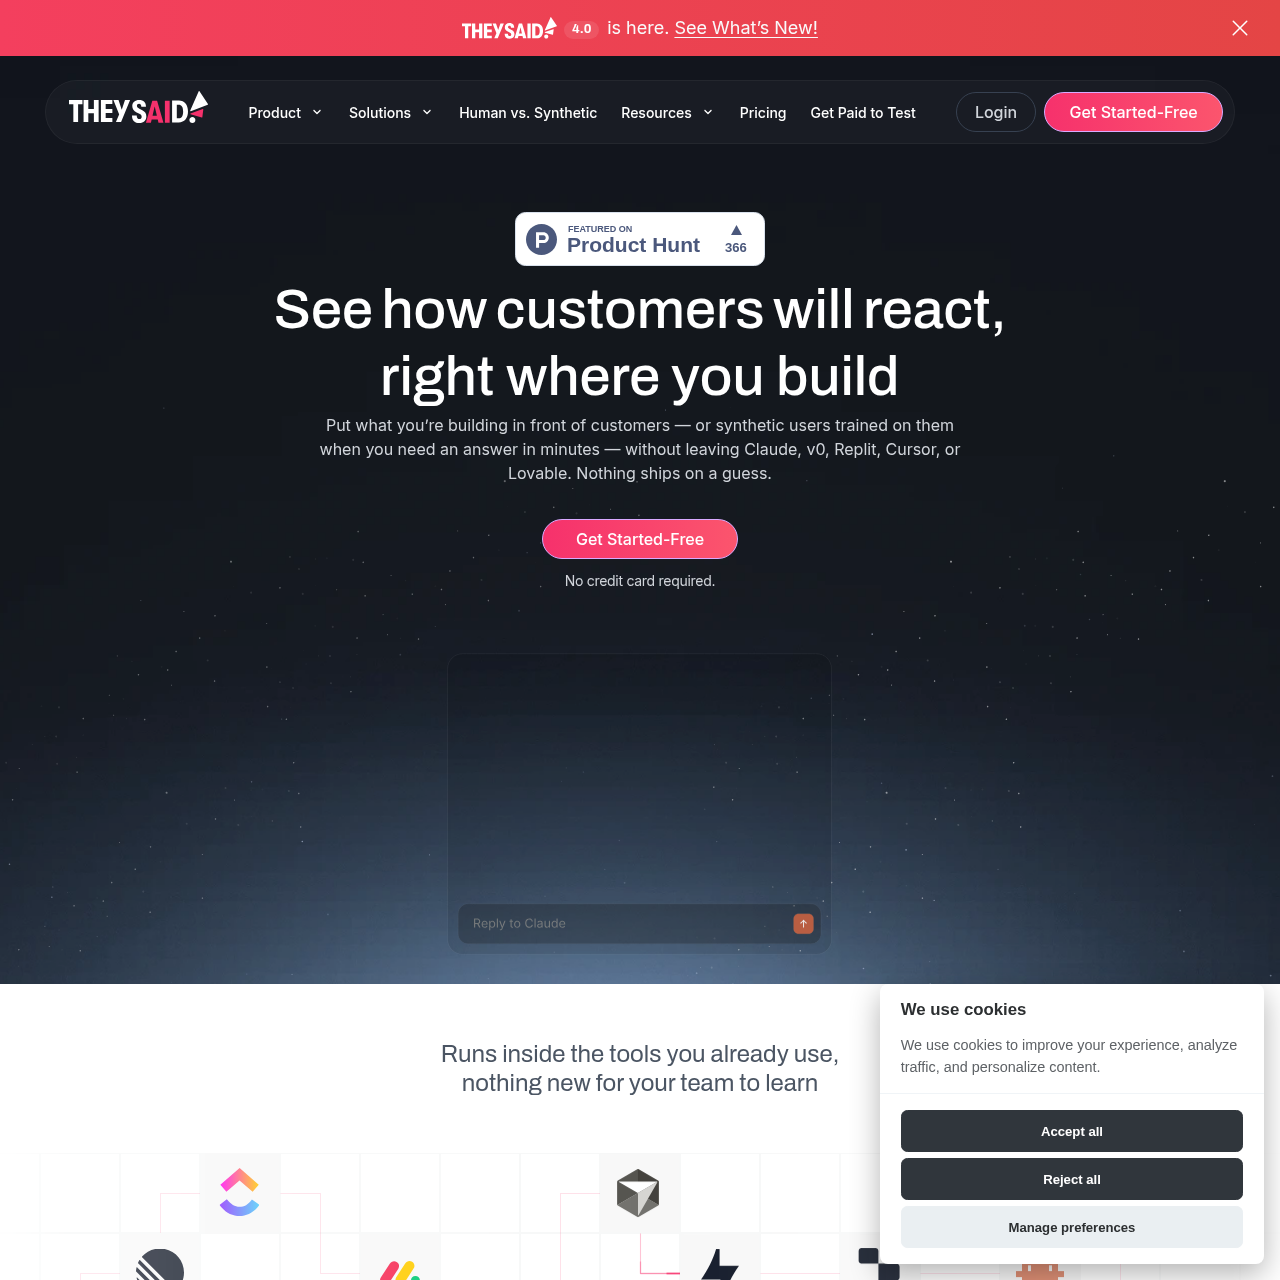
TheySaid 4.0 是一款客户验证平台,它在 Claude、Cursor 和 Jira 等工具中整合了真人测试小组、合成测试员以及 AI 规范评审员,以便在产品正式发布前全面测试产品设计和构建版本。
研究助理利用真人测试小组、自定义合成画像或 AI 专家规范评审员开展可用性测试会话生成可直接粘贴至代码编辑器中的修复提示词,以解决检测到的 UX 缺陷转录并添加时间戳,剪辑参与者出现犹豫、困惑及流失的关键时刻利用客户数据或预设的行业受众画像对合成测试员进行微调
TheySaid 4.0 是一款客户验证平台,它在 Claude、Cursor 和 Jira 等工具中整合了真人测试小组、合成测试员以及 AI 规范评审员,以便在产品正式发布前全面测试产品设计和构建版本。
产品用途与官方定位
TheySaid 4.0 将用户研究与验证直接集成到开发和设计工作流中。通过连接至 Claude、Cursor、Replit、Lovable、Bolt 和 Jira 等环境,该系统使团队无需在独立的测试应用程序之间来回切换,即可针对概念设计和运行代码收集反馈。
该平台支持三种不同形式的验证证据:真人测试小组(包括企业自有的客户群体或外部招募的测试人员)、基于公司内部记录校准的合成画像,以及对照技术规范检查构建版本的 AI 专家评审员。
有官方来源支持的使用场景
产品团队对 Jira 进行配置,使工单状态变更为“设计完成”时能够自动触发可用性测试,并将录制的测试会话及逐字稿直接关联至该工单。
工程团队针对功能构建版本运行 AI 专家评审员和合成测试参与者,在合并拉取请求之前及时发现界面缺陷与规范偏差。
官方客户案例报告显示,ClickUp 使用 TheySaid AI 问卷调查来收集客户反馈并获取用户参与度洞察。
官网提供的使用流程
体验中心持续汇聚并评估反馈,将验证证据直接附加到产品待办列表的工单中。
团队可直接在设计环境中运行合成受众与 AI 专家评审员,对早期产品概念方案展开深入评审。
在代码更改合并到代码仓库之前,平台会根据书面产品规范对功能构建版本进行全面测试。
在产品发布后,系统会跨整个客户旅程对关键体验进行评估和打分,以验证产品持续的实际表现。
TheySaid 合成测试员基于一个经过超过 100,000 小时真人可用性测试会话训练的基础模型。这些合成智能体能够模拟真实用户的行为特征,包括阅读习惯、导航犹豫、操作困惑以及流失倾向。
团队可以利用第一方客户信息对这些合成画像进行微调,例如通话录音、问卷答复、CRM 数据和客户支持工单。如果尚未具备内部客户数据,团队也可以选用预设的细分市场受众画像,并在后续逐步完善优化。
为建立测试可靠性,平台在匹配的界面上将合成测试发现与真人测试小组的结果进行对照评估。在跨多项研究的对比测试中,合成测试员发现了全部问题的 89%,真人测试员发现了 90%,而两组测试人员共同识别出了 79% 的问题。
用自己的素材和工作流完成验证
核对了哪些信息以及核对时间
基于已核对产品资料的回答
根据已发布的对比研究数据,合成测试员发现了全部问题中的 89%,而真人测试员发现了 90%。两组测试人员共同识别出了 79% 的问题,仅由合成用户发现的问题占 10%,而仅由真人测试员发现的问题占 11%。
TheySaid 4.0 提供了可在 Claude Design、Claude Code、Cursor、Replit、Bolt 和 Lovable 内运行的模型上下文协议集成,并支持在 Jira 内部自动触发验证工作流。
合成测试员始于一个经过超过 100,000 小时可用性会话训练的基础模型。企业可以使用自有的 CRM 数据、客户通话录音、支持工单和问卷调查对其进行训练微调,也可以直接从预设的受众画像模板开始使用。
统一测试构建器支持可用性测试、AI 主导的问卷调查、互动式访谈、表单和投票,具备条件逻辑、语音对话功能,并支持超过 70 种语言的本地化翻译。
当 Jira 中的工单进入“设计完成”(Design Done)阶段时,平台会自动启动验证测试,记录带有时间戳的会话发现,将证据直接附加至工单,并生成适用于代码编辑器的修复提示词。