Cekura Bench
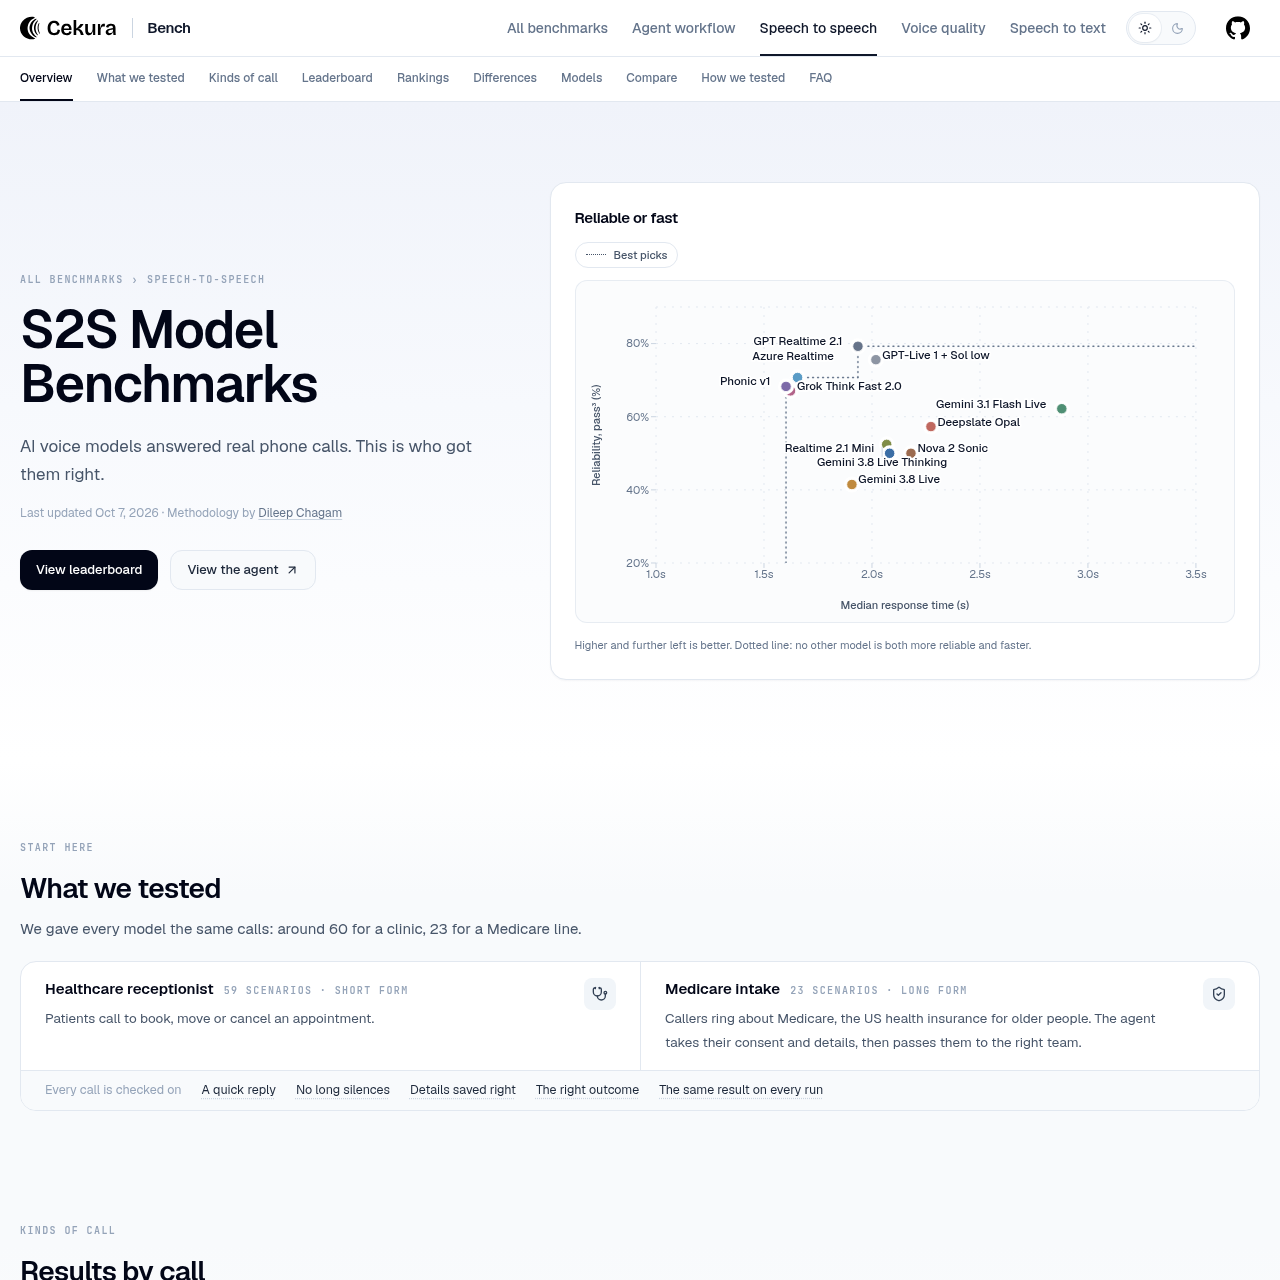
Cekura Bench 是一个开放的基准测试平台,旨在通过涵盖诊所预约排期和联邦医疗保险资格审核的82个模拟电话通话场景,全面评估实时语音到语音 AI 模型的实际表现与可靠性。
研究助理评估原生端到端语音模型,并与未排名的级联参考基准进行对照比较查看包含完整对话转录文本、工具调用记录和评分的公开通话报告测量包括响应延迟、10秒静音及结构化字段提取在内的运行指标标准化语音评估套件
Cekura Bench 是一个开放的基准测试平台,旨在通过涵盖诊所预约排期和联邦医疗保险资格审核的82个模拟电话通话场景,全面评估实时语音到语音 AI 模型的实际表现与可靠性。
产品用途与官方定位
Cekura Bench 是一个基准评估平台,采用标准化的电话通话场景来测试实时语音到语音模型,从而精准测量模型的对话可靠性、响应延迟以及数据准确率。
该平台基于开源 Pipecat 智能体框架,在82个不同场景下对每个模型分别执行三次测试,并公开发布完整的通话转录文本、工具执行记录以及多维度性能指标。
有官方来源支持的使用场景
开发团队在落地语音智能体之前,对比评估各实时语音模型在对话一致性、响应时间及数据准确率方面的综合表现。
开发者将原生端到端语音模型与由语音转文字、大语言模型和语音合成组成的标准级联处理流程进行横向对比与性能评估。
该基准测试通过在统一的开源 Pipecat 语音智能体框架中运行每个语音到语音模型,从而标准化测试环境。提示词、集成工具和网络连接在各轮测试中均保持一致,确保模型性能成为唯一的测试变量。测试还纳入了一个结合 Flux、GPT-4.1 和 ElevenLabs Flash 的未排名级联基准线,以此作为系统架构层面的参考对照。
评估涵盖诊所预约处理和联邦医疗保险资格审核两大类别的82个测试场景,且每个场景均执行三次实时通话测试,总计进行了2,952次通话。只有当智能体达成指定业务目标并正确保存所有预期数据字段时,该通话才被判定为通过,系统通过在每次测试运行中均取得成功的场景比例来衡量稳定性与一致性。
用自己的素材和工作流完成验证
核对了哪些信息以及核对时间
基于已核对产品资料的回答
该基准测试共涵盖两个套件中的82个场景:一是包含59个场景的诊所接待套件,用于测试预约挂号流程;二是包含23个场景的联邦医疗保险接收套件,涵盖知情同意、资格初审与通话转接。
可靠性采用立方通过率(pass-cubed)指标进行量化评估,该指标专门计算在连续三次独立实时通话运行中均顺利通过测试的场景所占的百分比。
所有受测模型均在相同的开源 Pipecat 智能体配置下运行,采用完全相同的提示词、工具定义和网络连接设置,从而确保模型性能成为唯一的评估变量。
是的,评测体系中包含了一个未排名的级联参考基准,该基准组合了用于语音识别的 Flux、负责推理的 GPT-4.1 以及用于语音合成的 ElevenLabs Flash,为性能对比提供参考背景。
每个模型的评测条目均直接关联至 Cekura 报告页面,其中包含完整的对话转录记录、工具调用执行详情及最终评测得分,方便公众进行独立验证与复核。