Cekura Bench
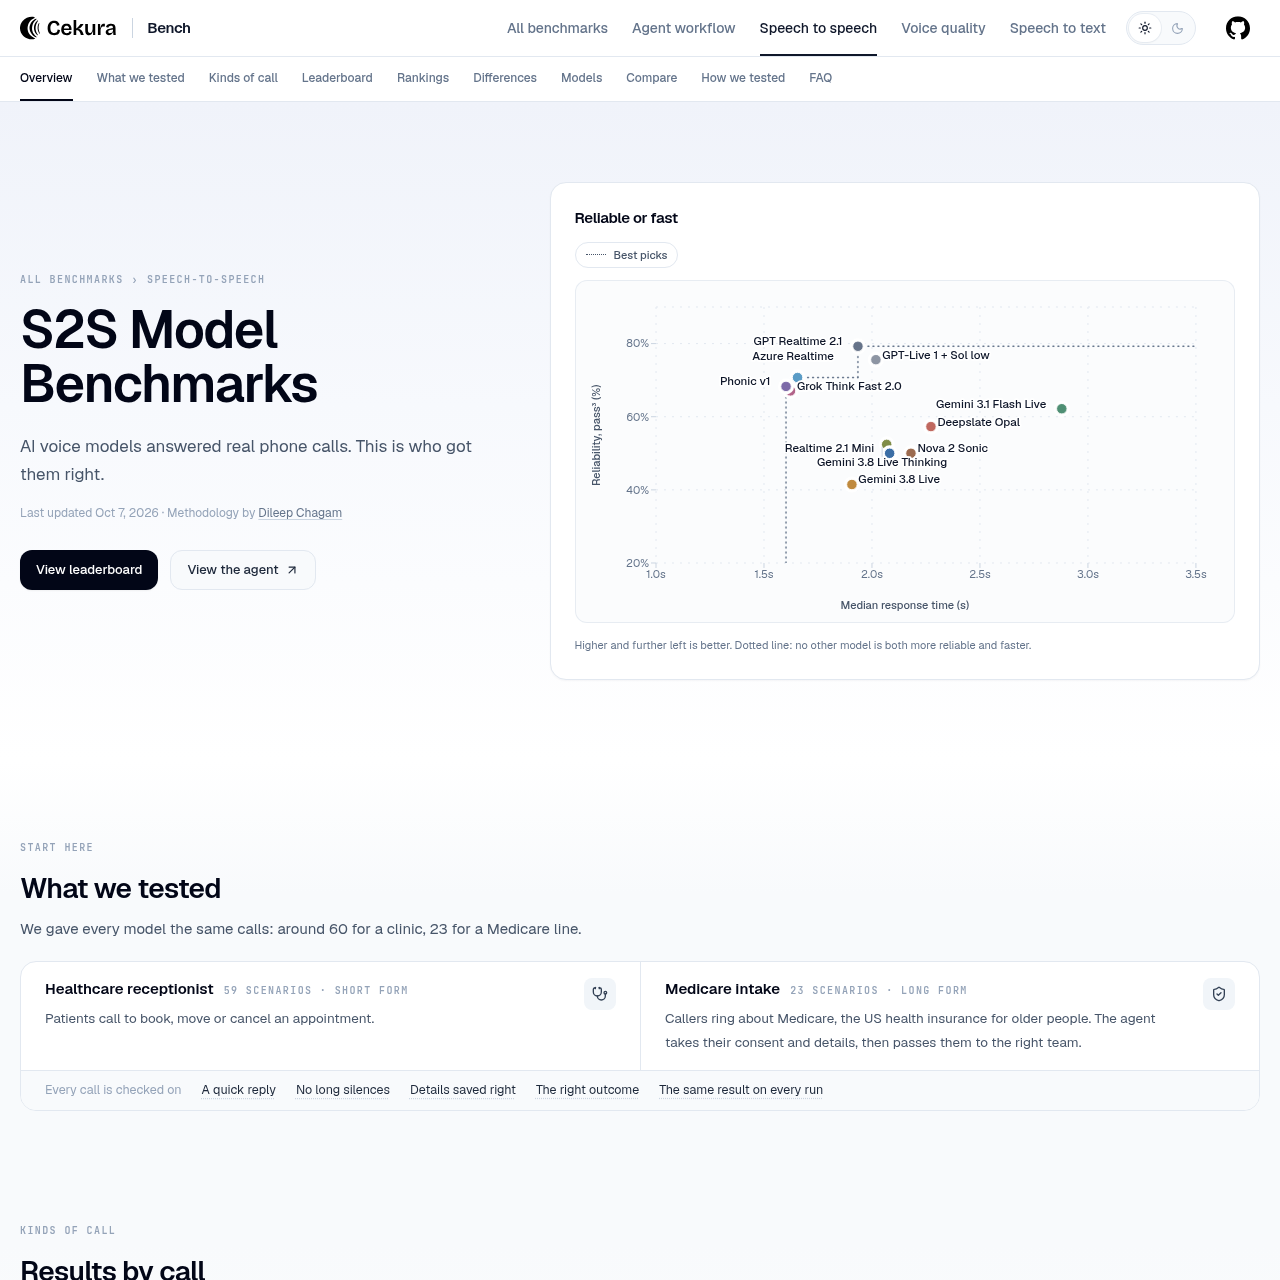
Cekura Bench는 병원 진료 예약 및 메디케어 접수 분야의 82가지 모의 전화 통화 시나리오를 통해 실시간 음성 대 음성 AI 모델을 평가하는 오픈 벤치마크입니다.
연구 보조Flux, GPT-4.1, ElevenLabs Flash 등을 결합한…전체 대화 트랜스크립트, 도구 호출 기록, 점수 결과를 포함하는 공개…응답 지연 시간, 10초 이상 침묵, 구조화된 데이터 필드 추출을…표준화된 음성 평가 스위트
Cekura Bench는 병원 진료 예약 및 메디케어 접수 분야의 82가지 모의 전화 통화 시나리오를 통해 실시간 음성 대 음성 AI 모델을 평가하는 오픈 벤치마크입니다.
제품의 기능과 공식 포지셔닝
Cekura Bench는 표준화된 전화 통화 시나리오를 활용하여 실시간 음성 대 음성(Speech-to-Speech) 모델의 대화 신뢰성, 지연 시간, 데이터 정확도를 측정하는 벤치마크 플랫폼입니다.
오픈소스 Pipecat 에이전트 프레임워크를 기반으로 각 모델을 82개의 고유 시나리오에서 3회씩 테스트하며, 전체 통화 트랜스크립트, 도구 실행 기록, 성능 지표를 투명하게 공개합니다.
공식 출처로 확인된 활용 사례
음성 에이전트를 도입하기 전에 실시간 음성 모델의 일관성, 응답 속도, 데이터 처리 정확도를 비교 분석합니다.
네이티브 음성 대 음성 모델과 음성 인식, 언어 모델, 음성 합성으로 이어지는 표준 캐스케이드 파이프라인을 비교 평가합니다.
이 벤치마크는 동일한 오픈소스 Pipecat 음성 에이전트 프레임워크를 통해 각 음성 대 음성 모델을 구동하여 테스트 환경을 표준화합니다. 실행 과정 전반에 걸쳐 프롬프트, 연동 도구 및 연결 설정이 동일하게 유지되므로 모델 자체의 성능만이 유일한 시험 변수로 격리됩니다. 아키텍처 참조를 위해 Flux, GPT-4.1, ElevenLabs Flash를 결합한 비순위 캐스케이드 베이스라인도 함께 제공됩니다.
평가는 병원 진료 예약 관리 및 메디케어 자격 심사에 걸쳐 세 차례의 실시간 테스트로 수행되는 82개 시나리오로 이루어지며 총 2,952회의 통화가 진행됩니다. 통화 평가는 에이전트가 요구된 결과를 달성하고 예상된 모든 데이터 필드를 올바르게 저장해야만 통과되며, 신뢰성은 모든 실행에서 성공한 시나리오 비율로 측정됩니다.
본인의 자료와 작업 흐름으로 직접 확인할 항목
확인한 출처와 확인 시점
출처를 확인한 제품 정보를 바탕으로 한 답변
이 벤치마크는 진료 예약을 처리하는 59개 시나리오의 병원 접수 스위트와 동의 획득, 자격 확인, 인계를 다루는 23개 시나리오의 메디케어 접수 스위트 등 총 82개 시나리오를 평가합니다.
신뢰성은 Pass-Cubed 지표를 사용하여 측정되며, 세 차례 연속으로 진행된 실시간 통화 실행 전체에서 성공적으로 통과한 시나리오의 백분율을 기준으로 산출됩니다.
모델 자체의 성능 차이만을 정확하게 격리하기 위해 모든 모델은 동일한 프롬프트, 도구 정의, 연결 설정을 갖춘 오픈소스 Pipecat 에이전트 환경에서 실행됩니다.
네, 음성 인식용 Flux, 추론용 GPT-4.1, 음성 합성용 ElevenLabs Flash를 결합한 비순위 참조용 캐스케이드 파이프라인을 포함하여 아키텍처 간 비교 분석을 지원합니다.
각 모델 항목은 Cekura 보고서로 직접 연결되어 검증에 필요한 전체 대화 트랜스크립트, 도구 실행 세부 내역, 최종 결과 점수 등을 직접 열람할 수 있습니다.