Cekura Bench
Cekura Benchは、診療所の予約やメディケア受付にわたる82件の模擬通話シナリオを通じて、リアルタイム音声対音声AIモデルを評価するオープンベンチマークです。
研究アシスタント順位付けのないカスケード型リファレンスベースラインとネイティブ音声対音声モデルの比…完全な会話の文字起こし、ツール呼び出し記録、スコアを含む公開通話レポートの確認応答レイテンシ、10秒間の無音、構造化フィールドの抽出などの運用指標の測定標準化された音声評価スイート
Cekura Benchは、診療所の予約やメディケア受付にわたる82件の模擬通話シナリオを通じて、リアルタイム音声対音声AIモデルを評価するオープンベンチマークです。
製品の機能と公式な位置づけ
Cekura Benchは、標準化された通話シナリオを用いてリアルタイム音声対音声モデルを評価し、会話の信頼性、レイテンシ、データ精度を測定するベンチマークです。
このプラットフォームは、オープンソースのPipecatエージェントフレームワークを用いて82の異なるシナリオでモデルを各3回テストし、通話の全文文字起こし、ツール実行記録、パフォーマンス指標を公開しています。
公式情報で確認できる活用例
チームは音声エージェントの実装前に、一貫性、応答時間、データ精度に関してリアルタイム音声モデルを比較できます。
開発者は、ネイティブ音声対音声モデルを、音声認識・言語モデル・音声合成で構成される標準的なカスケード型パイプラインと比較評価できます。
本ベンチマークは、各音声対音声モデルを同一のオープンソースPipecat音声エージェントフレームワーク上で実行することにより、テスト条件を標準化しています。プロンプト、連携ツール、接続設定はすべての実行で共通に保たれ、モデルの性能のみをテスト対象の単一変数として分離します。また、Flux、GPT-4.1、ElevenLabs Flashを組み合わせた順位付けのないカスケードベースラインが、アーキテクチャ上のリファレンスとして機能します。
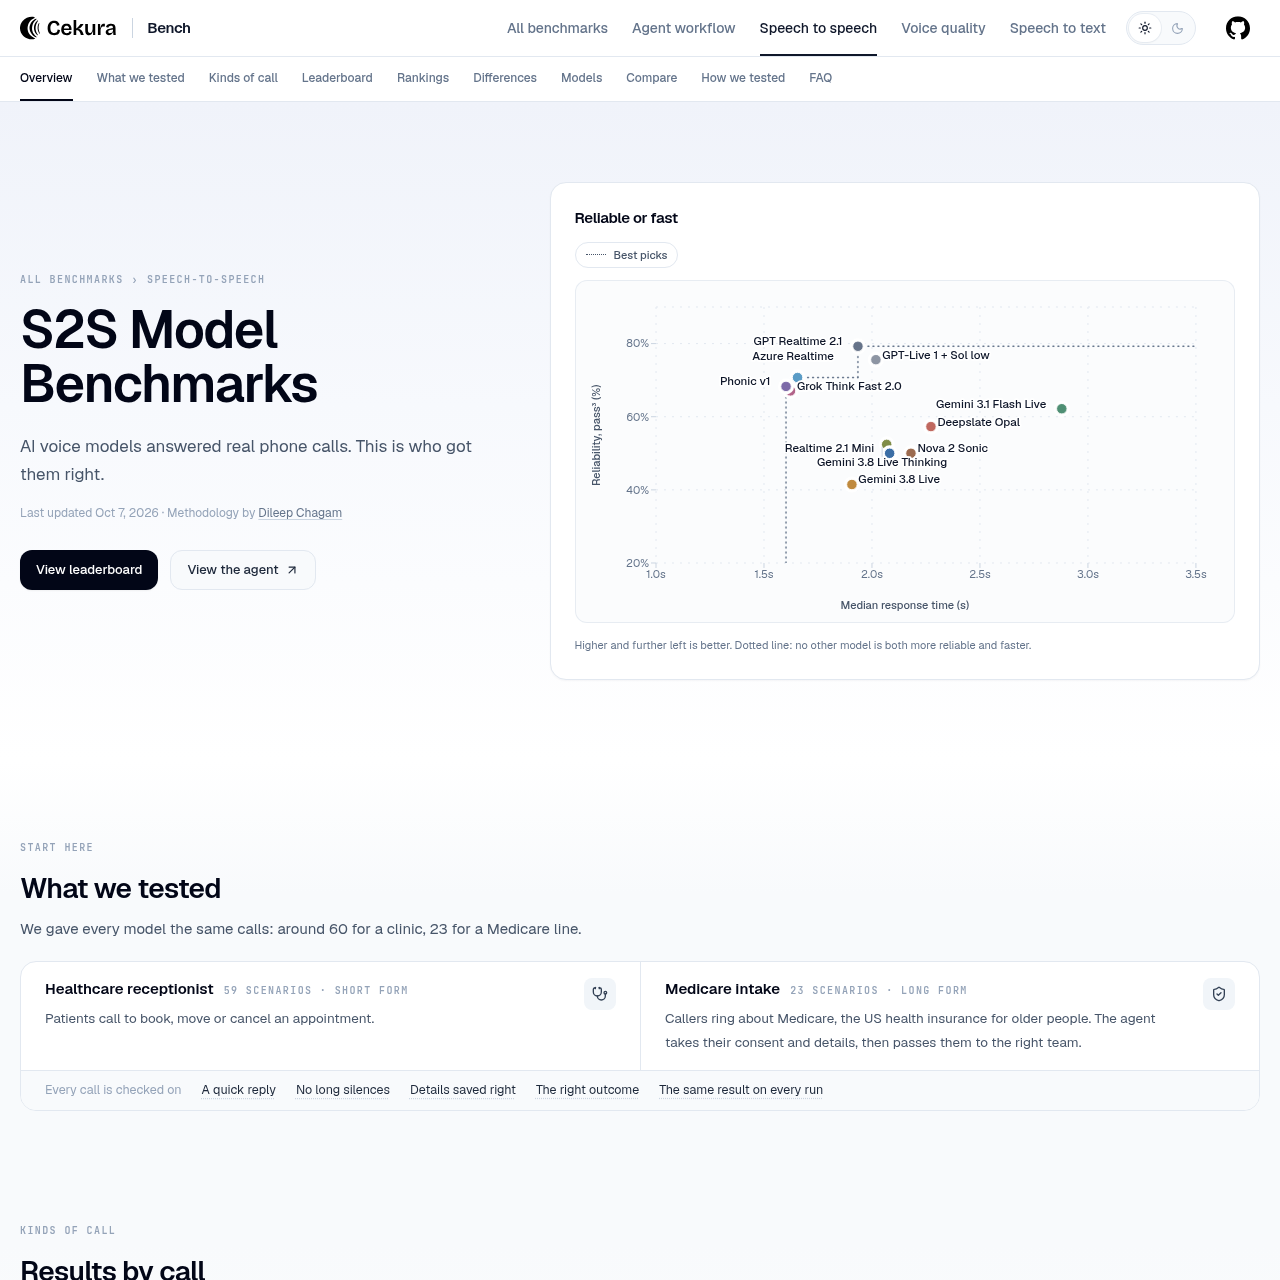
評価は診療所の予約対応およびメディケア資格確認を対象とした3回のライブ実行にわたる82のテストシナリオで構成され、通話数は合計2,952件に及びます。エージェントが必要な成果を達成し、期待されるすべてのデータフィールドを正確に保存した場合にのみ通話は合格と判定され、一貫性はすべての実行で成功したシナリオの割合によって測定されます。
自分の素材とワークフローで確認したい項目
確認した情報源とその日時
情報源を確認した製品情報に基づく回答
このベンチマークでは2つのスイートにわたる82のシナリオを評価します。予約受付を扱う59シナリオの診療所受付スイートと、同意、資格判定、ルーティングを網羅する23シナリオのメディケア受付スイートです。
信頼性はPass-Cubed指標を用いて測定され、3回連続のライブ通話実行すべてに成功したシナリオの割合を計算することで算出されます。
モデル本来の性能を分離して評価するため、すべてのモデルは同一のプロンプト、ツール定義、接続設定を備えた同じオープンソースのPipecatエージェント構成で動作します。
はい。音声認識にFlux、推論にGPT-4.1、音声合成にElevenLabs Flashを組み合わせた順位付けのないリファレンスカスケードが含まれており、比較の参考として利用できます。
各モデルのエントリからCekuraのレポートへ直接リンクされており、検証のために完全な文字起こし、ツールの実行ログ、結果スコアを確認することができます。