Cekura Bench
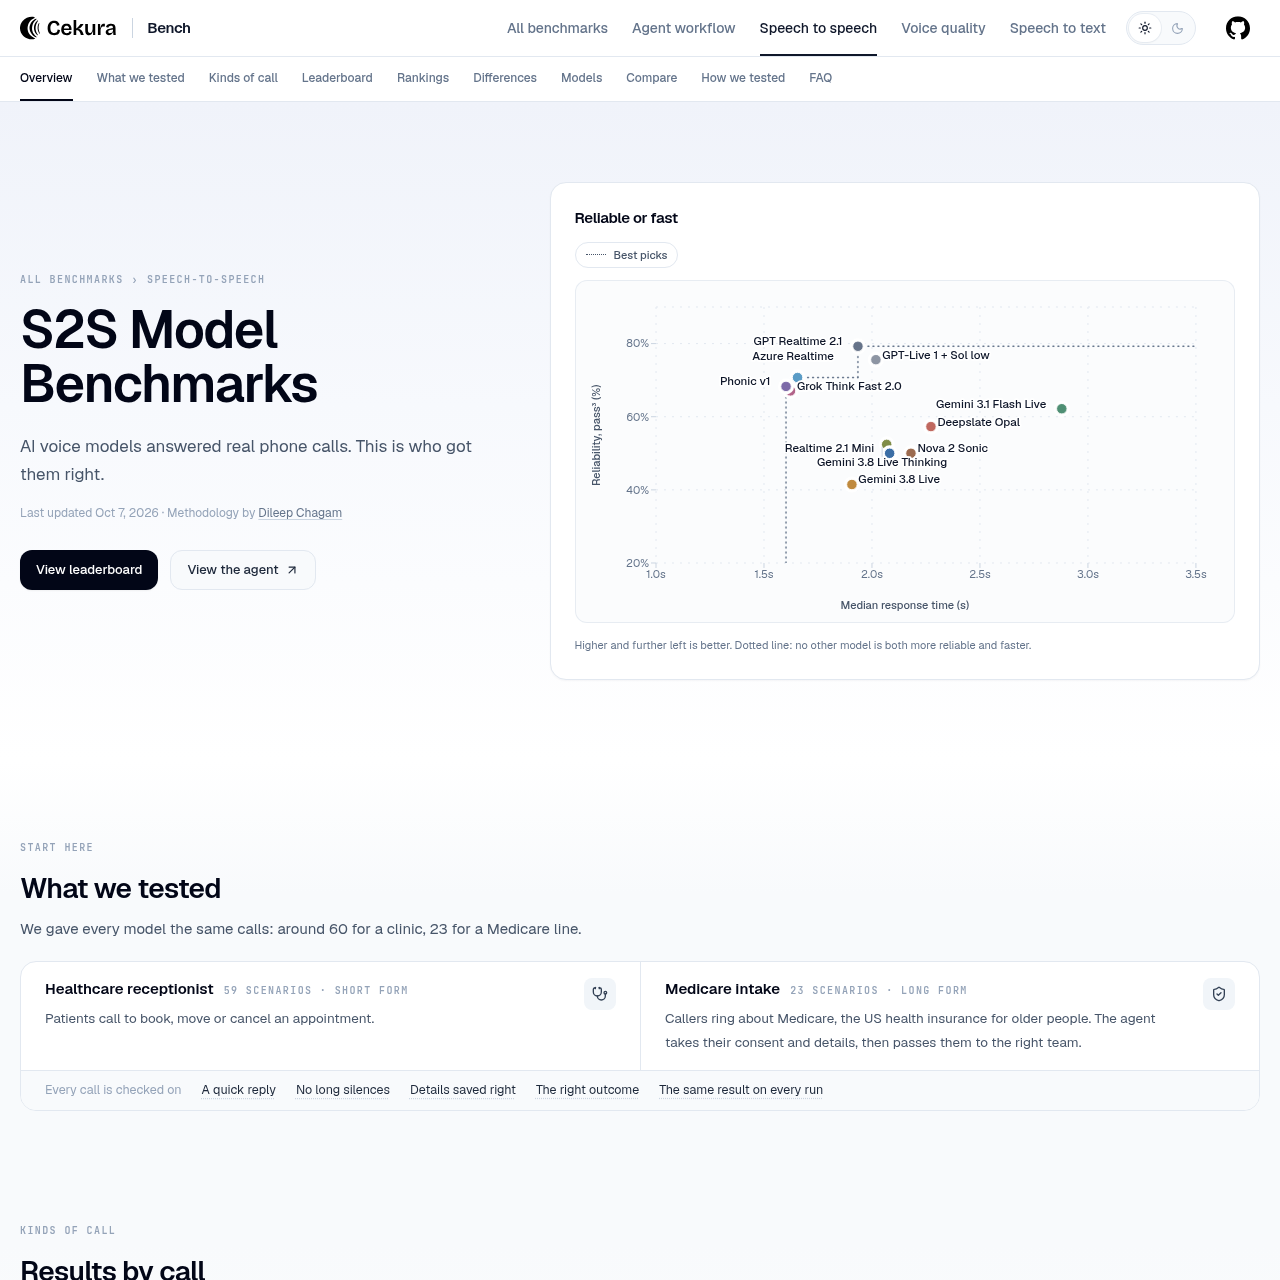
Cekura Bench bietet einen offenen Benchmark zur Evaluierung von Echtzeit-Speech-to-Speech-KI-Modellen anhand von 82 simulierten Telefonszenarien aus den Bereichen Praxis-Terminvergabe und Medicare-Aufnahme.
Funktion und offizielle Positionierung des Produkts
Cekura Bench ist ein Benchmark, der Speech-to-Speech-Echtzeit-Sprachmodelle mithilfe standardisierter Telefonszenarien evaluiert, um Gesprächszuverlässigkeit, Latenz und Datengenauigkeit zu messen.
Die Plattform testet Modelle in 82 verschiedenen Szenarien jeweils dreimal über ein quelloffenes Pipecat-Agenten-Framework und veröffentlicht vollständige Anruftranskripte, Tool-Ausführungsprotokolle sowie Leistungsmetriken.
Durch offizielle Quellen belegte Anwendungsfälle
Teams vergleichen Echtzeit-Sprachmodelle hinsichtlich Konsistenz, Antwortzeiten und Datengenauigkeit vor dem Produktiveinsatz von Voice Agents.
Entwickler vergleichen native Speech-to-Speech-Modelle mit einer standardmäßigen Kaskaden-Pipeline aus Speech-to-Text, Sprachmodell und Sprachsynthese.
Der Benchmark standardisiert die Testbedingungen, indem jedes Speech-to-Speech-Modell über dasselbe quelloffene Pipecat-Voice-Agent-Framework ausgeführt wird. Prompts, Integrations-Tools und Verbindungen bleiben über alle Durchläufe hinweg identisch, sodass die Modellleistung als einzige Testvariable isoliert wird. Eine ungerankte Kaskaden-Baseline aus Flux, GPT-4.1 und ElevenLabs Flash dient als architektonische Referenz.
Die Evaluierung umfasst 82 Testszenarien, die in drei Live-Durchläufen durchgeführt werden, was insgesamt 2.952 Anrufe in den Bereichen Praxis-Terminvereinbarung und Medicare-Qualifizierung ergibt. Ein Anruf gilt nur dann als bestanden, wenn der Agent das geforderte Ergebnis erzielt und alle erwarteten Datenfelder korrekt speichert, wobei die Konsistenz am Anteil der Szenarien gemessen wird, die in jedem Durchlauf erfolgreich sind.
Prüfungen mit eigenen Inhalten und Arbeitsabläufen
Welche Quellen wann geprüft wurden
Antworten auf Basis des quellengeprüften Produkteintrags
Der Benchmark bewertet 82 Szenarien in zwei Suiten: eine Praxis-Empfangssuite mit 59 Szenarien für Terminbuchungen sowie eine Medicare-Aufnahmesuite mit 23 Szenarien zu Einwilligung, Qualifizierung und Weiterleitung.
Die Zuverlässigkeit wird anhand einer Pass-Cubed-Metrik gemessen, die den Prozentsatz der Szenarien ermittelt, die in drei aufeinanderfolgenden Live-Anrufdurchläufen erfolgreich bestanden werden.
Alle Modelle verwenden dieselbe Open-Source-Pipecat-Agentenkonfiguration mit identischen Prompts, Tool-Definitionen und Verbindungseinstellungen, um die reine Modellleistung zu isolieren.
Ja, eine ungerankte Referenz-Kaskade bestehend aus Flux für Speech-to-Text, GPT-4.1 für logische Verarbeitung und ElevenLabs Flash für Text-to-Speech ist zum vergleichenden Kontext enthalten.
Jeder Modelleintrag verweist direkt auf Cekura-Berichte, die vollständige Transkripte, Tool-Aufrufausführungen und Ergebnisbewertungen zur Verifizierung enthalten.