Cekura Bench
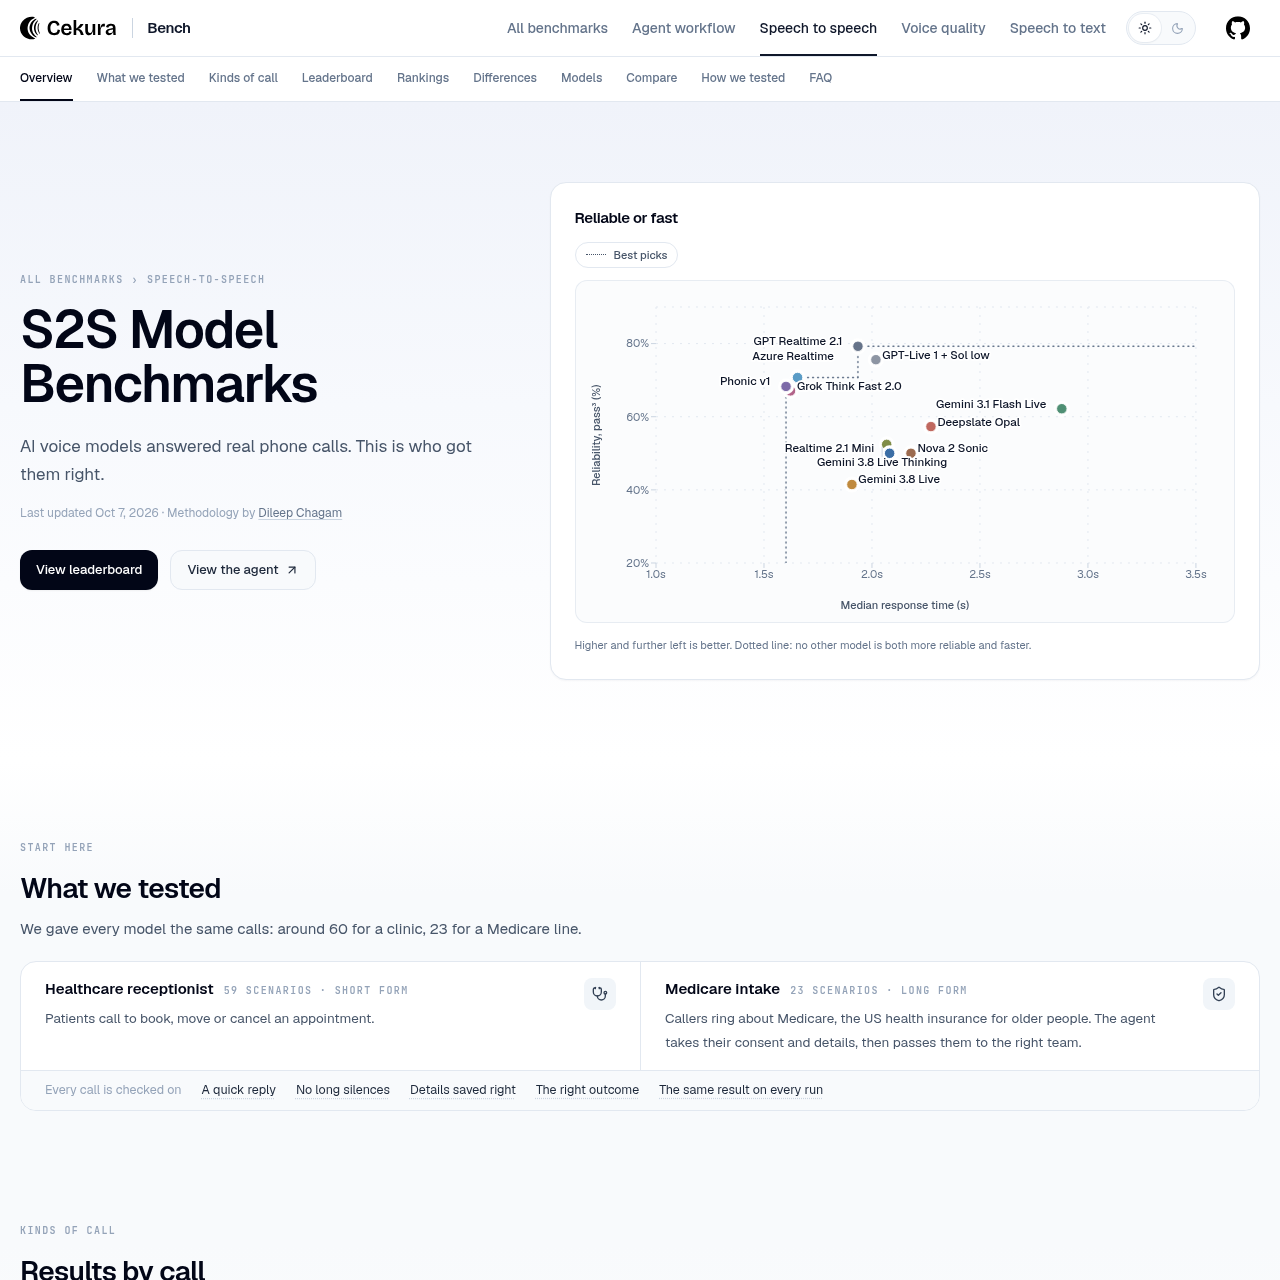
Cekura Bench предоставляет открытый бенчмарк для оценки ИИ-моделей realtime speech-to-speech в 82 симулированных телефонных сценариях записи к врачу и первичного приема Medicare.
Назначение продукта и его официальное позиционирование
Cekura Bench — это бенчмарк для оценки голосовых моделей realtime speech-to-speech с помощью стандартизированных телефонных звонков для измерения надежности диалога, задержки и точности данных.
Платформа тестирует модели в 82 различных сценариях по три раза для каждого с использованием открытого фреймворка агентов Pipecat, публикуя полные транскрипции звонков, журналы вызовов инструментов и метрики производительности.
Сценарии, подтверждённые официальными источниками
Команды сравнивают модели реального времени по стабильности, времени отклика и точности данных перед внедрением голосовых агентов.
Разработчики оценивают нативные модели speech-to-speech относительно стандартного каскадного пайплайна из распознавания речи, языковой модели и синтеза речи.
Бенчмарк стандартизирует условия тестирования, запуская каждую модель speech-to-speech через один и тот же открытый фреймворк голосовых агентов Pipecat. Промпты, инструменты интеграции и сетевые подключения остаются одинаковыми во всех прогонах, что изолирует производительность модели как единственную проверяемую переменную. Каскадный эталон вне общего рейтинга, объединяющий Flux, GPT-4.1 и ElevenLabs Flash, выступает в качестве архитектурного ориентира.
Оценка охватывает 82 тестовых сценария, выполняемых в трех живых прогонах, что в сумме составляет 2952 звонка в рамках записи на прием в клинику и квалификации Medicare. Звонок считается успешно пройденным только тогда, когда агент достигает требуемого результата и корректно сохраняет все ожидаемые поля данных, при этом стабильность измеряется долей сценариев, успешно завершившихся во всех прогонах.
Проверки на собственных материалах и рабочих процессах
Какие источники и когда были проверены
Ответы на основе карточки продукта с проверенными источниками
Бенчмарк оценивает 82 сценария в двух наборах: 59 сценариев администратора клиники для записи на прием и 23 сценария первичного приема Medicare, охватывающих согласие, квалификацию и маршрутизацию.
Надежность измеряется с помощью метрики pass-cubed, которая вычисляет процент сценариев, успешно пройденных в трех последовательных прогонах живых звонков.
Все модели работают с одинаковой конфигурацией агента Pipecat с открытым исходным кодом, идентичными промптами, описаниями инструментов и сетевыми настройками для изоляции производительности моделей.
Да, для сравнительного контекста включен эталонный каскадный пайплайн вне рейтинга, объединяющий Flux для распознавания речи, GPT-4.1 для рассуждений и ElevenLabs Flash для синтеза речи.
Каждая модель содержит прямую ссылку на отчеты Cekura с полными транскрипциями, выполнением вызовов инструментов и оценками результатов для верификации.