Cekura Bench
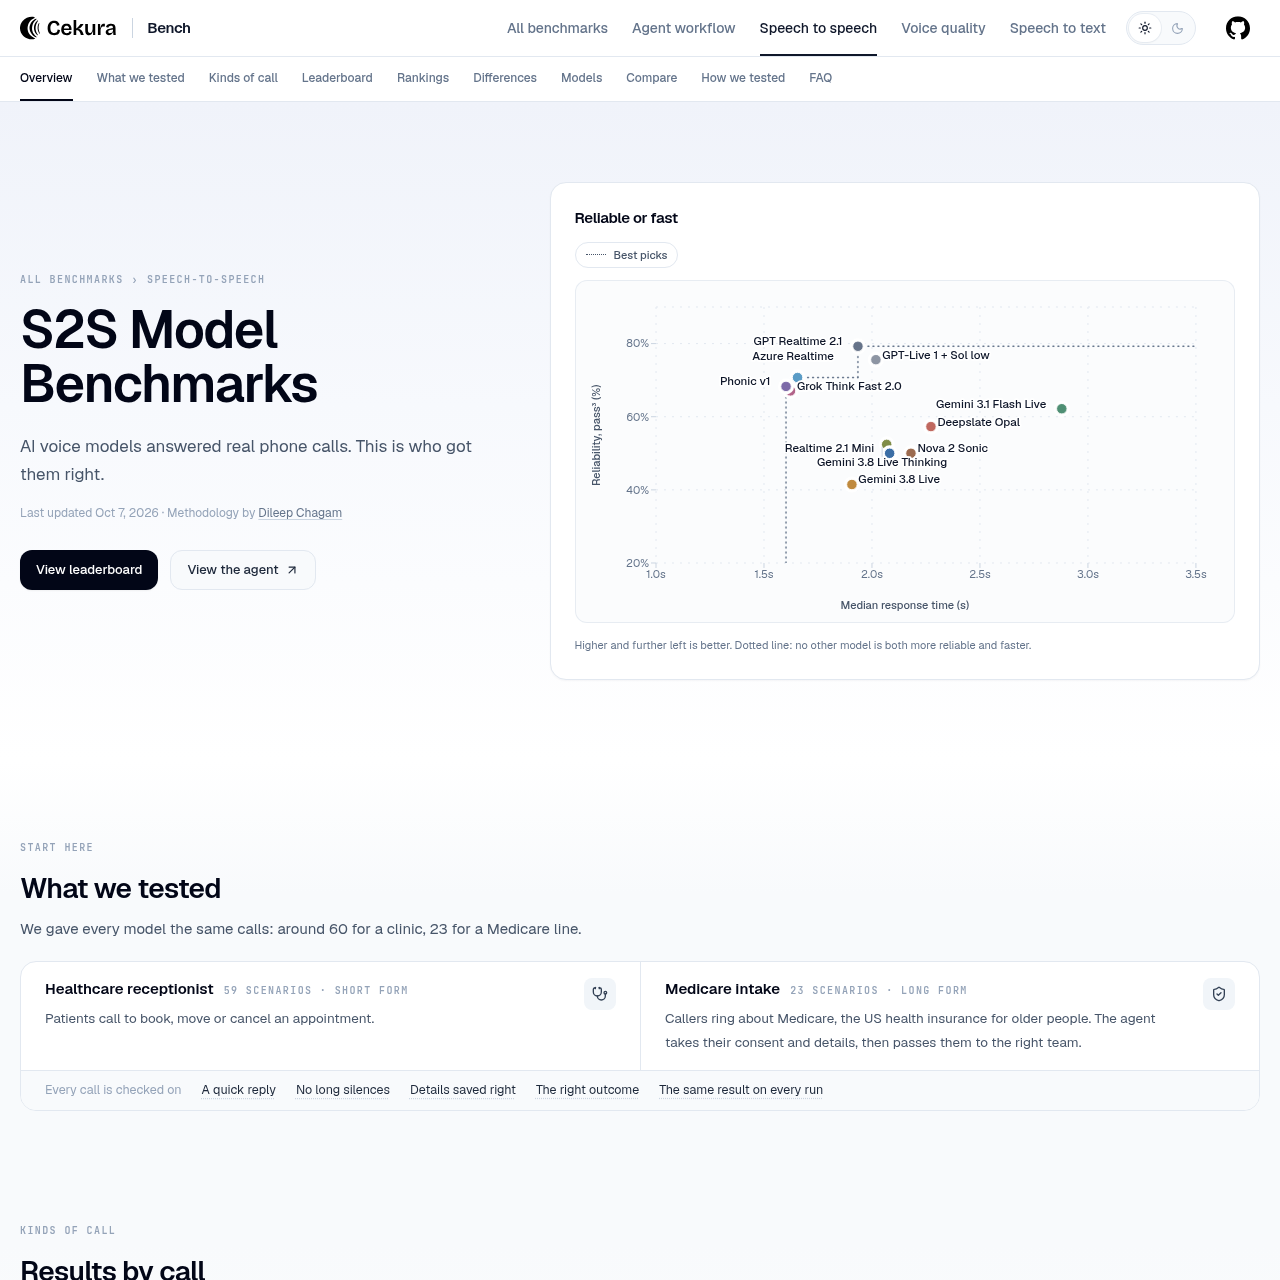
Cekura Bench ofrece un banco de pruebas abierto para evaluar modelos de IA de voz a voz en tiempo real mediante 82 llamadas simuladas de gestión clínica y admisión de Medicare.
Qué hace el producto y cómo se presenta oficialmente
Cekura Bench es un benchmark que evalúa modelos de voz a voz en tiempo real mediante escenarios estandarizados de llamadas telefónicas para medir fiabilidad conversacional, latencia y precisión de datos.
La plataforma prueba modelos en 82 escenarios distintos tres veces cada uno mediante el framework de agentes de código abierto Pipecat, publicando transcripciones completas, registros de herramientas y métricas.
Casos de uso respaldados por fuentes oficiales
Los equipos comparan modelos de voz en tiempo real en consistencia, tiempos de respuesta y precisión antes de desplegar agentes.
Los desarrolladores evalúan modelos nativos de voz a voz frente a una canalización en cascada de voz a texto, modelo lingüístico y síntesis.
El benchmark estandariza las condiciones de prueba ejecutando cada modelo de voz a voz en el mismo framework de agentes de código abierto Pipecat. Los prompts, herramientas de integración y conexiones se mantienen idénticos entre ejecuciones, aislando el rendimiento del modelo como la única variable evaluada. Una línea base en cascada no clasificada que combina Flux, GPT-4.1 y ElevenLabs Flash actúa como referencia arquitectónica.
La evaluación abarca 82 escenarios de prueba en tres ejecuciones en directo, sumando 2952 llamadas entre gestión de citas y cualificación de Medicare. Una llamada se aprueba solo si el agente logra el resultado requerido y guarda correctamente todos los campos esperados, midiendo la consistencia según la proporción de escenarios exitosos en cada ejecución.
Comprobaciones con tus propios materiales y flujo de trabajo
Qué fuentes se revisaron y cuándo
Respuestas basadas en el registro de producto con fuentes verificadas
El benchmark evalúa 82 escenarios en dos suites: 59 de recepcionista clínica para gestión de citas y 23 de admisión de Medicare con consentimiento, cualificación y derivación.
La fiabilidad se mide con la métrica Pass-Cubed, calculando el porcentaje de escenarios completados con éxito a lo largo de tres ejecuciones consecutivas de llamadas en directo.
Todos los modelos emplean la misma configuración de agente Pipecat de código abierto, con prompts, definiciones de herramientas y conexiones idénticas para aislar su rendimiento.
Sí, incluye como referencia comparativa no clasificada una cascada compuesta por Flux para voz a texto, GPT-4.1 para razonamiento y ElevenLabs Flash para síntesis de voz.
Cada ficha de modelo enlaza directamente con informes de Cekura que contienen las transcripciones completas, ejecuciones de herramientas y puntuaciones para su verificación.