Cekura Bench favicon

Cekura Bench

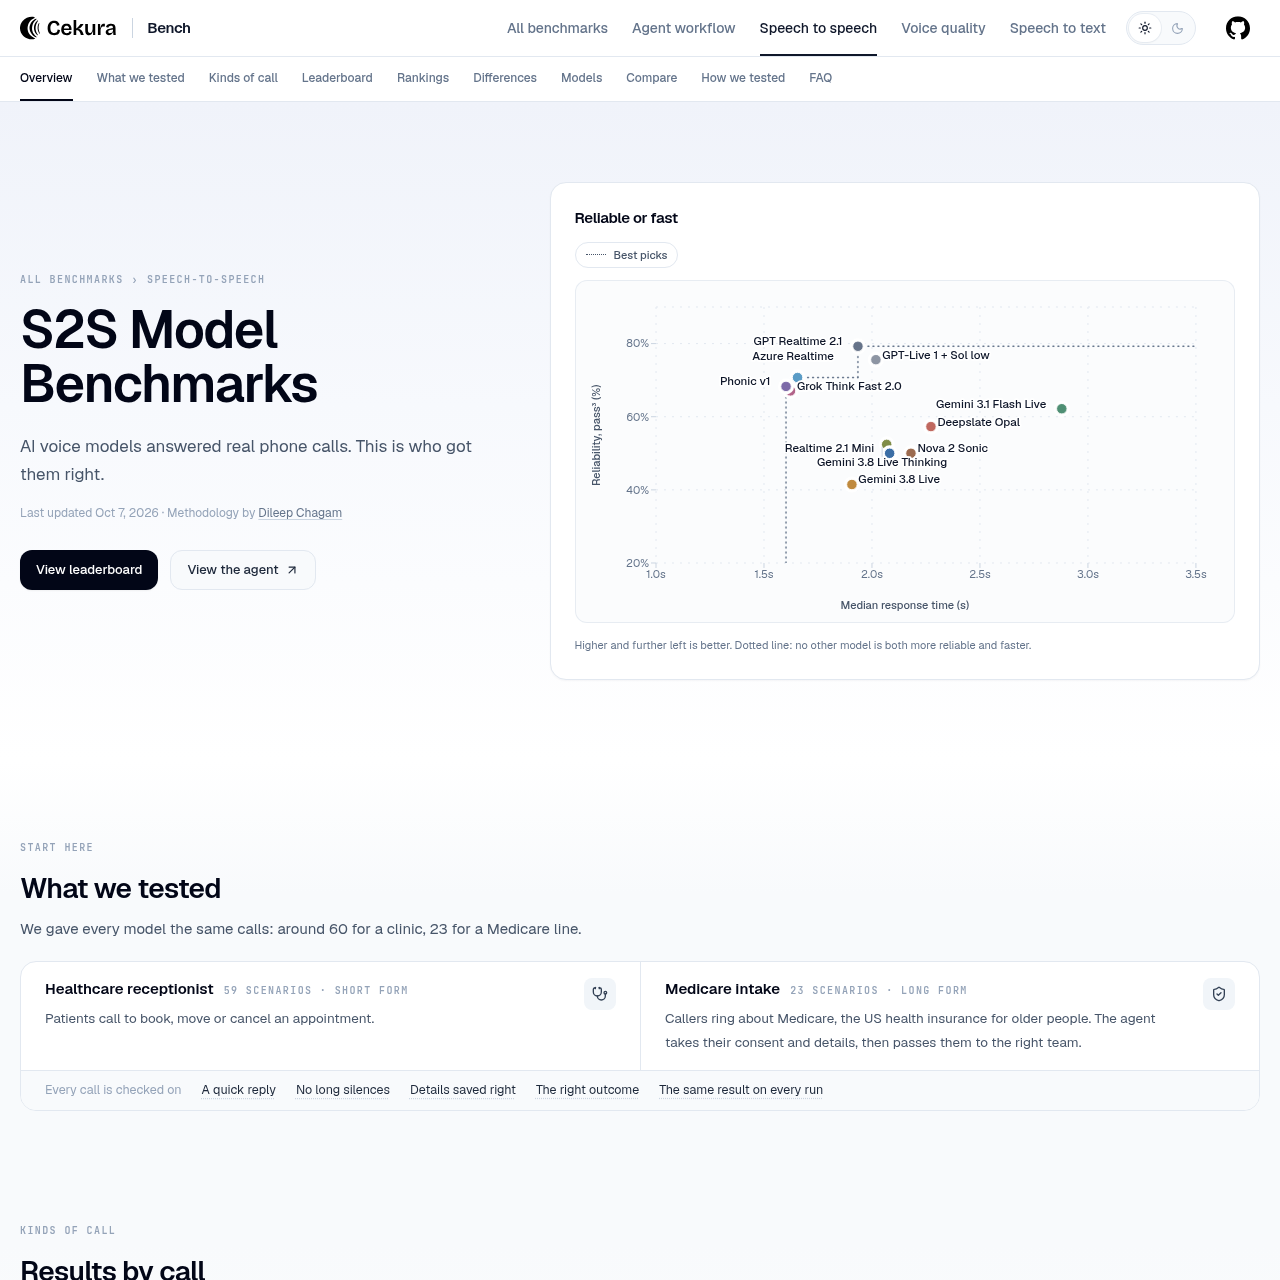
Cekura Bench propose un banc d'essai ouvert évaluant les modèles d'IA speech-to-speech en temps réel à travers 82 scénarios d'appels téléphoniques simulés de prise de rendez-vous clinique et d'admission Medicare.

Assistant de RechercheÉvaluation des modèles natifs…Consultation des rapports d'appels…Mesure des métriques opérationnelles, y…Suites d'évaluation vocale standardisées
Cekura Bench product interface screenshot
Visites mensuelles estimées
66 k
Période des données:
Référencé sur AIToolly

Qu’est-ce que Cekura Bench ? Présentation du produit

Fonction du produit et positionnement officiel

Cekura Bench est un benchmark qui évalue les modèles vocaux speech-to-speech en temps réel à l'aide de scénarios standardisés d'appels téléphoniques afin de mesurer la fiabilité conversationnelle, la latence et la précision des données.

La plateforme teste chaque modèle trois fois sur 82 scénarios distincts à l'aide d'un framework d'agent open source Pipecat, en publiant l'intégralité des transcriptions d'appels, les enregistrements d'exécution d'outils et les métriques de performance.

À quoi peut servir Cekura Bench ?

Cas d’usage étayés par les sources officielles

Évaluation de modèles vocaux

Les équipes comparent les modèles vocaux en temps réel sur la cohérence, les temps de réponse et l'exactitude des données avant de déployer des agents vocaux.

Banc d'essai d'architectures

Les développeurs évaluent les modèles natifs speech-to-speech par rapport à un pipeline en cascade standard composé de transcription vocale, modèle de langage et synthèse vocale.

Méthodologie du benchmark et métriques d'évaluation

Le benchmark standardise les conditions de test en exécutant chaque modèle speech-to-speech via le même framework d'agent vocal open source Pipecat. Les invites, les outils d'intégration et les connexions restent identiques d'un test à l'autre, isolant ainsi la performance du modèle comme seule variable testée. Une référence en cascade non classée combinant Flux, GPT-4.1 et ElevenLabs Flash sert de repère architectural.

L'évaluation comprend 82 scénarios de test menés sur trois séries d'appels en direct, totalisant 2 952 appels portant sur la gestion de rendez-vous en clinique et l'éligibilité Medicare. Un appel n'est validé que si l'agent atteint le résultat requis et enregistre correctement tous les champs de données attendus, la cohérence étant mesurée par la proportion de scénarios réussis sur chaque série.

  • La suite courte de réception médicale couvre 59 scénarios testant la recherche de patients, la vérification des disponibilités et les modifications de réservation.
  • La suite longue d'admission Medicare évalue 23 scénarios comportant 42 champs et couvrant le consentement de l'appelant, l'éligibilité et le transfert d'appel.
  • Le classement de fiabilité applique une norme pass-cubed exigeant une réussite sur l'ensemble des trois séries consécutives.
  • Les transcriptions d'appels individuels, les appels d'outils, les chiffres de latence et les scores de résultat sont consultables pour vérification.

Points à tester avant de choisir Cekura Bench

Vérifications à effectuer avec vos contenus et votre flux de travail

  • Vérifiez si les scénarios de benchmark pour les rendez-vous en clinique et l'admission Medicare reflètent les schémas conversationnels requis par votre application vocale.
  • Examinez la fiabilité du modèle selon des catégories de difficultés précises telles que le bruit de fond, la perte de paquets, les interruptions et les corrections de l'appelant.
  • Consultez les rapports d'appels publics et les journaux d'outils pour observer comment les modèles gèrent la saisie complexe de champs multiples et les notes de transfert.

Sources et date de vérification de Cekura Bench

Sources vérifiées et date de la vérification

Dernière vérification

Questions fréquentes sur Cekura Bench

Réponses fondées sur la fiche produit dont les sources ont été vérifiées

Quels scénarios sont testés dans l'évaluation speech-to-speech de Cekura Bench ?

Le benchmark évalue 82 scénarios répartis en deux suites : une suite de 59 scénarios de réception en clinique pour la prise de rendez-vous et une suite de 23 scénarios d'admission Medicare couvrant le consentement, l'éligibilité et l'acheminement.

Comment Cekura Bench calcule-t-il la fiabilité ?

La fiabilité est mesurée à l'aide d'une métrique pass-cubed, qui calcule le pourcentage de scénarios réussis sur trois séries consécutives d'appels en direct.

Quelles conditions restent constantes pour l'ensemble des modèles évalués ?

Tous les modèles exécutent la même configuration d'agent open source Pipecat avec des invites, des définitions d'outils et des paramètres de connexion identiques afin d'isoler la performance du modèle.

Cekura Bench compare-t-il les modèles vocaux natifs à des architectures en cascade ?

Oui, une cascade de référence non classée associant Flux pour la transcription vocale, GPT-4.1 pour le raisonnement et ElevenLabs Flash pour la synthèse vocale est incluse à des fins de comparaison contextuelle.

Où peut-on consulter les journaux de test et les transcriptions de conversations ?

Chaque entrée de modèle renvoie directement aux rapports Cekura contenant les transcriptions complètes, les exécutions d'appels d'outils et les scores de résultat à des fins de vérification.

Découvrez d’autres outils récemment ajoutés dans la même catégorie.