Architecture de post-entraînement et apprentissage par renforcement
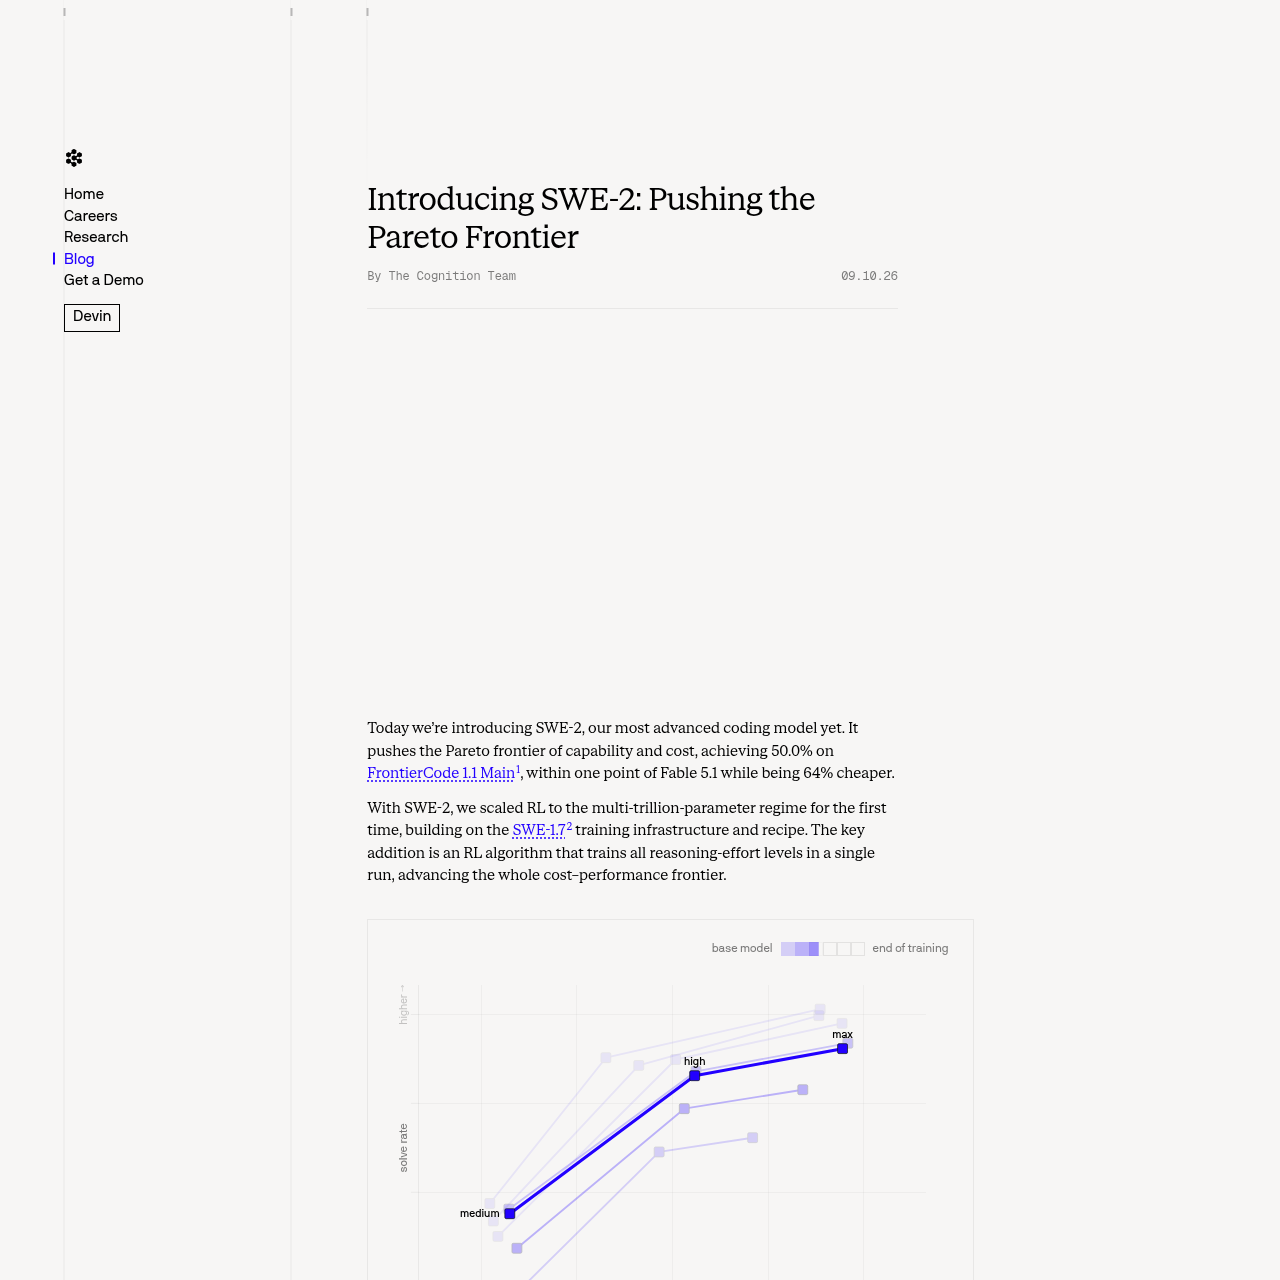
SWE-2 est post-entraîné à partir de Kimi K3, adaptant l'apprentissage par renforcement à un modèle de plusieurs billions de paramètres afin d'optimiser les performances sur différents paliers d'effort de raisonnement en une seule session d'entraînement.
L'architecture d'entraînement utilise une référence de récompense pondérée par la longueur pour stabiliser la variance du gradient sans nécessiter de passes arrière supplémentaires. Les déploiements d'inférence s'appuient sur des noyaux NVFP4 et FP8 ainsi que sur le décodage spéculatif soutenu par un modèle d'ébauche mis à jour en ligne.
- Intègre des pénalités linéaires adaptées à la pente locale de la courbe frontière du modèle de base à travers les niveaux d'effort.
- Applique des références de groupe pondérées par la longueur pour réduire la divergence de politique entre l'entraînement et l'inférence.
- Utilise des noyaux NVFP4 et FP8 à faible précision avec un entraînement conscient de la quantification afin de gérer la surcharge mémoire durant les déploiements.