Cognition's SWE-2
SWE-2 是 Cognition 旗下的旗舰级编程模型,基于 Kimi K3 进行了后训练,专为智能体软件工程设计,具备聚焦的代码库导航能力,并可在多个推理算力档位下执行严谨的验证。
编程&IT使用 read、grep 和目录列表工具浏览代码仓库,以规划并执行代码修改。运行编译、代码检查(linting)以及自动化测试命令,对系统行为进行端到端验证。构建 Git 提交,并向用户传达最终的实现细节。在外部集成不可用时,识别替代数据源与回退路径。
SWE-2 是 Cognition 旗下的旗舰级编程模型,基于 Kimi K3 进行了后训练,专为智能体软件工程设计,具备聚焦的代码库导航能力,并可在多个推理算力档位下执行严谨的验证。
产品用途与官方定位
SWE-2 是 Cognition 开发的专业编程模型,基于拥有 2.8 万亿参数的 Kimi K3 基础模型,利用专门为智能体软件工程定制的强化学习技术进行了后训练。
SWE-2 直接集成于 Devin 运行环境中,能够执行端到端的开发工作流,包括代码仓库搜索、多文件代码编辑、构建验证以及自动化测试编写。
有官方来源支持的使用场景
开发者可将代码库中的 issue 指派给 SWE-2,由其检查相关文件、规划变更方案、应用代码更新并提交经过验证的修复。
工程团队可以使用该模型编写端到端测试,针对各种边缘情况独立验证软件修改的正确性。
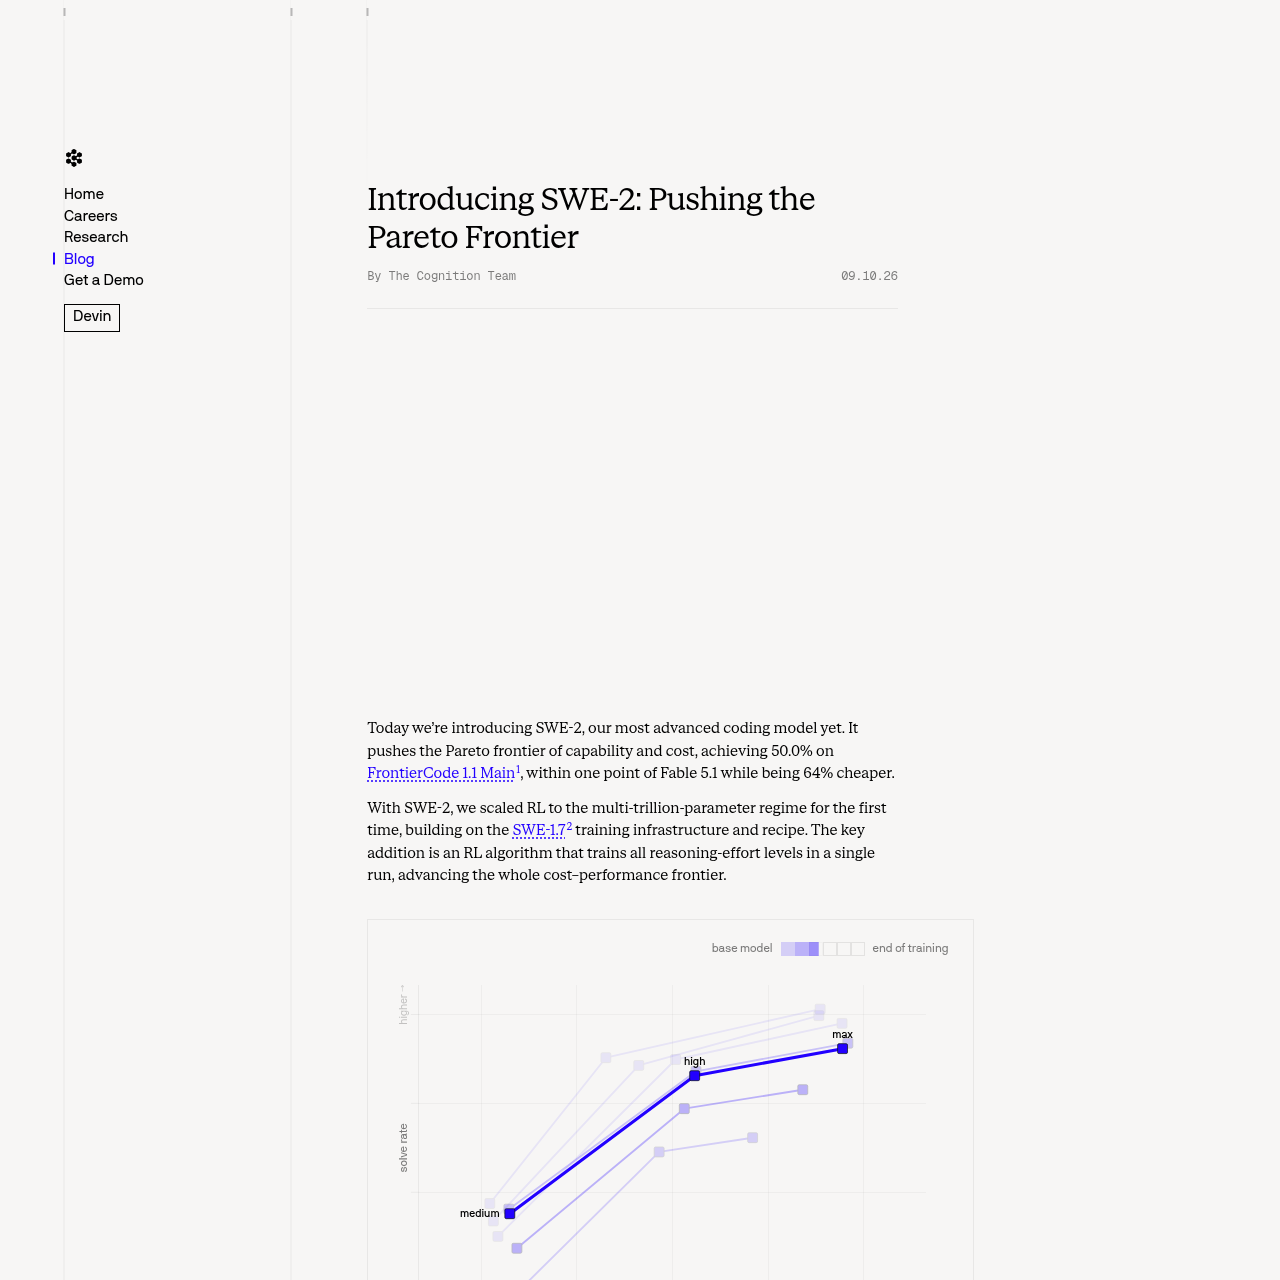
SWE-2 基于 Kimi K3 进行了后训练,将强化学习扩展到数万亿参数规模的模型上,从而在单次训练运行中优化了跨不同推理算力档位的综合表现。
该训练架构采用长度加权奖励基线来稳定梯度方差,无需执行额外的反向传播。在推理服务方面,其铺展依赖 NVFP4 和 FP8 内核,并结合在线更新的草稿模型进行推测解码。
用自己的素材和工作流完成验证
核对了哪些信息以及核对时间
基于已核对产品资料的回答
SWE-2 是基于拥有 2.8 万亿参数的 Kimi K3 模型进行后训练构建的,该基础模型此前已针对智能体编程进行过强化学习。
SWE-2 目前已在 Devin Desktop 和 Devin CLI 中提供支持,并且其服务正逐步扩展至 Devin Web 和 Devin Fusion。
SWE-2 将探索范围聚焦于相关文件,使其相较于 SWE-1.7 能够以更少的探索步骤更早地进入代码编辑实现阶段。
该模型支持 medium、high 和 max 三个算力档位,允许开发者在快速代码编辑与更深层次的规划或验证之间进行灵活权衡。
SWE-2 会通过执行测试构件并检查具体的技术运行证据来重新推导结论,而不是在未经验证的情况下盲目接受用户的假设。