Post-Training-Architektur und Reinforcement Learning
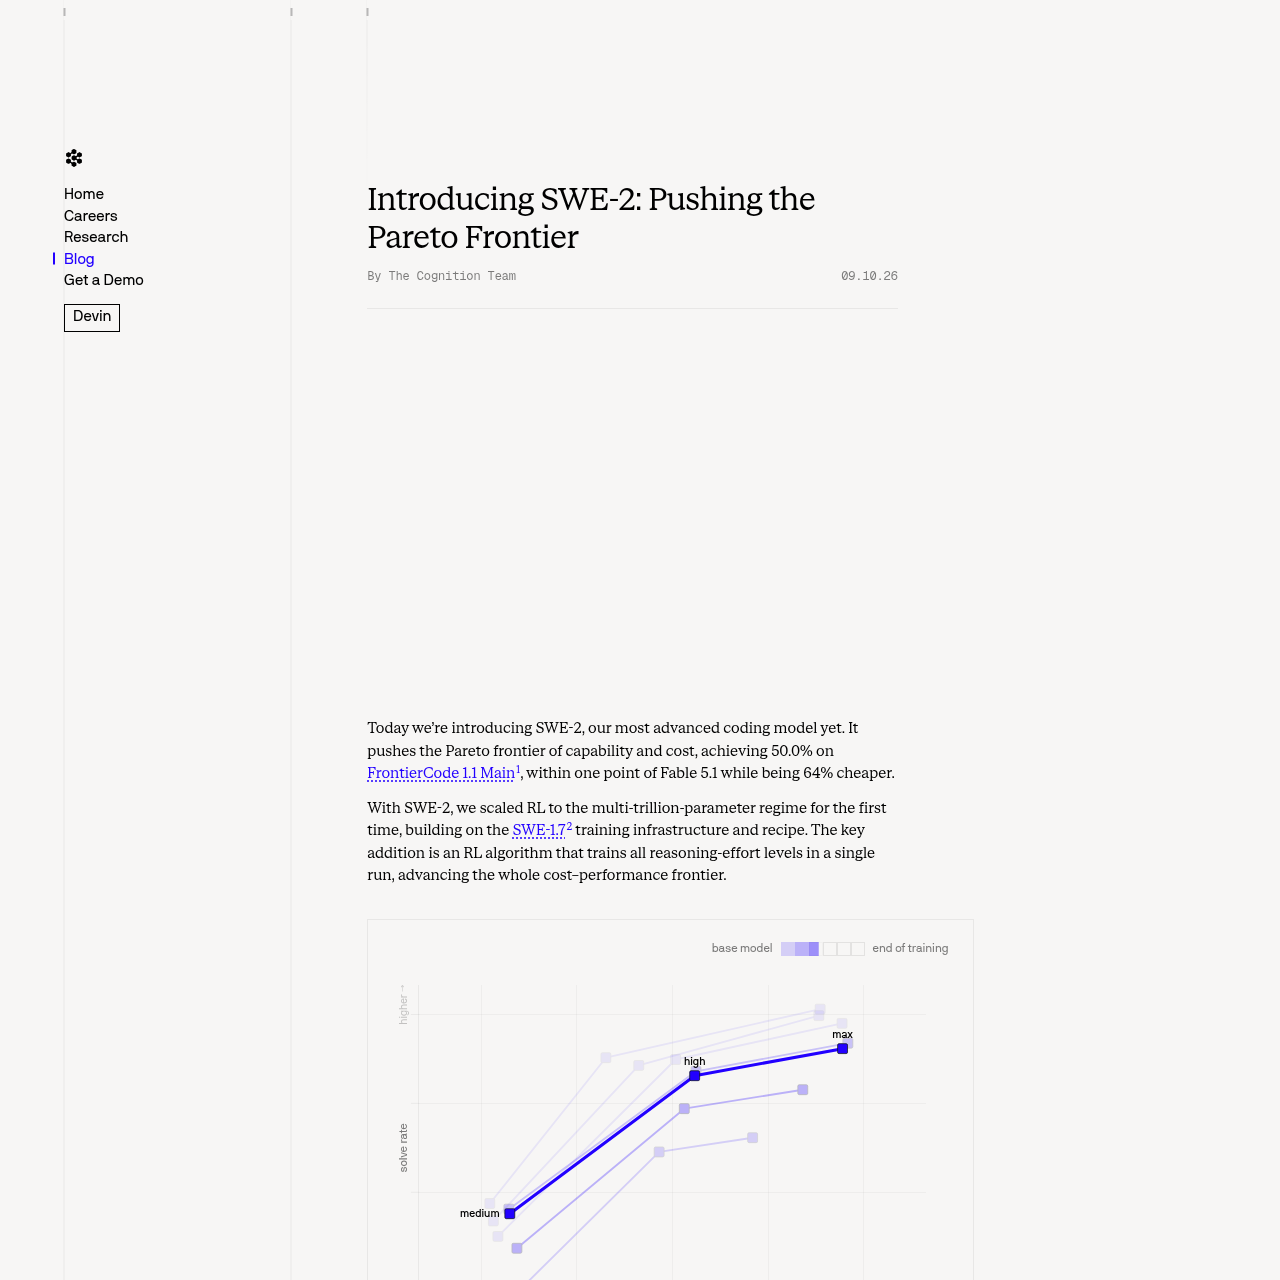
SWE-2 wird ausgehend von Kimi K3 nachtrainiert, wobei Reinforcement Learning auf ein Modell mit mehreren Billionen Parametern skaliert wird, um die Leistung über verschiedene Reasoning-Aufwandstufen hinweg in einem einzigen Trainingslauf zu optimieren.
Die Trainingsarchitektur nutzt eine längengewichtete Belohnungs-Baseline, um die Gradientenvarianz zu stabilisieren, ohne zusätzliche Backward-Pässe zu erfordern. Bereitstellungs-Rollouts stützen sich auf NVFP4- und FP8-Kernel sowie spekulatives Decodieren, unterstützt durch ein online aktualisiertes Draft-Modell.
- Beinhaltet lineare Strafen, die an die lokale Steigung der Grenzkurve des Basismodells über verschiedene Aufwandstufen hinweg angepasst sind.
- Wendet längengewichtete Gruppen-Baselines an, um Richtliniendivergenzen zwischen Training und Inferenz zu verringern.
- Verwendet NVFP4- und FP8-Kernel mit geringer Präzision und quantisierungsbewusstem Training, um den Speicher-Overhead während der Rollouts zu steuern.