Cognition's SWE-2 favicon

Cognition's SWE-2

SWE-2 es el modelo de programación insignia de Cognition posentrenado a partir de Kimi K3, diseñado para la ingeniería de software agéntica con navegación focalizada del código y verificación rigurosa en múltiples niveles de esfuerzo.

Código e ITNavega por repositorios utilizando…Ejecuta comandos de compilación,…Genera commits de git y comunica los…Identifica fuentes de datos…
Cognition's SWE-2 product interface screenshot
Visitas mensuales estimadas
427 mil
Periodo de datos:
Publicado en AIToolly

¿Qué es Cognition's SWE-2? Descripción del producto

Qué hace el producto y cómo se presenta oficialmente

SWE-2 es un modelo de programación especializado desarrollado por Cognition, posentrenado a partir del modelo base Kimi K3 de 2,8 billones de parámetros mediante aprendizaje por refuerzo adaptado a la ingeniería de software agéntica.

Integrado directamente en los entornos de Devin, SWE-2 ejecuta flujos de trabajo de desarrollo de extremo a extremo, incluyendo la búsqueda en repositorios, la edición de código en múltiples archivos, la verificación de compilación y la creación de pruebas.

¿Para qué se puede usar Cognition's SWE-2?

Casos de uso respaldados por fuentes oficiales

Mantenimiento de repositorios y corrección de errores

Los desarrolladores pueden asignar problemas del código base a SWE-2 para inspeccionar archivos relevantes, planificar modificaciones, aplicar actualizaciones de código y confirmar soluciones verificadas.

Generación automatizada de pruebas y control de regresiones

Los equipos de ingeniería pueden utilizar el modelo para escribir pruebas de extremo a extremo que validen de forma independiente las modificaciones del software frente a casos extremos.

Arquitectura de posentrenamiento y aprendizaje por refuerzo

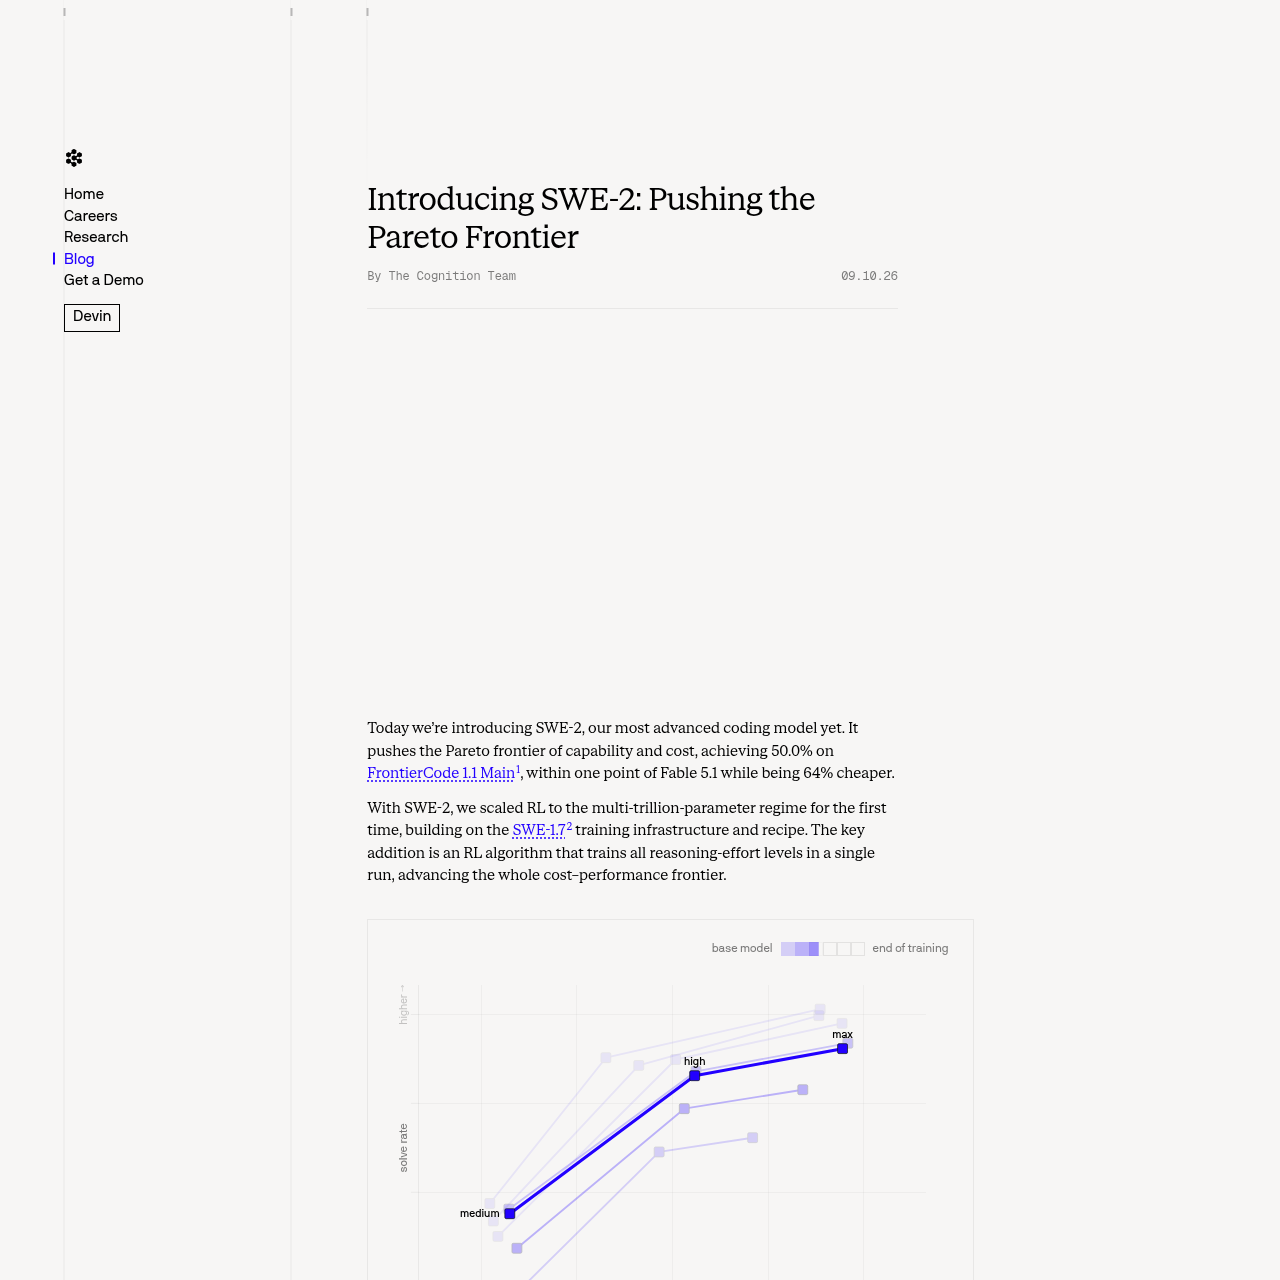
SWE-2 se posentrena a partir de Kimi K3, escalando el aprendizaje por refuerzo a un modelo de múltiples billones de parámetros para optimizar el rendimiento en distintos niveles de esfuerzo de razonamiento en una sola ejecución de entrenamiento.

La arquitectura de entrenamiento utiliza una línea base de recompensa ponderada por longitud para estabilizar la varianza del gradiente sin requerir pasadas hacia atrás adicionales. Los despliegues de inferencia se basan en kernels NVFP4 y FP8 junto con decodificación especulativa respaldada por un modelo borrador actualizado en línea.

  • Incorpora penalizaciones lineales adaptadas a la pendiente local de la curva de frontera del modelo base en todos los niveles de esfuerzo.
  • Aplica líneas base grupales ponderadas por longitud para reducir la divergencia de políticas entre el entrenamiento y la inferencia.
  • Utiliza kernels NVFP4 y FP8 de baja precisión con entrenamiento consciente de la cuantización para gestionar la sobrecarga de memoria durante los despliegues.

Qué probar antes de elegir Cognition's SWE-2

Comprobaciones con tus propios materiales y flujo de trabajo

  • Verifique que SWE-2 sea accesible en la interfaz prevista, como Devin Desktop, Devin CLI, Devin Web o Devin Fusion.
  • Compruebe si los ajustes de esfuerzo de razonamiento medio, alto o máximo se adaptan mejor a la complejidad y a los requisitos de exploración del repositorio de destino.
  • Revise los requisitos del proyecto que dependen en gran medida de comandos de terminal avanzados frente al rendimiento documentado en pruebas comparativas basadas en terminales.

Fuentes y fecha de revisión de Cognition's SWE-2

Qué fuentes se revisaron y cuándo

Última comprobación
Categoría
Código e IT

Preguntas frecuentes sobre Cognition's SWE-2

Respuestas basadas en el registro de producto con fuentes verificadas

¿Sobre qué modelo fundamental está construido SWE-2?

SWE-2 está posentrenado a partir de Kimi K3, un modelo de 2,8 billones de parámetros con aprendizaje por refuerzo previo para programación agéntica.

¿Qué entornos de despliegue admiten SWE-2?

SWE-2 está disponible dentro de Devin Desktop y Devin CLI, con despliegues que se extienden a Devin Web y Devin Fusion.

¿Cómo aborda SWE-2 la exploración de repositorios en comparación con modelos anteriores?

SWE-2 centra su exploración en archivos relevantes, lo que le permite iniciar la edición de código en menos pasos exploratorios que SWE-1.7.

¿Qué niveles de esfuerzo de razonamiento se pueden seleccionar en SWE-2?

El modelo admite niveles de esfuerzo medio, alto y máximo, ofreciendo opciones entre ediciones rápidas de código y una planificación o verificación más profundas.

¿Cómo maneja SWE-2 la verificación cuando se le cuestiona?

SWE-2 vuelve a deducir conclusiones ejecutando artefactos de prueba e inspeccionando evidencia técnica en lugar de aceptar hipótesis del usuario sin comprobación.

Explora otras herramientas añadidas recientemente en la misma categoría.