Google EmbeddingGemma 2
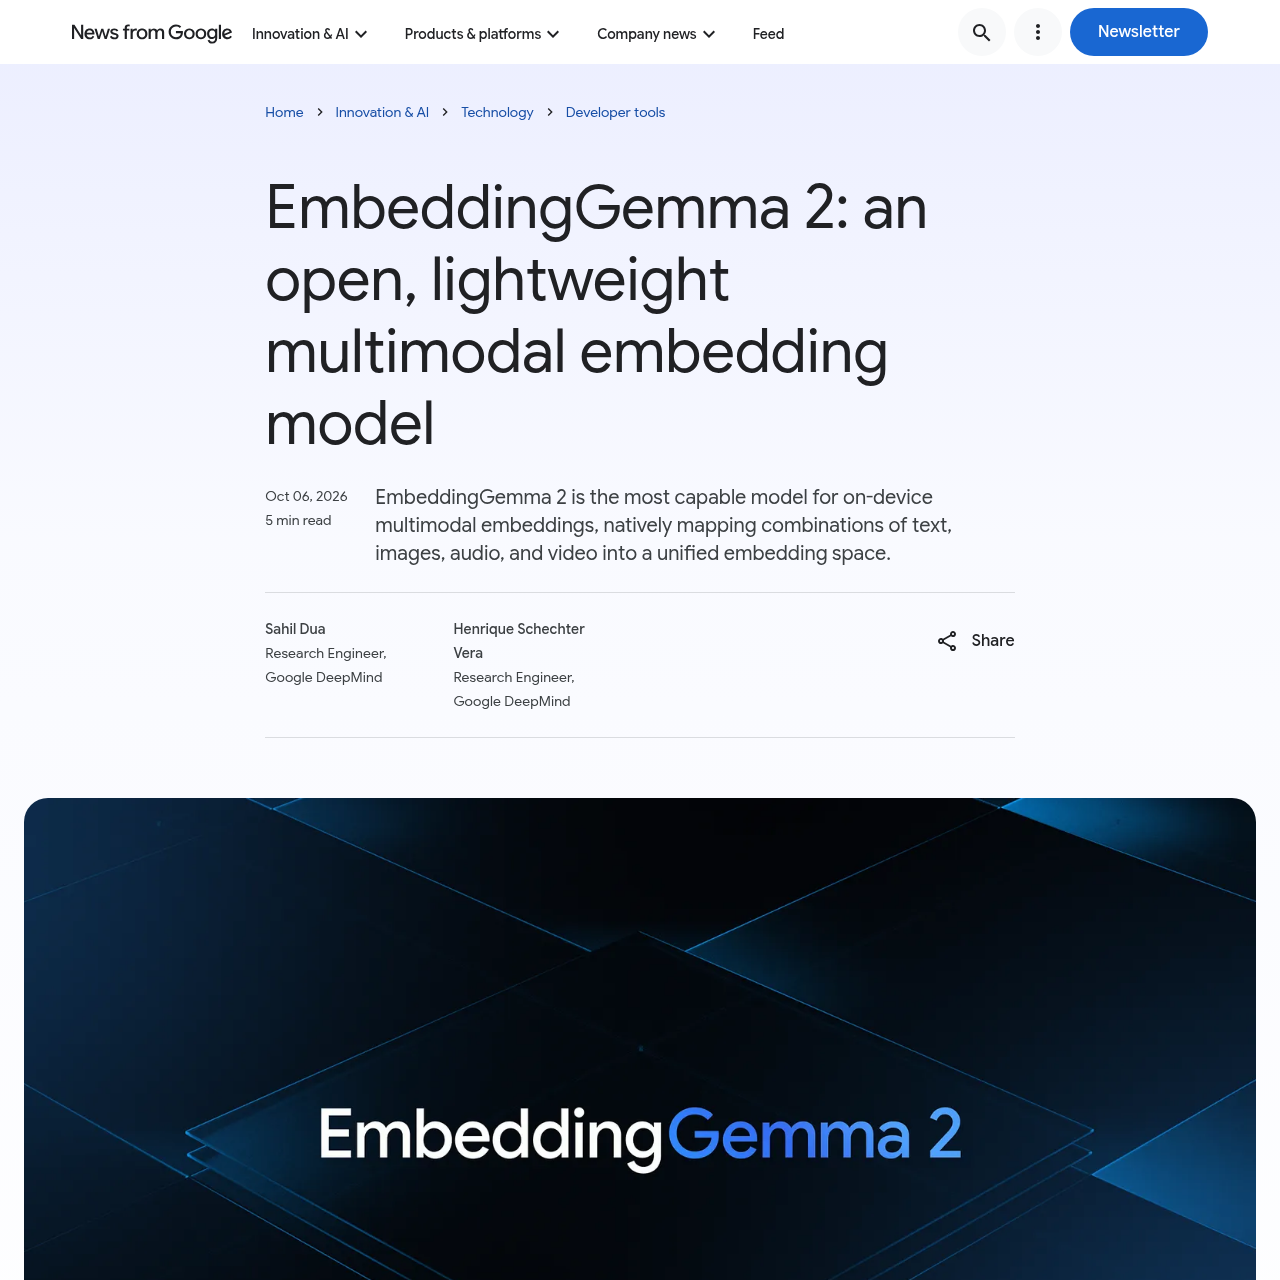
Google EmbeddingGemma 2는 텍스트, 코드, 이미지, 오디오 및 비디오 전반에서 로컬 온디바이스 검색을 수행하도록 설계된 740M 파라미터 오픈 멀티모달 임베딩 모델입니다.
제품의 기능과 공식 포지셔닝
Google EmbeddingGemma 2는 엣지 하드웨어에서의 로컬 추론을 위해 설계된 경량의 네이티브 멀티모달 임베딩 모델입니다. Gemma 4 아키텍처를 기반으로 구축된 이 모델은 텍스트, 프로그래밍 코드, 이미지, 오디오 녹음 및 비디오 프레임을 단일 벡터 공간으로 투영합니다.
이 모델은 모듈형 구조를 채택하여 개발자가 2억 7천만 개 파라미터로 텍스트 전용 작업을 실행하거나 전용 비전 및 오디오 인코더를 결합하여 완전한 멀티모달 지원을 구성할 수 있도록 지원합니다. 또한 마트료시카 표현 학습(Matryoshka Representation Learning)을 통합하여 제한된 스토리지 환경에 맞춰 벡터 차원을 유연하게 축소할 수 있습니다.
공식 출처로 확인된 활용 사례
개발자는 사진 및 비디오 라이브러리를 로컬에 색인하여 자연어나 이미지 기반의 시맨틱 검색을 구현할 수 있습니다.
프로그래밍 도구에서 소스 코드 파일을 색인하여 오프라인 시맨틱 코드 검색 및 코딩 에이전트 검색 시스템을 구축할 수 있습니다.
애플리케이션은 임베더와 생성형 언어 모델을 결합하여 여러 포맷에 걸친 로컬 컨텍스트 데이터를 효율적으로 검색할 수 있습니다.
EmbeddingGemma 2는 총 7억 4천만 개의 파라미터를 모듈형 컴포넌트로 분리하여 다양한 하드웨어 프로필 전반에서 효율적으로 실행되도록 구조화되었습니다. 텍스트 작업에만 집중하는 개발자는 270M 텍스트 베이스만 배포할 수 있으며, 멀티미디어를 처리하는 애플리케이션의 경우 170M 비전 및 300M 오디오 인코더를 추가로 로드할 수 있습니다.
로컬 벡터 데이터베이스에서의 성능을 최적화하기 위해 이 모델은 마트료시카 표현 학습을 활용합니다. 이 메커니즘을 통해 기본 768차원 임베딩을 512, 256 또는 128차원으로 축소할 수 있어 시맨틱 일관성을 유지하면서도 벡터 스토리지 설치 공간을 최대 6분의 1까지 줄일 수 있습니다.
본인의 자료와 작업 흐름으로 직접 확인할 항목
확인한 출처와 확인 시점
출처를 확인한 제품 정보를 바탕으로 한 답변
EmbeddingGemma 2는 단일 공유 임베딩 공간 내에서 텍스트, 소스 코드, 이미지, 비디오 프레임 및 오디오 녹음을 네이티브로 처리합니다.
Google Pixel 11 Pro에서 양자화 시 모델은 텍스트 전용 작업의 경우 약 191MB, 전체 멀티모달 모델의 경우 약 567MB의 활성 RAM을 필요로 합니다.
이 모델은 8,000토큰의 컨텍스트 윈도우를 갖추고 있어 최대 5.5분의 오디오, 29장의 이미지, 58개의 비디오 프레임 또는 인터리브된 미디어 조합을 처리할 수 있습니다.
마트료시카 표현 학습(Matryoshka Representation Learning)을 통해 출력 벡터를 768차원에서 512, 256 또는 128차원으로 축소하여 데이터베이스 크기를 줄입니다.
Gemma 4 아키텍처를 기반으로 구축되었기 때문에 EmbeddingGemma 2는 텍스트 토크나이저와 오디오 인코더를 Gemma 4와 공유하여 결합 메모리 사용량을 줄입니다.