Google EmbeddingGemma 2 favicon

Google EmbeddingGemma 2

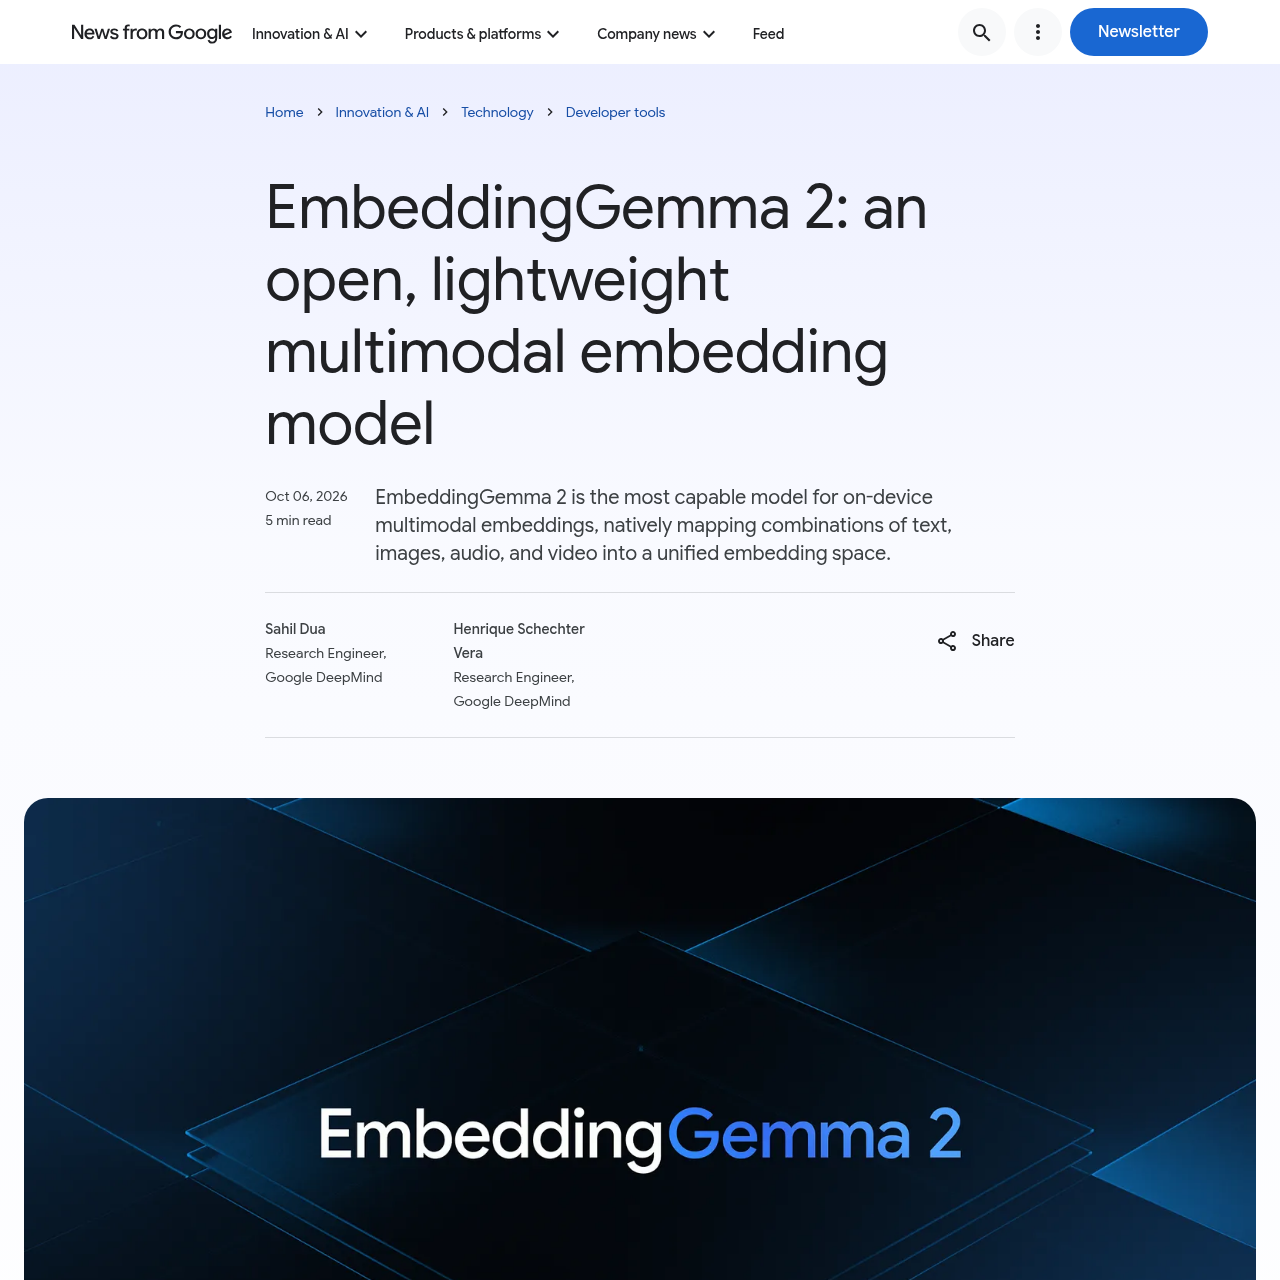
Google EmbeddingGemma 2 est un modèle ouvert de plongements multimodaux de 740M conçu pour la recherche locale sur l'appareil pour le texte, le code, l'image, l'audio et la vidéo.

Moteurs de RechercheGénère des plongements unifiés à…Tronque les dimensions d'intégration de…Indexe les dépôts de code locaux pour…Fonctionne aux côtés de Gemma 4 en…
Google EmbeddingGemma 2 product interface screenshot
Visites mensuelles estimées
8,8 M
Période des données:
Référencé sur AIToolly

Qu’est-ce que Google EmbeddingGemma 2 ? Présentation du produit

Fonction du produit et positionnement officiel

Google EmbeddingGemma 2 est un modèle de plongements natif et léger, conçu pour l'inférence locale sur le matériel edge. Bâti sur l'architecture de Gemma 4, il projette le texte, le code de programmation, les images, les enregistrements audio et les images vidéo dans un espace vectoriel unifié.

Le modèle adopte une structure modulaire permettant aux développeurs d'exécuter des tâches purement textuelles avec 270 millions de paramètres ou d'adjoindre des encodeurs dédiés à la vision et à l'audio pour une prise en charge multimodale complète. Il intègre également l'apprentissage Matryoshka pour réduire de façon flexible les dimensions vectorielles dans les environnements à stockage restreint.

À quoi peut servir Google EmbeddingGemma 2 ?

Cas d’usage étayés par les sources officielles

Recherche multimédia sur l'appareil

Les développeurs peuvent indexer localement des bibliothèques de photos et vidéos pour faciliter la recherche sémantique en langage naturel ou par image.

Indexation sémantique de bases de code

Les outils de développement peuvent indexer les fichiers de code source pour alimenter la recherche sémantique hors ligne et les systèmes d'agents de programmation.

Pipelines RAG multimodaux locaux

Les applications peuvent associer le modèle d'intégration à des modèles de langage génératifs pour extraire des données contextuelles locales sous plusieurs formats.

Architecture modulaire et efficacité du stockage

EmbeddingGemma 2 est structuré pour fonctionner efficacement sur différents profils matériels en divisant ses 740 millions de paramètres totaux en composants modulaires. Les développeurs se concentrant exclusivement sur les tâches textuelles peuvent déployer la base texte de 270M, tandis que les applications traitant du contenu multimédia peuvent charger en complément les encodeurs de 170M pour la vision et de 300M pour l'audio.

Pour optimiser les performances au sein des bases de données vectorielles locales, le modèle exploite l'apprentissage de représentations Matryoshka. Ce mécanisme permet de tronquer les plongements par défaut de 768 dimensions à 512, 256 ou 128 dimensions, ce qui offre une réduction pouvant atteindre un facteur six de l'empreinte de stockage vectoriel tout en préservant la cohérence sémantique.

  • Les tâches textuelles seules nécessitent 270 millions de paramètres.
  • L'encodeur visuel ajoute 170 millions de paramètres.
  • L'encodeur audio ajoute 300 millions de paramètres.
  • Les options de troncature de dimension incluent 768, 512, 256 et 128.

Points à tester avant de choisir Google EmbeddingGemma 2

Vérifications à effectuer avec vos contenus et votre flux de travail

  • Vérifier que les appareils edge cibles respectent les exigences de mémoire active d'environ 191 Mo pour le modèle quantifié texte seul ou 567 Mo pour le modèle multimodal.
  • Confirmer que les flux multimédias d'entrée s'intègrent dans la limite de contexte de 8K jetons, par exemple 5,5 minutes d'audio ou 58 images vidéo.
  • Vérifier si les représentations vectorielles tronquées à 128, 256 ou 512 dimensions offrent une précision acceptable pour les tâches de récupération en aval.

Sources et date de vérification de Google EmbeddingGemma 2

Sources vérifiées et date de la vérification

Dernière vérification

Questions fréquentes sur Google EmbeddingGemma 2

Réponses fondées sur la fiche produit dont les sources ont été vérifiées

Quelles modalités d'entrée EmbeddingGemma 2 peut-il traiter ?

EmbeddingGemma 2 traite nativement le texte, le code source, les images, les images vidéo et les enregistrements audio au sein d'un espace vectoriel partagé unique.

Quelle quantité de mémoire vive EmbeddingGemma 2 requiert-il lors de l'inférence ?

Lorsqu'il est quantifié sur un Google Pixel 11 Pro, le modèle requiert environ 191 Mo de mémoire vive active pour les opérations textuelles seules et environ 567 Mo pour le modèle multimodal complet.

Quelle est la taille de la fenêtre de contexte d'EmbeddingGemma 2 ?

Le modèle propose une fenêtre de contexte de 8 000 jetons, ce qui lui permet de traiter jusqu'à 5,5 minutes d'audio, 29 images, 58 images vidéo ou des combinaisons de médias entrelacés.

Comment EmbeddingGemma 2 optimise-t-il le stockage vectoriel ?

Grâce à l'apprentissage de représentations Matryoshka, les vecteurs de sortie peuvent être tronqués de 768 dimensions à 512, 256 ou 128 dimensions afin de réduire l'espace requis en base de données.

Comment EmbeddingGemma 2 s'intègre-t-il avec Gemma 4 ?

Conçu à partir de l'architecture Gemma 4, EmbeddingGemma 2 partage son tokeniseur de texte et son encodeur audio avec Gemma 4, ce qui réduit la consommation combinée de mémoire.

Découvrez d’autres outils récemment ajoutés dans la même catégorie.