Google EmbeddingGemma 2 favicon

Google EmbeddingGemma 2

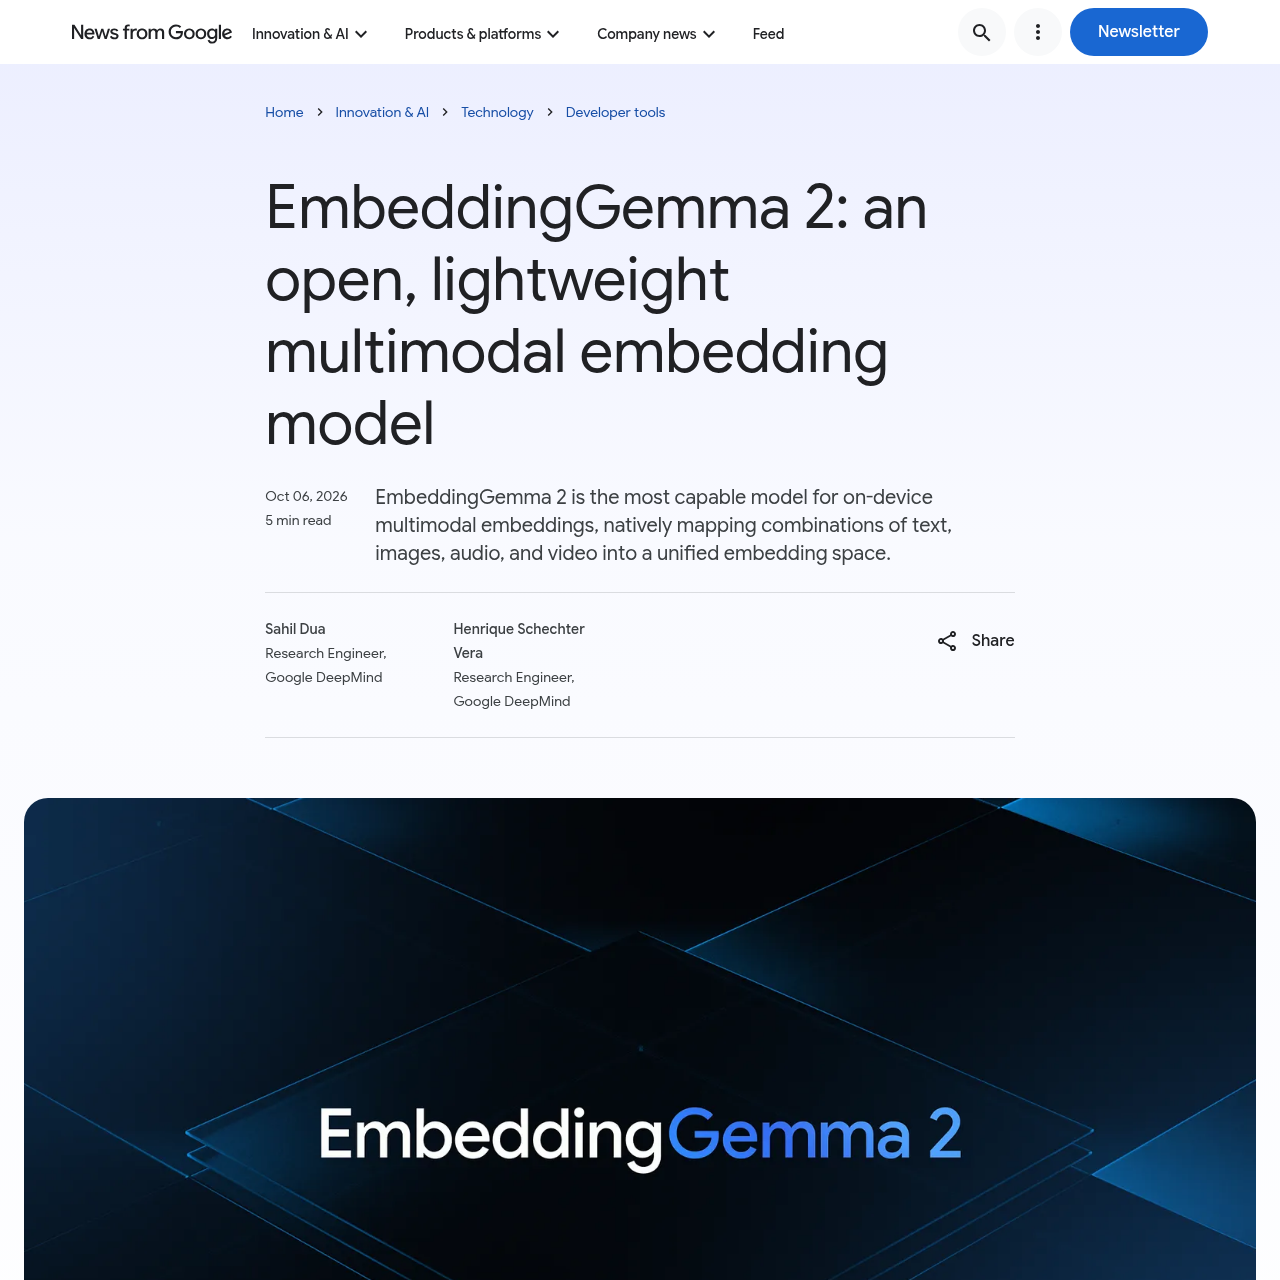
Google EmbeddingGemma 2 es un modelo abierto de embeddings multimodales de 740M diseñado para búsquedas locales en dispositivos con texto, código, imágenes, audio y vídeo.

Motores de BúsquedaGenera embeddings unificados a partir…Trunca las dimensiones de los…Indexa repositorios locales de código…Funciona junto a Gemma 4 utilizando…
Google EmbeddingGemma 2 product interface screenshot
Visitas mensuales estimadas
8,8 M
Periodo de datos:
Publicado en AIToolly

¿Qué es Google EmbeddingGemma 2? Descripción del producto

Qué hace el producto y cómo se presenta oficialmente

Google EmbeddingGemma 2 es un modelo de embeddings ligero y nativamente multimodal diseñado para la inferencia local en hardware perimetral. Desarrollado sobre la arquitectura de Gemma 4, el modelo proyecta texto, código de programación, imágenes, grabaciones de audio y fotogramas de vídeo en un espacio vectorial unificado.

El modelo emplea una estructura modular que permite a los desarrolladores ejecutar tareas exclusivamente de texto con 270 millones de parámetros o incorporar codificadores dedicados de visión y audio para un soporte multimodal completo. También integra Matryoshka Representation Learning para reducir de forma flexible las dimensiones vectoriales en entornos con almacenamiento limitado.

¿Para qué se puede usar Google EmbeddingGemma 2?

Casos de uso respaldados por fuentes oficiales

Búsqueda de archivos multimedia en el dispositivo

Los desarrolladores pueden indexar bibliotecas de fotos y vídeos localmente para facilitar la recuperación semántica basada en lenguaje natural o imágenes.

Indexación semántica de bases de código

Las herramientas de programación pueden indexar archivos de código fuente para permitir búsquedas semánticas de código sin conexión y sistemas de recuperación de agentes de programación.

Canalizaciones RAG multimodales locales

Las aplicaciones pueden combinar el generador de embeddings con modelos de lenguaje generativos para recuperar datos contextuales locales en múltiples formatos.

Arquitectura modular y eficiencia de almacenamiento

EmbeddingGemma 2 está estructurado para ejecutarse de manera eficiente en diversos perfiles de hardware al separar sus 740 millones de parámetros totales en componentes modulares. Los desarrolladores centrados exclusivamente en tareas de texto pueden implementar la base de texto de 270M, mientras que las aplicaciones que procesan multimedia pueden cargar los codificadores adicionales de visión de 170M y de audio de 300M.

Para optimizar el rendimiento en bases de datos vectoriales locales, el modelo aprovecha Matryoshka Representation Learning. Este mecanismo permite truncar los embeddings predeterminados de 768 dimensiones a 512, 256 o 128 dimensiones, lo que permite reducir hasta seis veces el espacio de almacenamiento de vectores manteniendo la coherencia semántica.

  • Las tareas exclusivas de texto requieren 270 millones de parámetros.
  • El codificador de visión añade 170 millones de parámetros.
  • El codificador de audio añade 300 millones de parámetros.
  • Las opciones de truncamiento de dimensiones incluyen 768, 512, 256 y 128.

Qué probar antes de elegir Google EmbeddingGemma 2

Comprobaciones con tus propios materiales y flujo de trabajo

  • Verificar que los dispositivos perimetrales de destino cumplan los requisitos de memoria activa de aproximadamente 191 MB para modelos cuantizados de solo texto o 567 MB para modelos multimodales.
  • Confirmar que los flujos multimedia de entrada se ajusten al límite de contexto de 8K tokens, como 5,5 minutos de audio o 58 fotogramas de vídeo.
  • Comprobar si las representaciones vectoriales truncadas a 128, 256 o 512 dimensiones proporcionan una precisión aceptable para las tareas de recuperación posteriores.

Fuentes y fecha de revisión de Google EmbeddingGemma 2

Qué fuentes se revisaron y cuándo

Última comprobación

Preguntas frecuentes sobre Google EmbeddingGemma 2

Respuestas basadas en el registro de producto con fuentes verificadas

¿Qué modalidades de entrada puede procesar EmbeddingGemma 2?

EmbeddingGemma 2 procesa de forma nativa texto, código fuente, imágenes, fotogramas de vídeo y grabaciones de audio dentro de un único espacio de embeddings compartido.

¿Cuánta memoria RAM requiere EmbeddingGemma 2 durante la inferencia?

Al cuantizarse en un Google Pixel 11 Pro, el modelo requiere aproximadamente 191 MB de RAM activa para operaciones de solo texto y alrededor de 567 MB para el modelo multimodal completo.

¿Cuál es la longitud de la ventana de contexto de EmbeddingGemma 2?

El modelo cuenta con una ventana de contexto de 8000 tokens, lo que le permite procesar hasta 5,5 minutos de audio, 29 imágenes, 58 fotogramas de vídeo o combinaciones intercaladas de medios.

¿Cómo optimiza EmbeddingGemma 2 el almacenamiento de vectores?

Mediante el uso de Matryoshka Representation Learning, los vectores de salida se pueden truncar desde 768 dimensiones hasta 512, 256 o 128 dimensiones para reducir el tamaño de la base de datos.

¿Cómo se integra EmbeddingGemma 2 con Gemma 4?

Al estar construido sobre la arquitectura de Gemma 4, EmbeddingGemma 2 comparte su tokenizador de texto y codificador de audio con Gemma 4, reduciendo el consumo combinado de memoria.

Explora otras herramientas añadidas recientemente en la misma categoría.