Google EmbeddingGemma 2
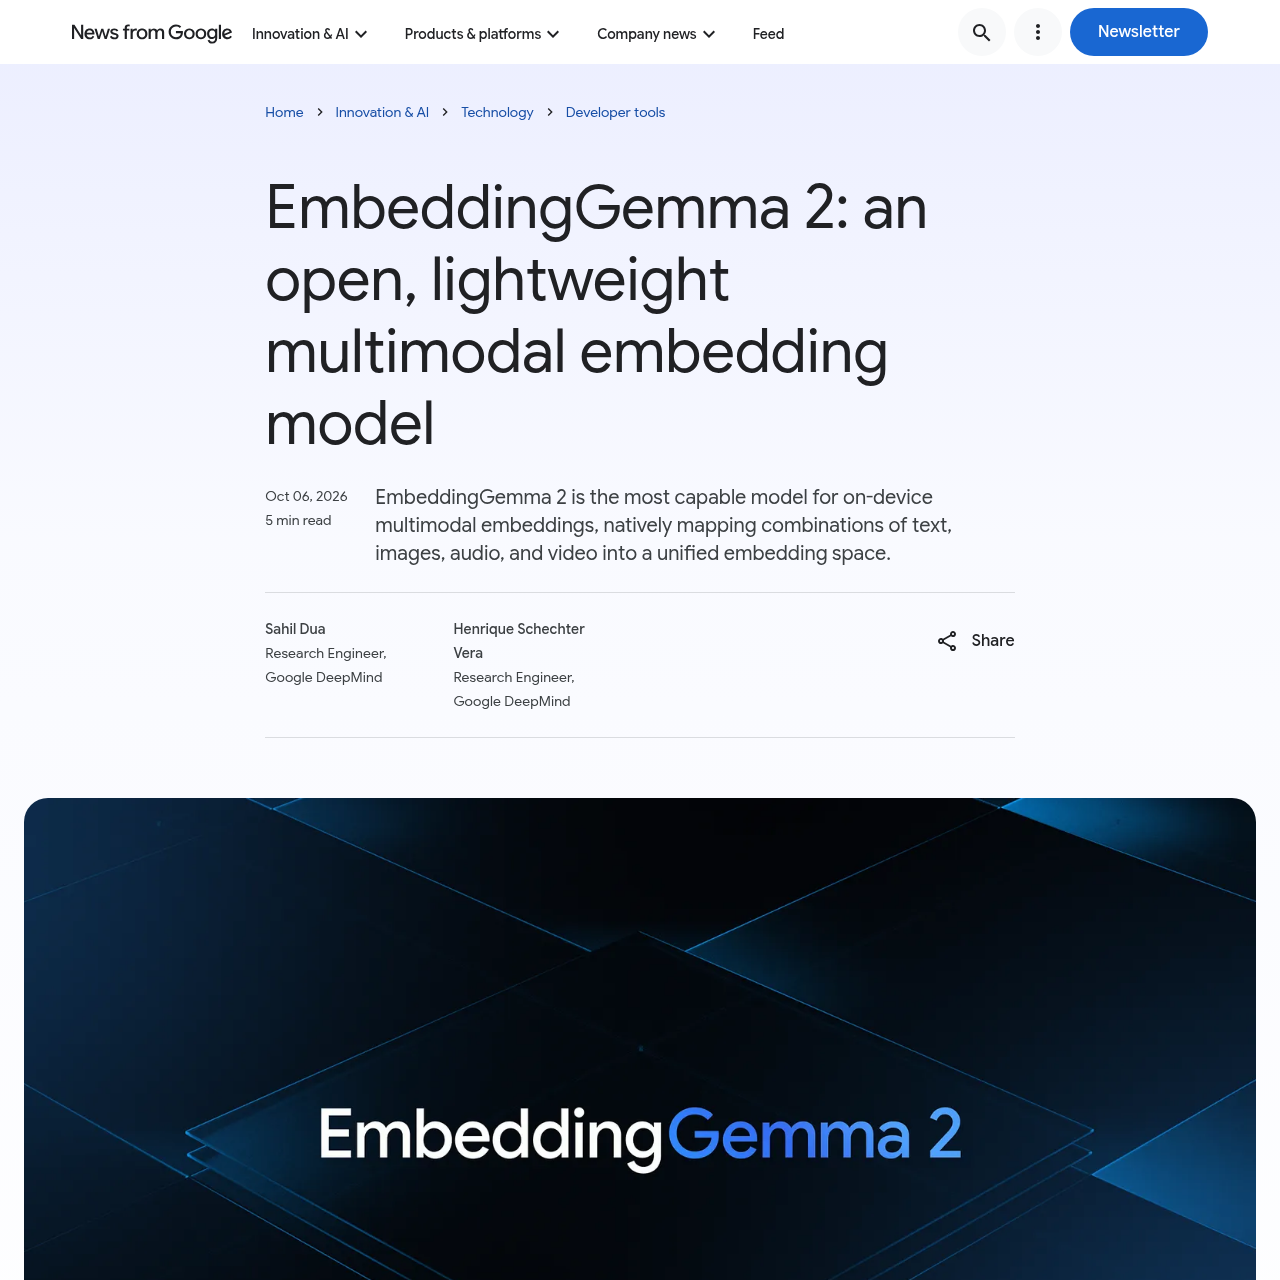
Google EmbeddingGemma 2は、テキスト、コード、画像、音声、動画のローカルおよびオンデバイス検索向けに設計されたオープンな740Mマルチモーダル埋め込みモデルです。
製品の機能と公式な位置づけ
Google EmbeddingGemma 2は、エッジハードウェア上でのローカル推論向けに設計された軽量でネイティブなマルチモーダル埋め込みモデルです。Gemma 4アーキテクチャをベースに構築されており、テキスト、プログラミングコード、画像、音声録音、動画フレームを統合された単一のベクトル空間へ投影します。
本モデルはモジュール構造を採用しており、開発者は2億7,000万パラメータでテキスト専用タスクを実行することも、専用の視覚・音声エンコーダを追加して完全なマルチモーダル対応に拡張することも可能です。またマトリョーシカ表現学習を取り入れており、容量制約のある環境に合わせてベクトル次元数を柔軟に縮小できます。
公式情報で確認できる活用例
写真や動画ライブラリをローカルでインデックス化し、自然言語や画像によるセマンティック検索を実現します。
ソースコードファイルをインデックス化して、オフラインのセマンティックコード検索やコーディングエージェントの検索を支援します。
埋め込みモデルと生成言語モデルを組み合わせ、複数形式にわたるコンテキスト豊かなローカルデータを取得できます。
EmbeddingGemma 2は、総計7億4,000万パラメータをモジュール式コンポーネントに分割することで、多様なハードウェアプロファイル上で効率的に動作するよう設計されています。テキストタスクのみに特化する開発者は270Mのテキストベースモデルのみを展開でき、マルチメディアを扱うアプリケーションでは170Mの視覚エンコーダおよび300Mの音声エンコーダを追加ロードできます。
ローカルベクトルデータベースでのパフォーマンスを最適化するため、モデルはマトリョーシカ表現学習を活用しています。この仕組みにより、デフォルトの768次元埋め込みを512次元、256次元、または128次元に切り詰めることができ、意味的一貫性を維持したままベクトルストレージの占有容量を最大6分の1に削減可能です。
自分の素材とワークフローで確認したい項目
確認した情報源とその日時
情報源を確認した製品情報に基づく回答
EmbeddingGemma 2は、単一の共有埋め込み空間内において、テキスト、ソースコード、画像、動画フレーム、および音声録音をネイティブに処理できます。
Google Pixel 11 Pro上で量子化して実行する場合、テキスト専用処理では約191MB、完全なマルチモーダルモデルでは約567MBの有効RAMを消費します。
本モデルは8,000トークンのコンテキストウィンドウを備えており、最大5.5分の音声、29枚の画像、58フレームの動画、またはこれらを混在させた入力を処理可能です。
マトリョーシカ表現学習を用いることで、出力ベクトルを768次元から512次元、256次元、または128次元へ切り詰めることができ、データベースサイズを削減可能です。
Gemma 4アーキテクチャをベースに構築されているため、テキストトークナイザーおよび音声エンコーダをGemma 4と共有し、併用時のメモリ消費量を削減できます。