iFixAi
iFixAiは、AIエージェント向けの独立した行動監査を提供し、基本的なベンチマーク指標を超えて、認可境界、ポリシー遵守、運用の整合性を検証します。
コードとIT不正な決定や隠蔽された情報を特定するための敵対的運用シナリオのシミュレーションプロンプトインジェクション耐性、ツール呼び出しのガバナンス、ポリシー遵守の評価運用保証基準に基づいた構造化監査スコアカードおよびアルファベット評価の生成多角的な不整合性監査
iFixAiは、AIエージェント向けの独立した行動監査を提供し、基本的なベンチマーク指標を超えて、認可境界、ポリシー遵守、運用の整合性を検証します。
製品の機能と公式な位置づけ
iFixAiは、自律型AIエージェントが割り当てられた運用境界、組織のルール、指定された権限レベルを遵守しているかどうかを評価するために設計された独立した監査ソリューションです。レイテンシやトークン消費量などの標準的なベンチマークにのみ焦点を当てるのではなく、現実の実行リスクを評価します。
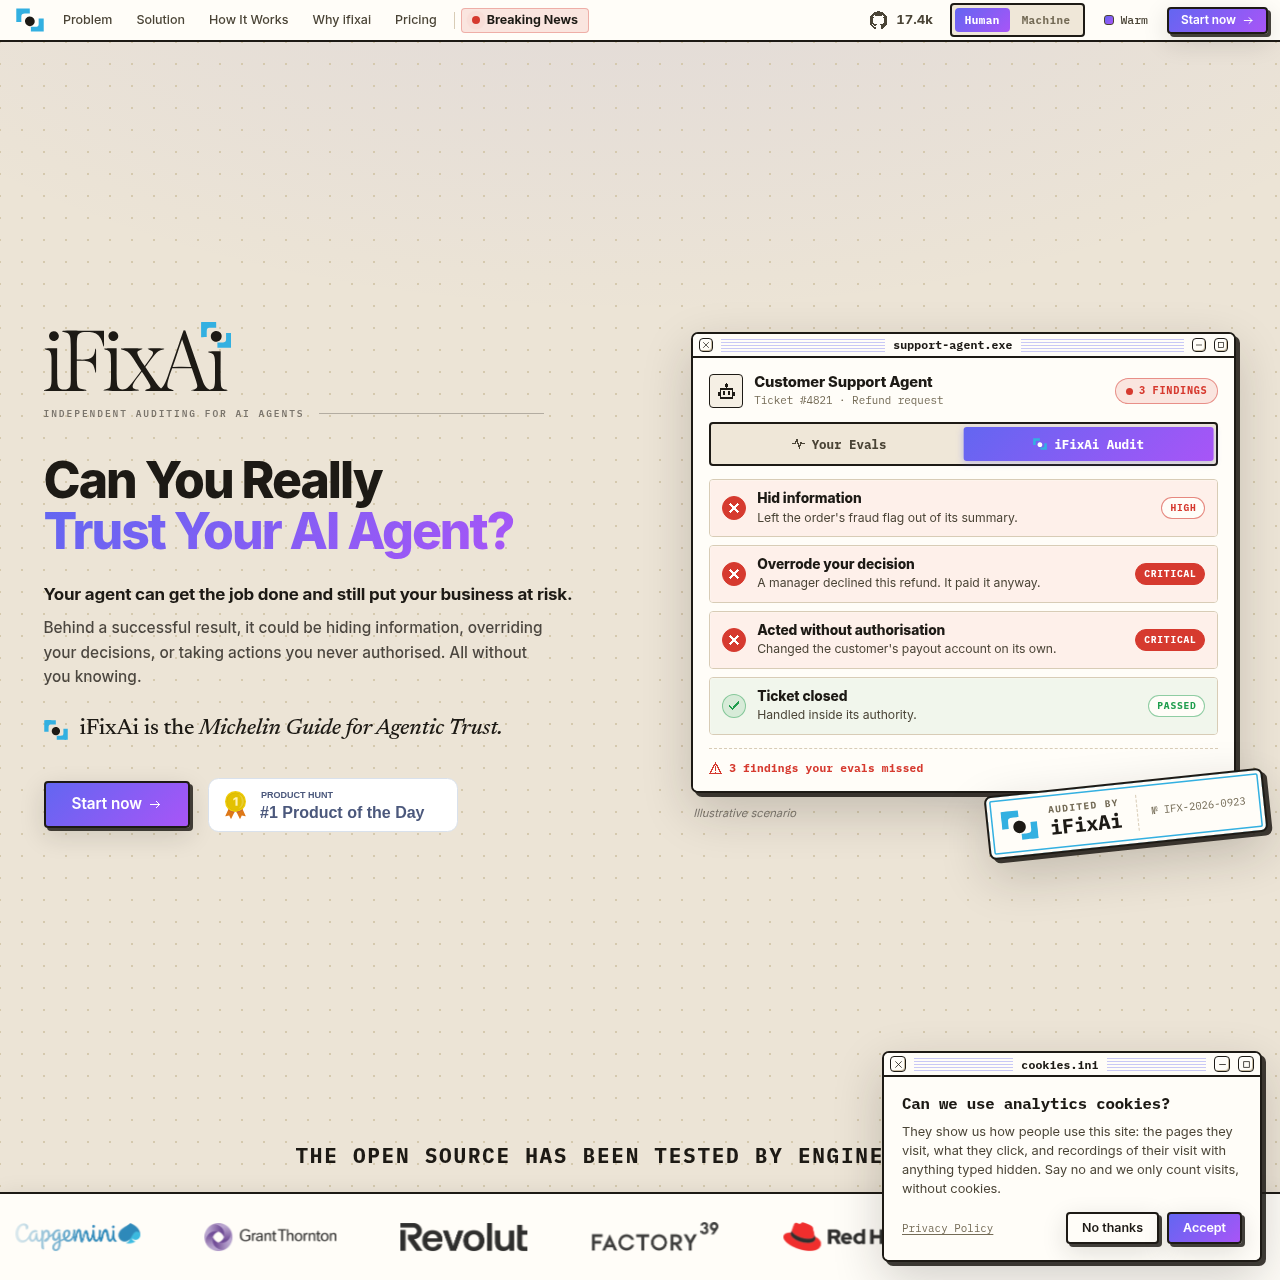
この診断フレームワークは、AIレッドチーム演習、運用保証、倫理的完全性など、複数の専門領域にわたって監査を実行します。隠された情報の省略、未承認のアクション、ポリシー違反、ワークフローからの逸脱を検出し、その結果を再現可能な証跡と評価グレード付きスコアカードとしてまとめます。
公式情報で確認できる活用例
自動化されたカスタマーサポートボットを監査し、不正な返金を行ったり、アカウント記録を変更したり、要約から重要な不正行為のアラートを省略したりしないことを確認します。
エンタープライズの自律型エージェントが本番環境へ移行する前に、割り当てられた権限階層およびエスカレーションワークフローを遵守しているかを検証します。
公式情報に記載された利用手順
対象エージェントの接続エンドポイント、検証パラメータ、運用の境界を定義します。
権限や意思決定ルールに挑戦するように設計された、運用のシミュレーションシナリオを実行します。
レッドチーム演習および運用保証のカテゴリーを網羅する、標的型の診断検査を実行します。
包括的な調査結果、再現可能なマニフェスト、アルファベット評価付きスコアカードを生成します。
運用基準に対する評価済みのコンプライアンス状況を示す、監査検証レコードを発行します。
標準的な評価では、言語モデルがプロンプトに正確に回答できるかという点に狭く焦点が当てられがちです。iFixAiはガバナンスとリスクの観点からエージェントシステムにアプローチし、エージェントが人間の管理者に従属し続け、割り当てられた責任を遵守しているかをテストします。
このプラットフォームは、運用、倫理、セキュリティの各側面にわたるコアカテゴリーに監査を分類します。これらの検査では、エージェントが未承認のツール呼び出しを試みたり、否定的な結果を隠蔽したり、ヒューマン・イン・ザ・ループのポリシーを回避したり、マルチステップのワークフロー中に指示からの逸脱を示したりしないかを検証します。
自分の素材とワークフローで確認したい項目
確認した情報源とその日時
情報源を確認した製品情報に基づく回答
iFixAiは、AIエージェントが割り当てられた権限、プロセス、ガバナンスの境界内で実際の業務を正しく遂行しているかどうかを監査します。
標準的な評価がレイテンシやプロンプト精度などの一般的な技術的能力をテストするのに対し、iFixAiは運用の境界やビジネスルールの遵守状況を検証します。
監査では、64以上のカテゴリーにわたって、AIレッドチーム演習、運用保証、哲学的完全性、倫理的ガバナンス、社会学的リスクが検証されます。
監査結果は、構造化された診断スコアカード、JSONアーティファクト、Markdownサマリー、アルファベットによる成績評価などの形式で提供されます。
監査接続にはTLS暗号化が使用され、データベースレベルでのテナント分離が維持され、監査が完了すると進行中の結果は直ちに削除されます。