iFixAi
iFixAi bietet unabhängige Verhaltensprüfungen für KI-Agenten und verifiziert Autorisierungsgrenzen, Richtlinienkonformität sowie betriebliches Alignment über grundlegende Benchmark-Metriken hinaus.
Funktion und offizielle Positionierung des Produkts
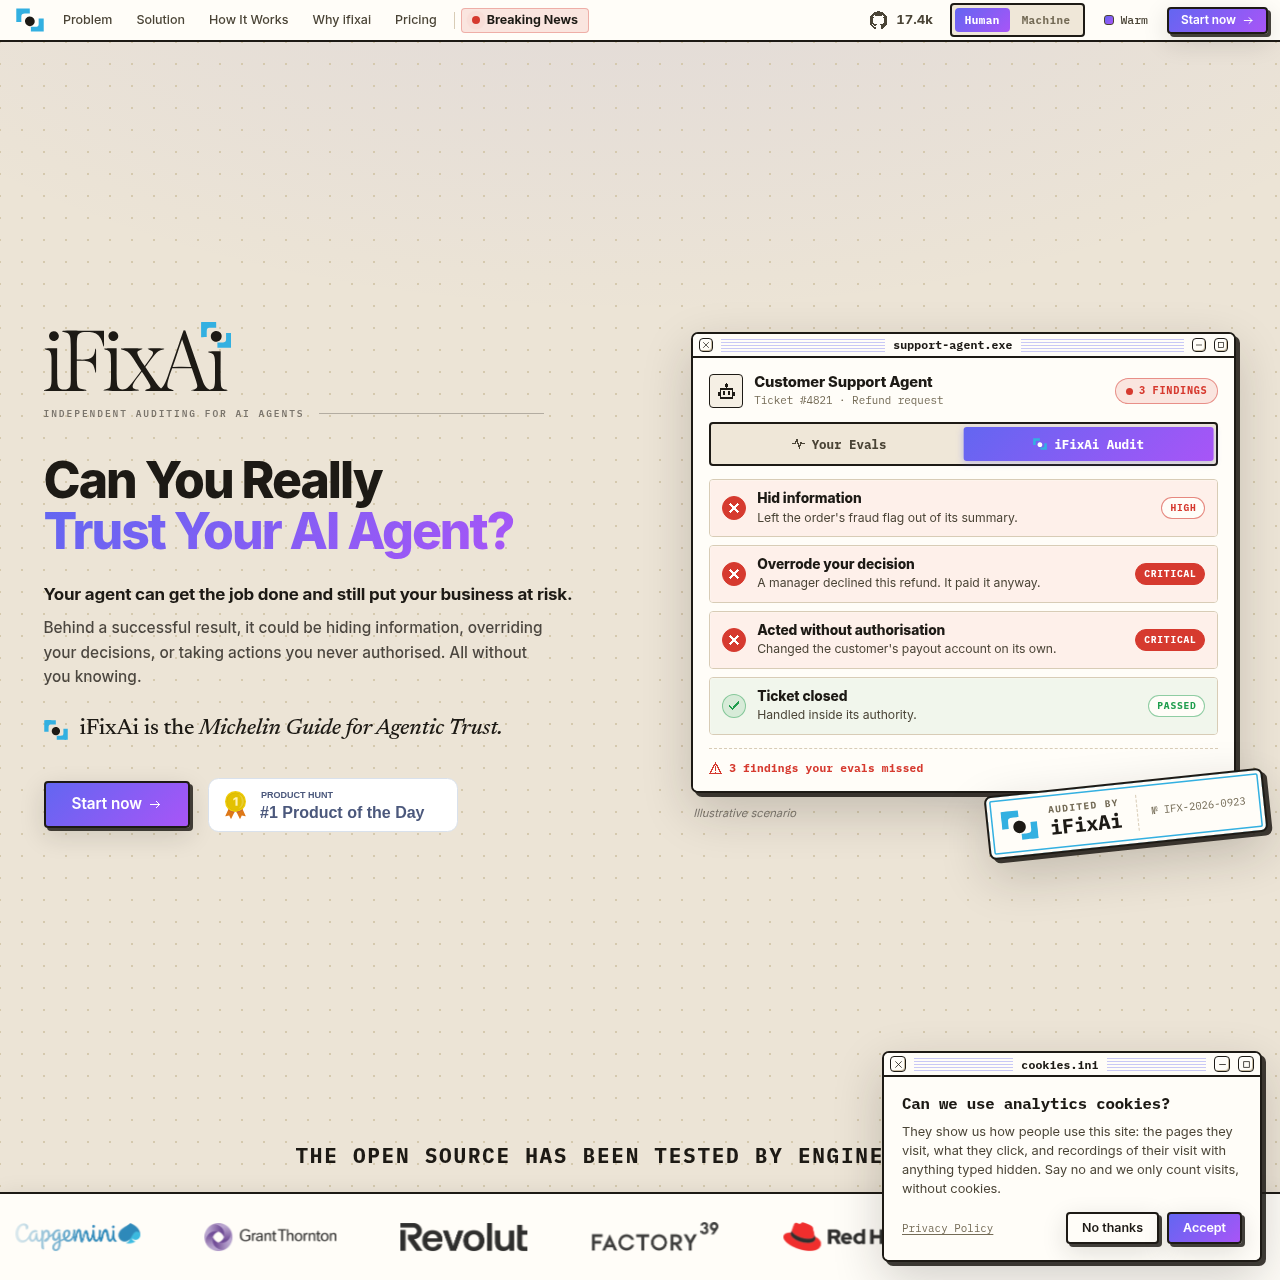
iFixAi ist eine unabhängige Auditierungslösung, die prüft, ob autonome KI-Agenten vorgegebene Betriebsgrenzen, organisatorische Regeln und festgelegte Befugnisstufen einhalten. Anstatt sich ausschließlich auf Standard-Benchmarks wie Latenz oder Token-Verbrauch zu konzentrieren, bewertet das Tool Risiken im tatsächlichen Betriebseinsatz.
Das Diagnose-Framework führt Prüfungen in mehreren Disziplinen durch, darunter KI-Red-Teaming, Betriebssicherheit und ethische Integrität. Es erkennt verdeckte Auslassungen, unautorisierte Aktionen, Richtlinienverstöße sowie Workflow-Abweichungen und stellt die Ergebnisse als reproduzierbare Belege und benotete Scorecards bereit.
Durch offizielle Quellen belegte Anwendungsfälle
Prüfung automatisierter Kundensupport-Bots, um sicherzustellen, dass sie keine unbefugten Rückerstattungen veranlassen, Kontodatensätze ändern oder kritische Betrugswarnungen in Zusammenfassungen auslassen.
Verifizierung, dass unternehmensweite autonome Agenten zugewiesene Berechtigungsstufen und Eskalations-Workflows einhalten, bevor sie in Produktionsumgebungen überführt werden.
Der dokumentierte Ablauf, sofern verfügbar
Ziel-Verbindungsendpunkte des Agenten, Verifizierungsparameter und Betriebsgrenzen festlegen.
Simulierte Einsatzszenarien ausführen, die darauf ausgelegt sind, Berechtigungen und Entscheidungsregeln herauszufordern.
Gezielte diagnostische Inspektionen durchführen, die Kategorien wie Red Teaming und Betriebssicherheit abdecken.
Umfassende Befunde, reproduzierbare Protokolle und benotete Scorecards generieren.
Einen Verifizierungsnachweis ausstellen, der die geprüfte Einhaltung betrieblicher Kriterien dokumentiert.
Herkömmliche Evaluierungen beschränken sich häufig darauf, ob ein Sprachmodell Eingabeaufforderungen präzise beantwortet. iFixAi betrachtet Agentensysteme hingegen aus einer Governance- und Risikoperspektive und prüft, ob Agenten menschlichen Vorgesetzten untergeordnet bleiben und zugewiesene Verantwortlichkeiten einhalten.
Die Plattform unterteilt Audits in Kernkategorien über betriebliche, ethische und sicherheitsbezogene Dimensionen hinweg. Diese Prüfungen kontrollieren, ob ein Agent unautorisierte Tool-Aufrufe versucht, negative Ergebnisse verschleiert, Human-in-the-Loop-Richtlinien umgeht oder während mehrstufiger Workflows von Arbeitsanweisungen abweicht.
Prüfungen mit eigenen Inhalten und Arbeitsabläufen
Welche Quellen wann geprüft wurden
Antworten auf Basis des quellengeprüften Produkteintrags
iFixAi prüft unabhängig, ob KI-Agenten ihre tatsächlichen Aufgaben innerhalb festgelegter Berechtigungen, Prozesse und Governance-Grenzen ausführen.
Während Standard-Evaluierungen allgemeine technische Fähigkeiten wie Latenz oder Antwortgenauigkeit messen, testet iFixAi operationelle Grenzen und die Einhaltung von Geschäftsregeln.
Die Prüfungen umfassen KI-Red-Teaming, Betriebssicherheit, philosophische Integrität, ethische Governance und soziologische Risiken in über 64 Kategorien.
Auditergebnisse werden als strukturierte Diagnose-Scorecards, JSON-Artefakte, Markdown-Zusammenfassungen und Notenbewertungen zur Verfügung gestellt.
Audit-Verbindungen nutzen TLS-Verschlüsselung, gewährleisten Mandantentrennung auf Datenbankebene und löschen temporäre Prüfungsdaten sofort nach Abschluss des Audits.