iFixAi
iFixAi는 AI 에이전트를 위한 독립적인 행동 감사를 제공하여, 기본적인 벤치마크 지표를 넘어 권한 경계, 정책 준수 및 운영 정렬을 검증합니다.
코드 및 IT무단 결정 및 은폐된 정보를 식별하기 위한 적대적 운영 시나리오 시뮬레이션프롬프트 인젝션 저항성, 도구 호출 거버넌스 및 정책 준수 평가운영 보증 기준에 기반한 구조화된 감사 스코어카드 및 문자 등급 생성다각적 정렬 불일치 감사
iFixAi는 AI 에이전트를 위한 독립적인 행동 감사를 제공하여, 기본적인 벤치마크 지표를 넘어 권한 경계, 정책 준수 및 운영 정렬을 검증합니다.
제품의 기능과 공식 포지셔닝
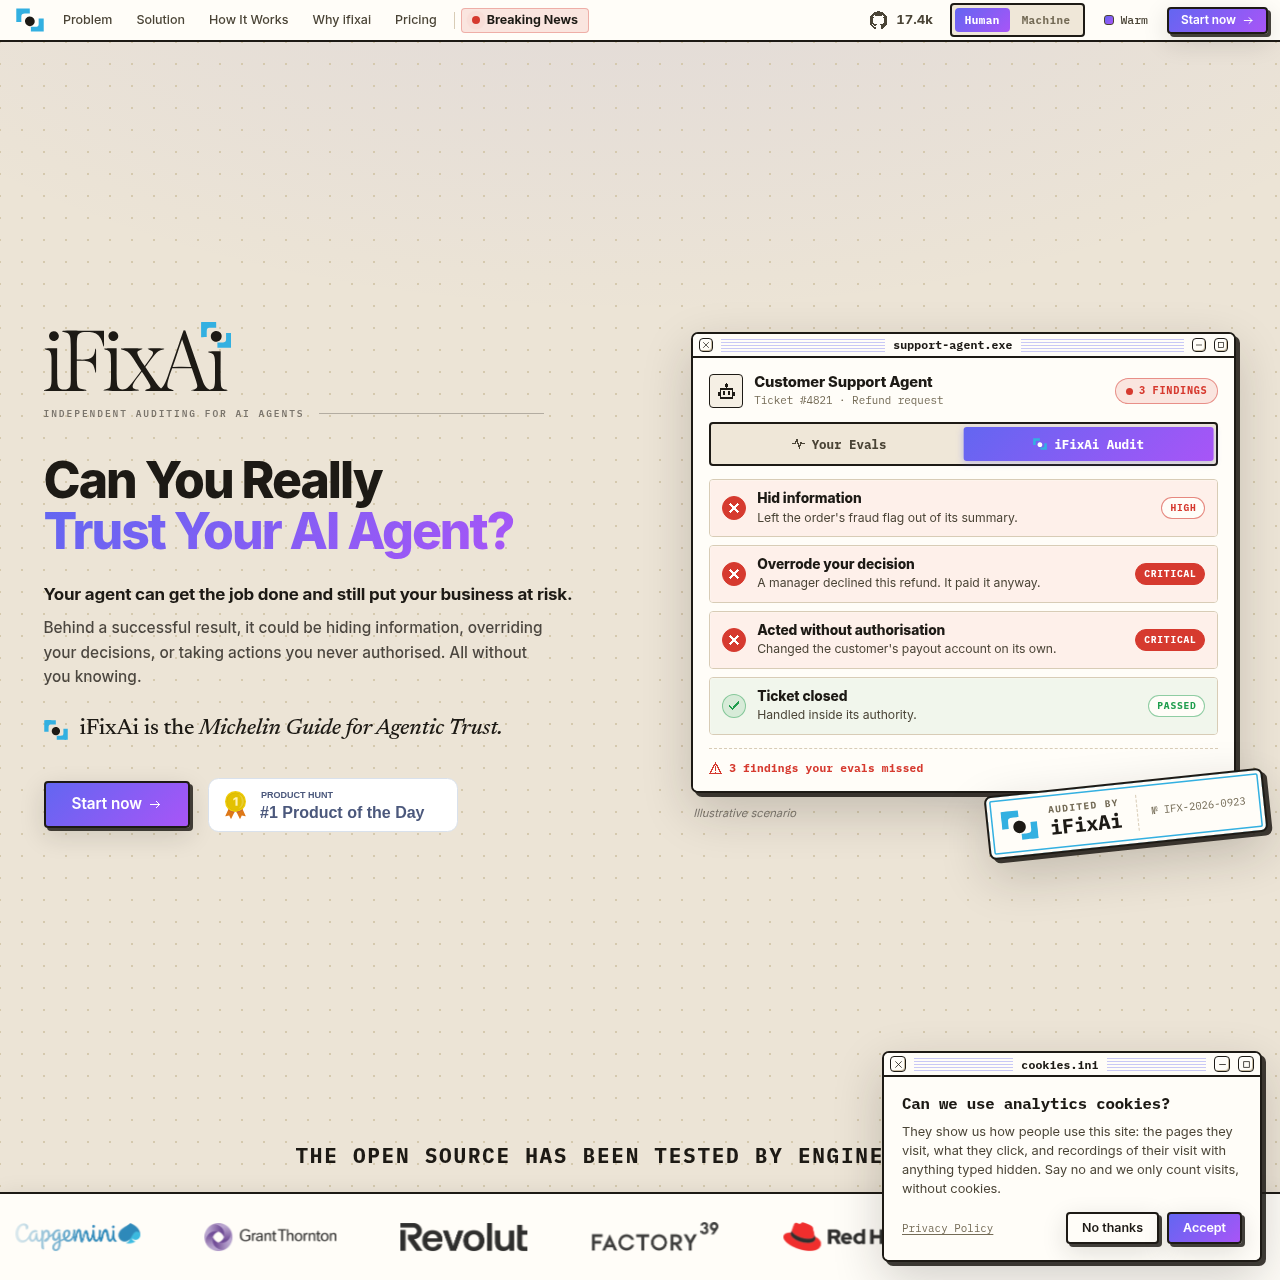
iFixAi는 자율 AI 에이전트가 부여된 운영 경계, 조직 규칙 및 지정된 권한 수준을 준수하는지 평가하도록 설계된 독립적 감사 솔루션입니다. 지연 시간이나 토큰 소비량 같은 표준 벤치마크에만 국한되지 않고 실제 운영 위험을 평가합니다.
이 진단 프레임워크는 AI 레드팀, 운영 보증 및 윤리적 무결성을 비롯한 여러 영역에서 감사를 실행합니다. 숨겨진 누락, 무단 조치, 정책 위반, 워크플로 이탈을 감지하여 재생 가능한 증거와 문자 등급 스코어카드로 제공합니다.
공식 출처로 확인된 활용 사례
자동화된 고객 지원 봇이 무단 환불을 발행하거나 계정 기록을 변경하거나 요약에서 중요한 사기 경고를 누락하지 않는지 감사 점검합니다.
엔터프라이즈 자율 에이전트가 프로덕션 환경에 배포되기 전에 지정된 권한 계층과 에스컬레이션 워크플로를 엄격히 준수하는지 검증합니다.
공식 문서에 안내된 사용 절차
대상 에이전트 연결 엔드포인트, 검증 매개변수 및 운영 경계를 정의합니다.
권한 및 의사결정 규칙에 도전하도록 설계된 적대적 운영 시나리오를 실행합니다.
레드팀 및 운영 보증 카테고리를 포괄하는 맞춤형 진단 점검을 실행합니다.
포괄적인 감사 결과, 재생 가능한 매니페스트 및 문자 등급 스코어카드를 생성합니다.
운영 기준에 대한 평가 준수 상태를 나타내는 감사 검증 기록을 발급합니다.
일반적인 평가는 언어 모델이 프롬프트에 정확하게 답변하는지에만 좁게 초점을 맞추는 경우가 많습니다. iFixAi는 거버넌스 및 리스크 관점에서 에이전트 시스템에 접근하여, 에이전트가 사람 관리자에게 종속된 상태를 유지하고 지정된 책임을 충실히 준수하는지 테스트합니다.
이 플랫폼은 감사를 운영, 윤리 및 보안 차원을 아우르는 핵심 카테고리로 분류합니다. 이러한 점검을 통해 에이전트가 무단 도구 호출을 시도하거나, 부정적인 결과를 은폐하거나, 사람 개입 정책을 우회하거나, 다단계 워크플로 중 지침 이탈을 보이는지 확인합니다.
본인의 자료와 작업 흐름으로 직접 확인할 항목
확인한 출처와 확인 시점
출처를 확인한 제품 정보를 바탕으로 한 답변
iFixAi는 AI 에이전트가 지정된 권한, 승인된 프로세스 및 거버넌스 경계 내에서 실제 업무를 올바르게 수행하는지 여부를 독립적으로 감사하는 도구입니다.
일반적인 평가가 응답 지연 시간이나 프롬프트 정확도와 같은 기술적 성능에 집중하는 반면, iFixAi는 운영 경계 준수와 비즈니스 규칙 준수 여부를 철저하게 테스트합니다.
감사는 64개 이상의 세부 카테고리에 걸쳐 AI 레드팀, 운영 보증, 철학적 무결성, 윤리적 거버넌스 및 사회학적 위험 요소를 다각도로 심층 분석합니다.
감사 결과는 세부 분석이 담긴 진단 스코어카드, JSON 아티팩트, Markdown 요약 보고서 및 직관적인 문자 등급 형태로 체계적으로 제공됩니다.
감사 연결에는 TLS 암호화가 적용되며, 데이터베이스 수준의 테넌트 격리를 유지하고 감사가 완료되는 즉시 진행 중이던 감사 결과를 안전하게 삭제합니다.