Invofox Self Serve
Invofox Self Serve 是一款自动化文档处理 API,能够将 PDF 文件和图像解析为结构化 JSON 和 Markdown 格式,具备文档智能分类、表格数据提取以及符合零数据保留合规要求等核心功能。
组织与自动化自动化从文档中提取结构化键值对和表格数据通过智能代理审查机制重新检查并自我修正低置信度字段通过 REST 端点、Webhook 或轮询交付提取结果通过分块处理大型多页 PDF 文件且不会发生超时
Invofox Self Serve 是一款自动化文档处理 API,能够将 PDF 文件和图像解析为结构化 JSON 和 Markdown 格式,具备文档智能分类、表格数据提取以及符合零数据保留合规要求等核心功能。
产品用途与官方定位
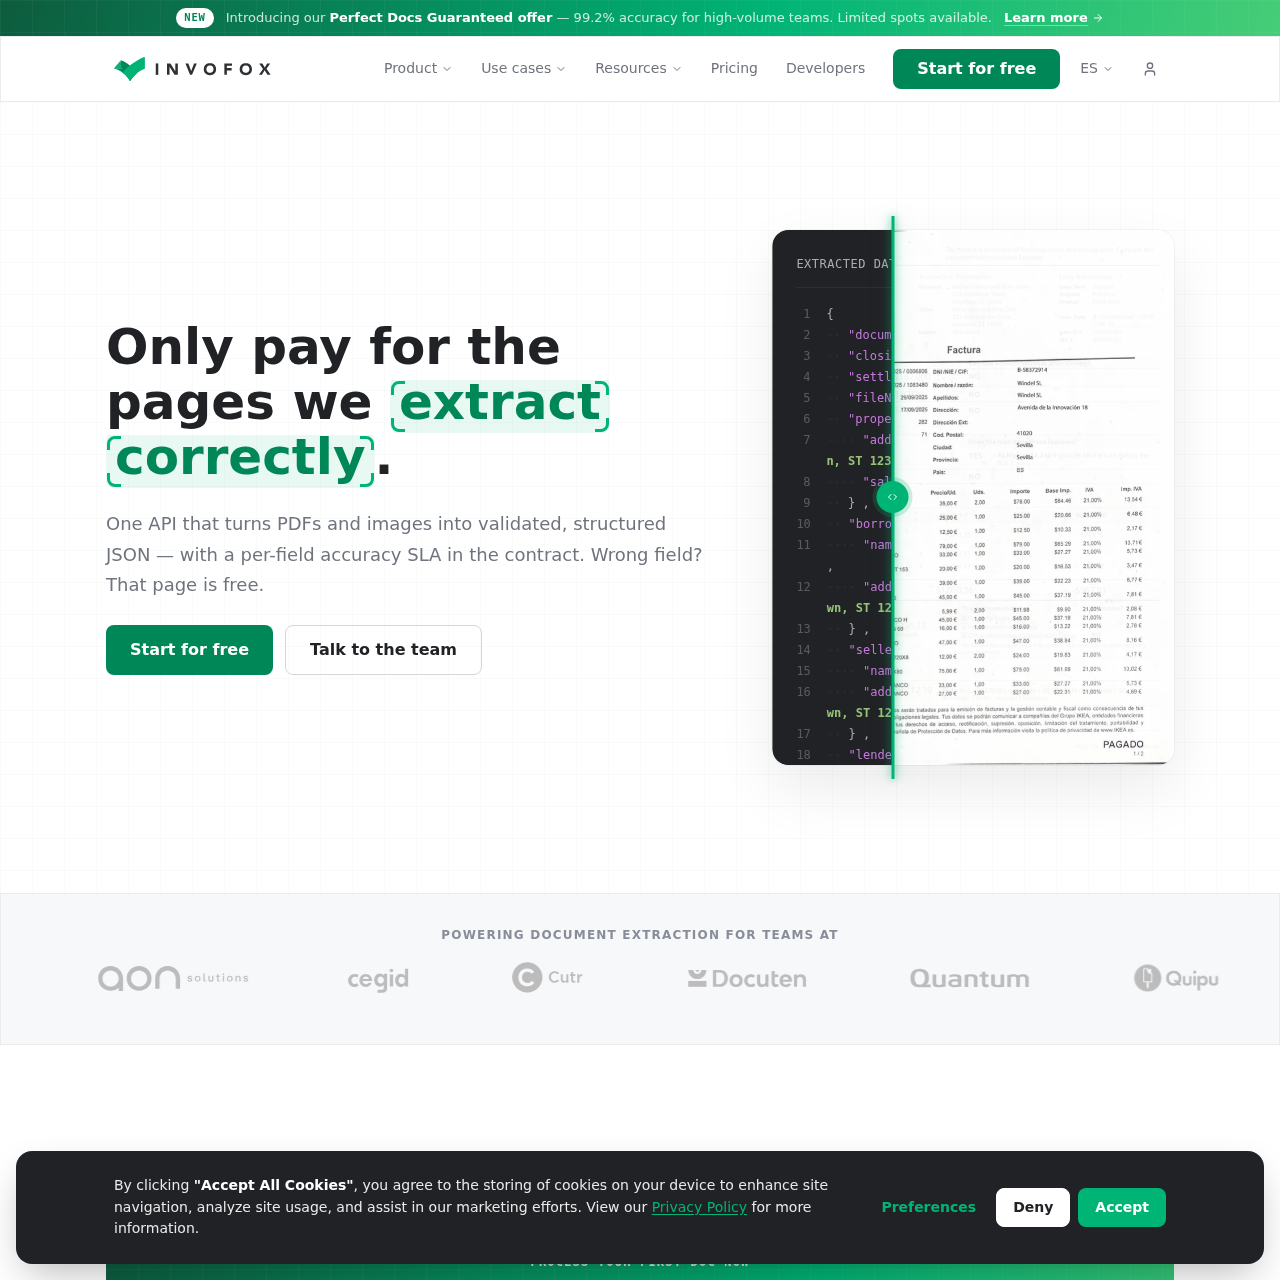
Invofox 提供统一的文档提取 API,旨在将非结构化 PDF、扫描页面和图像转换为标准化的 JSON 数据集和 Markdown 格式,以便下游大语言模型与数据库应用使用。
该系统涵盖了整个数据摄取生命周期,包括文档纠偏、双通道 OCR、文档拆分、分类、表格数据对账以及自动化置信度评分机制。
有官方来源支持的使用场景
从供应商发票中提取供应商详细信息、税务标识符、日期和行项目总计并生成结构化 JSON 载荷。
从抵押贷款表格和最终结案披露文件(Closing Disclosures)中解析借款人信息、贷款条款和结算金额。
自动将批量上传的混合 PDF 文件(如包含银行对账单和工资单的混合包)分离为独立的已分类记录。
从标准员工工资单中准确提取雇主数据、员工识别号码以及各项薪酬总额。
官网提供的使用流程
注册创建平台账户并生成后续集成所需的 API 密钥凭证。
选择所需的预置标准文档模型,或者根据业务需求建立自定义模式。
通过向提取端点发送 POST 请求来传输并提交需要处理的文档文件。
直接获取或通过 Webhook 接收经过验证且符合结构模式的 JSON 或 Markdown 输出结果。
Invofox 通过顺序技术流水线处理非结构化文档上传。当系统通过 REST API 端点接收文件时,完整性检查机制会先处理受密码保护或已损坏的文件,然后再将其路由至预处理模块进行纠偏、降噪和图像锐化处理。
文本和结构化元素通过双通道 OCR 系统进行解析,该系统在转录文本的同时隔离版面地理布局。多页批处理文件由自动页面拆分器进行分割,随后由分类模型对文档类型归类。提取的表格、货币和日期随后被标准化,并根据业务规则进行交叉校验,最终连同置信度分数和区域溯源信息通过 Webhook 或轮询返回。
用自己的素材和工作流完成验证
核对了哪些信息以及核对时间
基于已核对产品资料的回答
Invofox 开箱即用支持发票、收据、送货单、采购订单、工资单、银行对账单、公用事业账单、身份证件、合同、税务表格以及诸如结案披露(Closing Disclosures)等美国抵押贷款表格。
用户可以通过反馈端点将人工修正结果回传给 API,系统会利用这些反馈更新流水线配置,从而有助于防止相同的错误在未来的文档处理中再次出现。
数据默认在欧盟境内进行处理,同时可根据客户要求提供美国境内的处理服务。Scale 和 Enterprise 方案可启用零数据保留模式,而本地私有化部署仅向 Enterprise 企业合约提供。
该平台支持上传 PDF 文件、扫描版文档以及包括 PNG 和 JPG 在内的常见图像格式,以供系统进行数据提取和结构化处理。
该平台原生支持使用拉丁字母书写的语言,例如英语、西班牙语、葡萄牙语、法语、意大利语和德语;对于非拉丁字母语言,则需要单独的配置调整周期。