Invofox Self Serve
Invofox Self Serve est une API de traitement automatisé de documents qui convertit les PDF et images en JSON et Markdown structurés, intégrant classification, extraction de tableaux et conformité sans rétention.
Fonction du produit et positionnement officiel
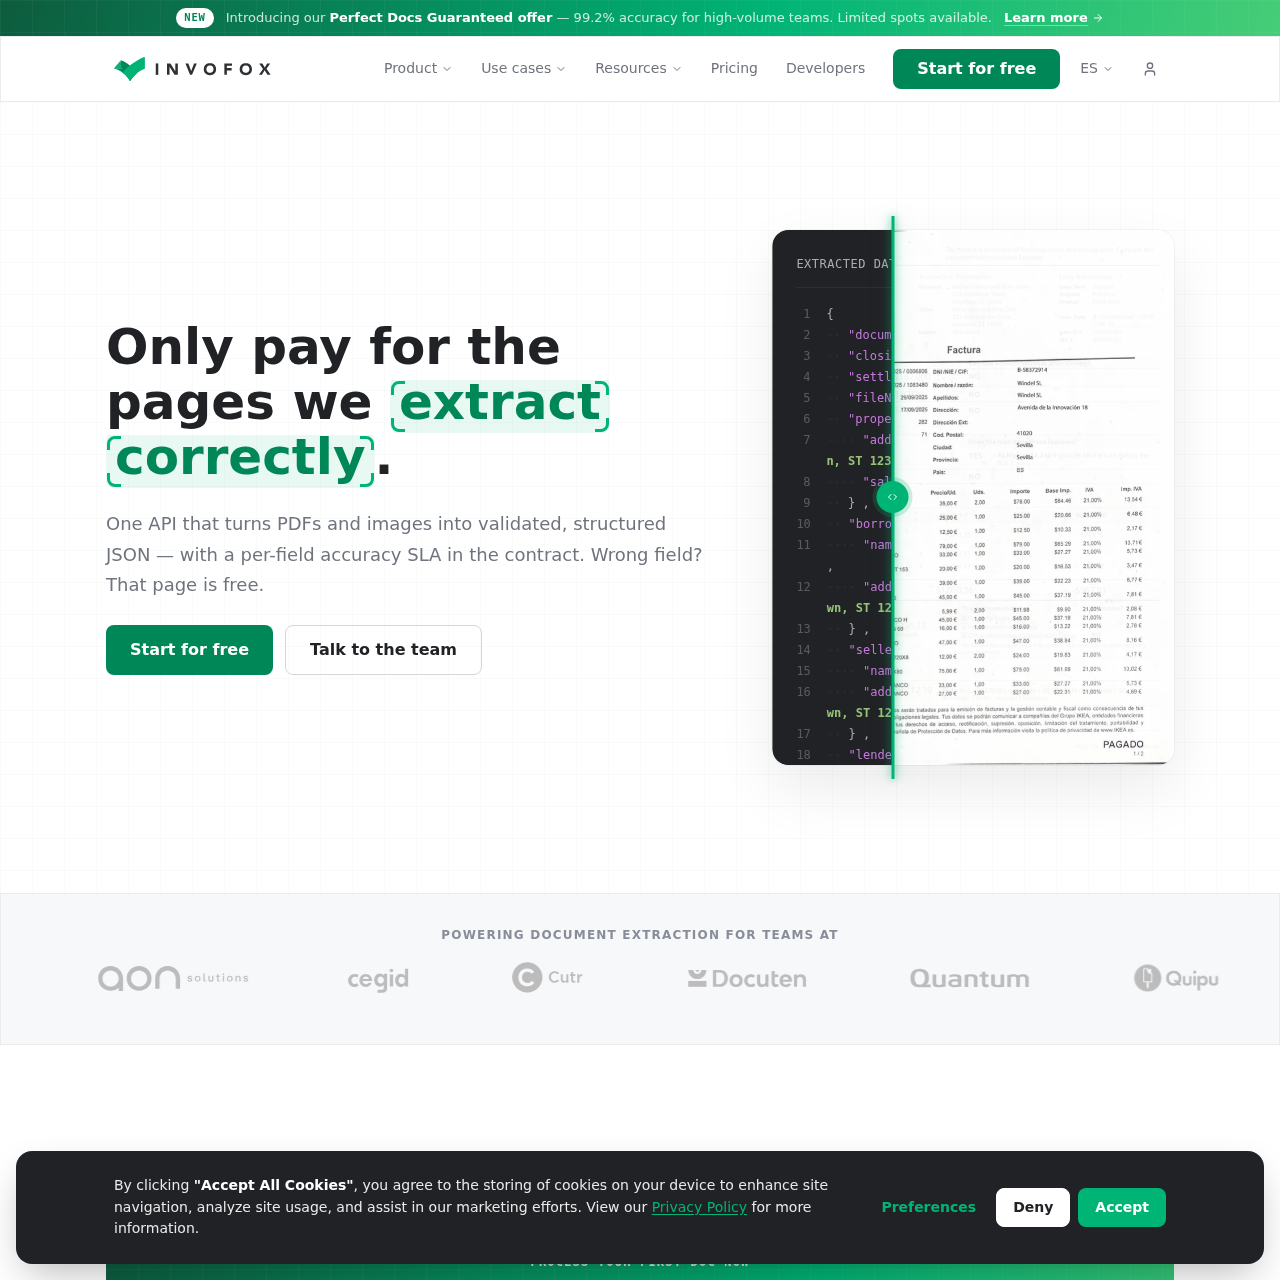
Invofox fournit une API unifiée d'extraction de documents conçue pour convertir des PDF non structurés, des pages numérisées et des images en ensembles de données JSON normalisés et en Markdown pour les applications LLM et bases de données en aval.
Le système gère l'ensemble du cycle de vie de l'ingestion, y compris le redressement des documents, l'OCR à double passe, le découpage de documents, la classification, le rapprochement tabulaire et le calcul automatisé des scores de confiance.
Cas d’usage étayés par les sources officielles
Extraction des coordonnées des fournisseurs, identifiants fiscaux, dates et totaux de lignes à partir des factures fournisseurs dans des charges utiles JSON structurées.
Analyse des informations sur les emprunteurs, des modalités de prêt et des montants de règlement à partir des formulaires hypothécaires et des déclarations de clôture.
Séparation automatique des PDF téléversés par lot contenant des fichiers mixtes tels que des relevés bancaires et des bulletins de paie en enregistrements classifiés distincts.
Extraction des données de l'employeur, des numéros d'identification des employés et des montants de rémunération à partir des bulletins de paie standard des salariés.
Le parcours documenté, lorsqu’il est disponible
Créez un compte et générez les clés d'API nécessaires.
Sélectionnez les modèles de documents standard requis ou établissez un schéma personnalisé.
Transmettez les documents via une requête POST au point de terminaison d'extraction.
Recevez la sortie JSON ou Markdown validée et conforme au schéma, directement ou via webhook.
Invofox traite les téléversements de documents non structurés à travers un pipeline technique séquentiel. Lorsque les fichiers sont reçus via le point de terminaison de l'API REST, des contrôles d'intégrité prennent en charge les fichiers protégés par mot de passe ou corrompus avant de les acheminer vers des modules de prétraitement pour le redressement, le débruitage et l'amélioration de la netteté.
Les éléments textuels et structurels sont interprétés à l'aide d'un système OCR à double passe qui isole la géographie de la mise en page tout en transcrivant le texte. Les lots multipages sont divisés par un séparateur automatique de pages, après quoi des modèles de classification catégorisent le type de document. Les tableaux, devises et dates extraits sont ensuite normalisés, vérifiés par rapport aux règles de gestion et renvoyés via webhook ou scrutation accompagnés des scores de confiance et de la provenance géographique.
Vérifications à effectuer avec vos contenus et votre flux de travail
Sources vérifiées et date de la vérification
Réponses fondées sur la fiche produit dont les sources ont été vérifiées
Invofox prend en charge les factures, reçus, bons de livraison, bons de commande, bulletins de paie, relevés bancaires, factures de services publics, pièces d'identité, contrats, formulaires fiscaux et formulaires de prêt immobilier américains tels que les closing disclosures.
Les utilisateurs peuvent soumettre des corrections au point de terminaison de rétroaction, ce qui met à jour la configuration du pipeline afin d'éviter que la même erreur ne se reproduise sur les futurs documents.
Le traitement s'effectue par défaut au sein de l'Union européenne, avec un traitement aux États-Unis disponible sur demande. Les forfaits Scale et Enterprise peuvent opter pour le mode sans rétention, tandis que les déploiements sur site sont réservés aux contrats Enterprise.
La plateforme accepte les fichiers PDF, les documents numérisés ainsi que les formats d'image, notamment PNG et JPG, pour l'extraction.
La plateforme prend nativement en charge les langues à alphabet latin telles que l'anglais, l'espagnol, le portugais, le français, l'italien et l'allemand, tandis que les écritures non latines nécessitent une période de configuration distincte.