Invofox Self Serve
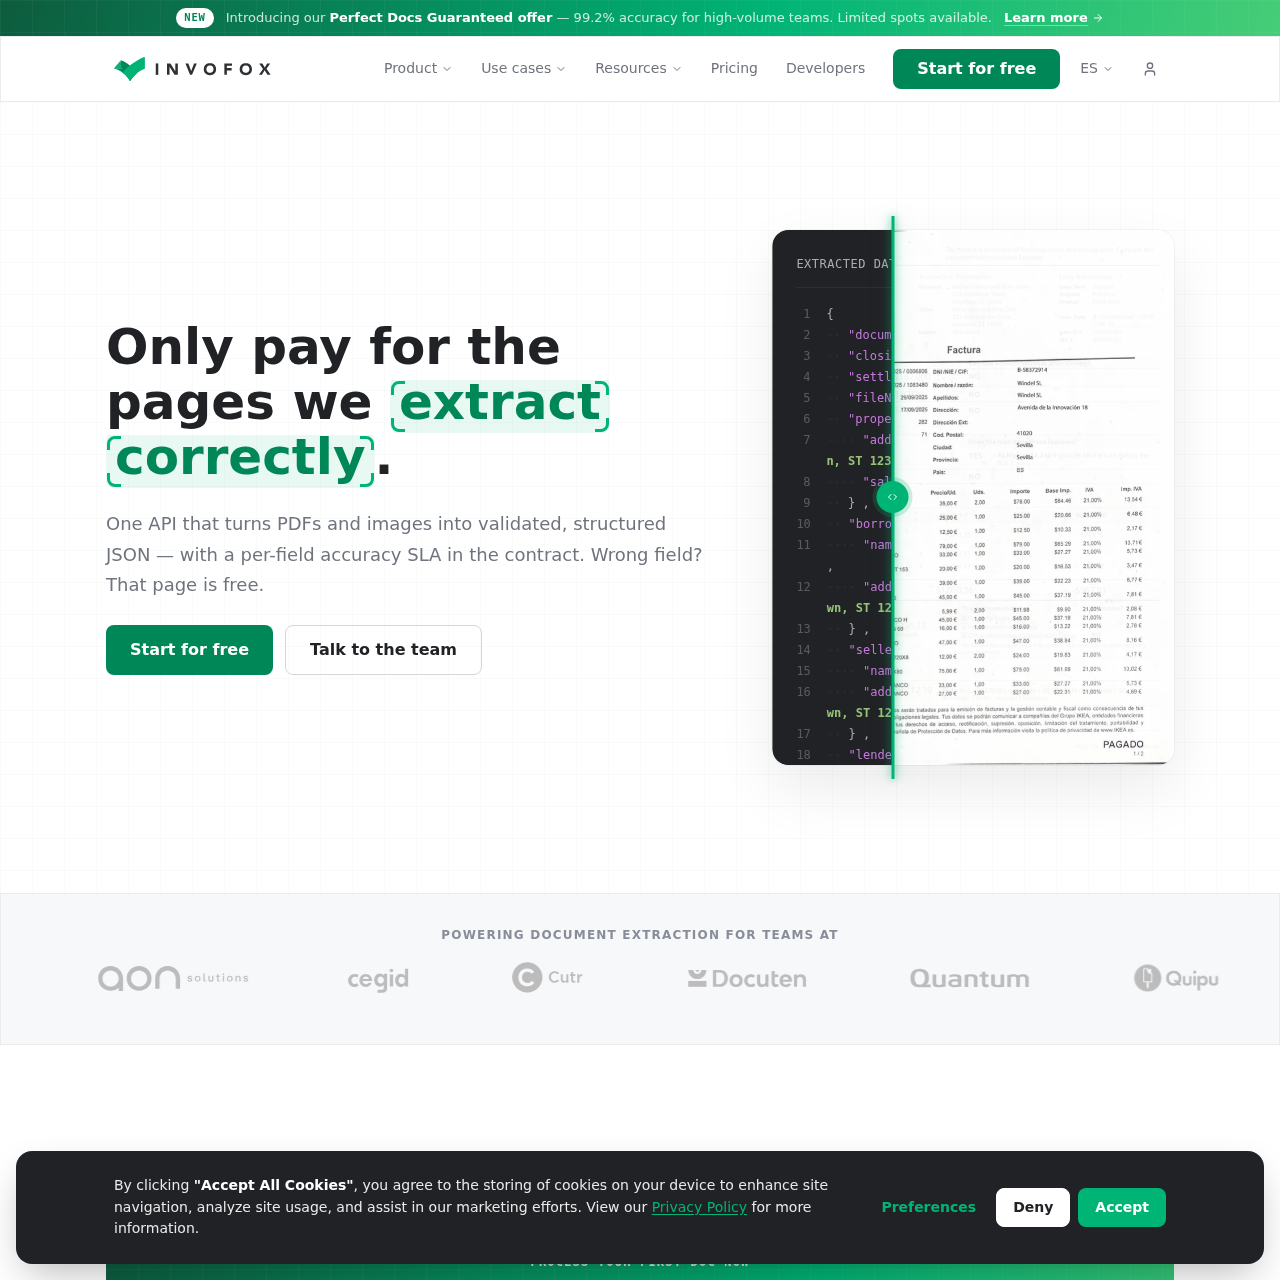
Invofox Self Serve es una API de procesamiento automatizado de documentos que analiza archivos PDF e imágenes para generar JSON y Markdown estructurados, con clasificación, extracción de tablas y cumplimiento de retención cero.
Qué hace el producto y cómo se presenta oficialmente
Invofox proporciona una API unificada de extracción de documentos diseñada para convertir archivos PDF no estructurados, páginas escaneadas e imágenes en conjuntos de datos JSON normalizados y Markdown para aplicaciones posteriores de LLM y bases de datos.
El sistema gestiona todo el ciclo de ingesta, incluyendo enderezado de documentos, OCR de doble pasada, división de documentos, clasificación, conciliación tabular y puntuación de confianza automatizada.
Casos de uso respaldados por fuentes oficiales
Extracción de detalles de proveedores, identificadores fiscales, fechas y totales de líneas de detalle de facturas de proveedores en cargas útiles JSON estructuradas.
Extracción de información del prestatario, condiciones del préstamo y valores de liquidación a partir de formularios de hipotecas y declaraciones de cierre (Closing Disclosures).
Separación automática de archivos PDF cargados en lote que contienen documentos mixtos, como extractos bancarios y recibos de nómina, en registros clasificados independientes.
Extracción de datos del empleador, números de identificación de empleados y totales de remuneración a partir de recibos de nómina estándar.
El proceso documentado, cuando está disponible
Cree una cuenta y genere las claves de API necesarias.
Seleccione los modelos de documentos estándar requeridos o defina un esquema personalizado.
Transmita documentos a través de una solicitud POST al endpoint de extracción.
Reciba la salida validada y mapeada al esquema en formato JSON o Markdown directamente o mediante webhook.
Invofox procesa cargas de documentos no estructurados a través de un flujo técnico secuencial. Cuando los archivos se reciben mediante el endpoint de la API REST, comprobaciones de integridad gestionan archivos protegidos por contraseña o dañados antes de dirigirlos a módulos de preprocesamiento para enderezado, eliminación de ruido y enfoque.
Los elementos textuales y estructurales se interpretan utilizando un sistema OCR de doble pasada que aísla la disposición geográfica mientras transcribe el texto. Los lotes de varias páginas se dividen mediante un divisor de páginas automatizado, tras lo cual los modelos de clasificación categorizan el tipo de documento. Las tablas, monedas y fechas extraídas se normalizan, se contrastan con reglas de negocio y se devuelven mediante webhook o sondeo (polling), acompañadas de puntuaciones de confianza y procedencia regional.
Comprobaciones con tus propios materiales y flujo de trabajo
Qué fuentes se revisaron y cuándo
Respuestas basadas en el registro de producto con fuentes verificadas
Invofox admite facturas, recibos, albaranes, órdenes de compra, recibos de nómina, extractos bancarios, facturas de servicios públicos, documentos de identidad, contratos, formularios tributarios y formularios hipotecarios de EE. UU., como las declaraciones de cierre.
Los usuarios pueden enviar correcciones al endpoint de retroalimentación, lo que actualiza la configuración del flujo para ayudar a evitar que el mismo error se repita en documentos futuros.
El procesamiento se realiza de forma predeterminada dentro de la Unión Europea, con procesamiento en EE. UU. disponible previa solicitud. Los planes Scale y Enterprise pueden activar el modo de retención cero, mientras que los despliegues on-premise están limitados a contratos Enterprise.
La plataforma admite archivos PDF, documentos escaneados y formatos de imagen como PNG y JPG para su extracción.
La plataforma es compatible de forma nativa con idiomas de escritura latina como español, inglés, portugués, francés, italiano y alemán, mientras que las escrituras no latinas requieren un periodo de configuración específico.