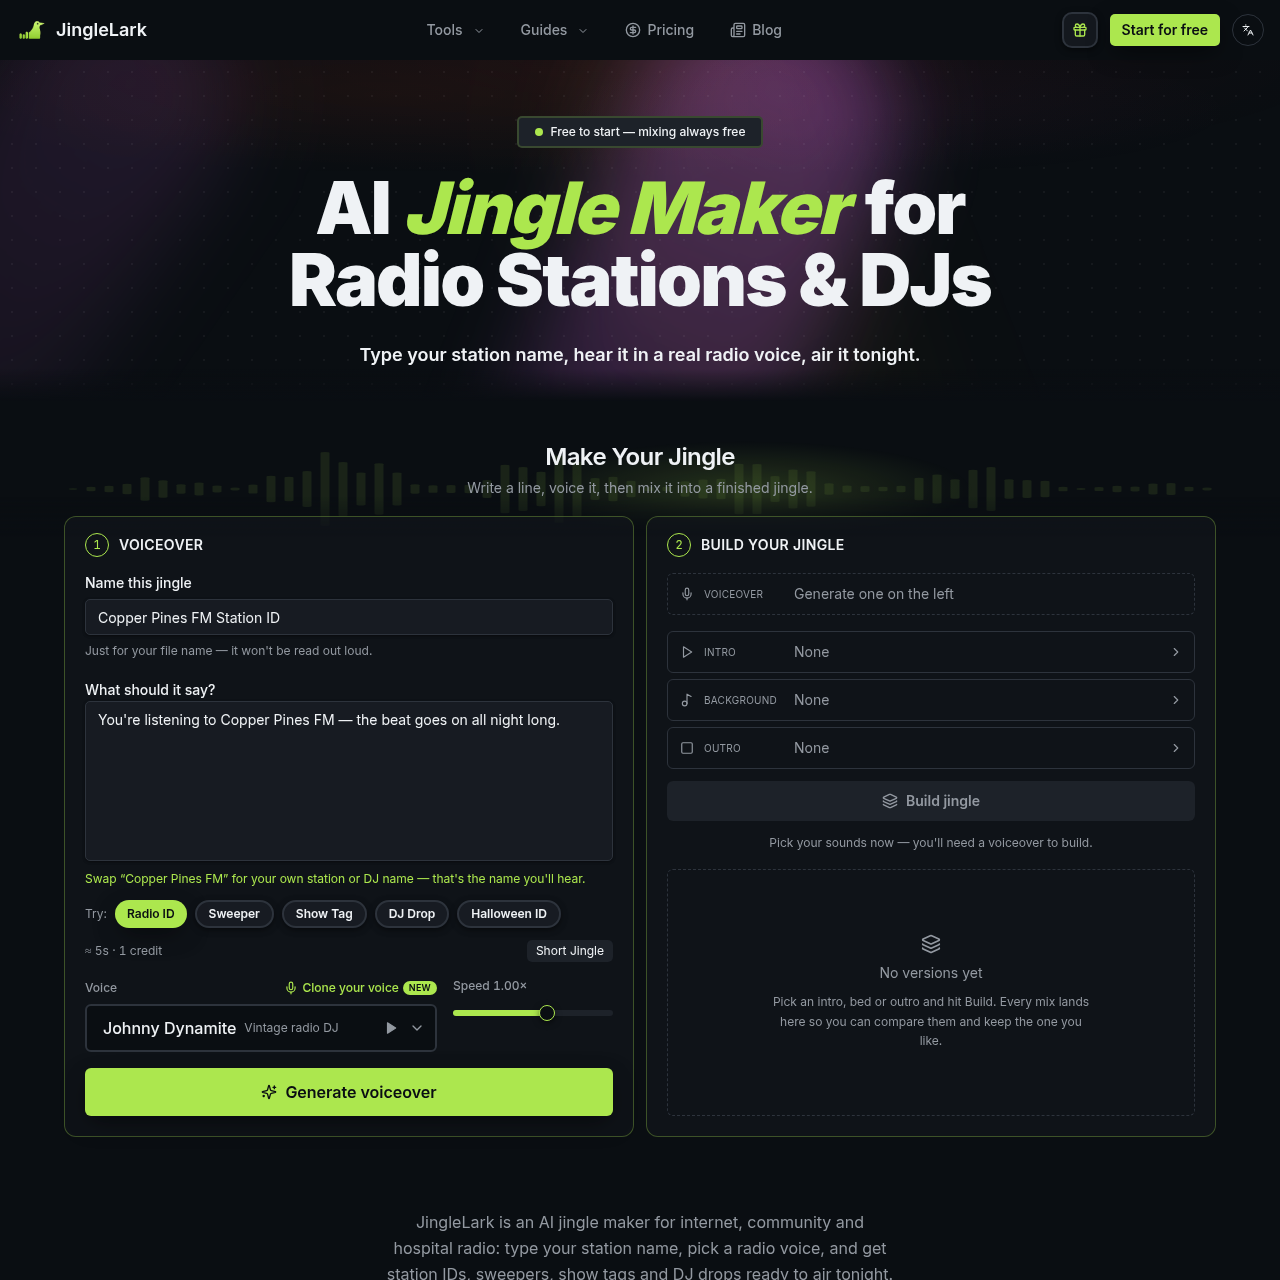
JingleLark создает речевое радиооформление из набранных сценариев, выбранных голосов и элементов сведения, таких как интро, фоновые подложки и аутро.
АудиоСоздавать речевые радиоголосовые…Сводить голосовые озвучки с интро,…Настраивать скорость голоса от 0,7× до…Создавать клонированные голоса из…генератор идентификаторов радиостанции на основе ИИгенератор радиоголосовых озвучекгенератор джинглов на основе ИИрадиоджинглырадиоимиджингDJ-дропы
Добавлено в AIToolly
Что такое JingleLark? Обзор продукта
Назначение продукта и его официальное позиционирование
JingleLark (jinglelark.com) — это генератор идентификаторов радиостанции и радиоголосовых озвучек на основе ИИ для небольших радиостанций, включая интернет-радиостанции, общественные и больничные радиостанции. Вы платите только за голос; сведение, повторное сведение и скачивание бесплатны. Введите название своей станции или сценарий, выберите радиоголос и объедините его с интро, музыкальной подложкой и аутро, чтобы создать готовый к эфиру идентификатор станции, свипер, тег шоу или DJ-дроп. Экспортируйте готовое аудио в формате MP3 или WAV. Разовые пакеты кредитов начинаются от $14.90, подписка не требуется.
JingleLark — это инструмент на базе ИИ для создания речевых идентификаторов станции, свейперов, тегов шоу, диджейских вставок и другого радиозвука из сценариев, написанных пользователем.
Его рабочий процесс объединяет сгенерированные озвучки с выбираемыми звуковыми элементами, а шаблоны и дополнительное клонирование голоса поддерживают повторяющиеся форматы станции и ведущих.
Для чего можно использовать JingleLark?
Сценарии, подтверждённые официальными источниками
Оформление небольшой станции
Создание идентификаторов станции, свейперов, рекламных блоков спонсоров и другого речевого оформления для интернет-, общественного или больничного радио.
Брендинг ведущего и шоу
Подготовка интро шоу, тегов ведущего и отбивок сегментов с выбранным радиоголосом или разрешенным клонированным голосом.
Диджейские вставки
Создание речевых диджейских вставок, именных тегов и открытий сетов по имени диджея, сценарию и выбранному голосу.
Как использовать JingleLark
Описанный в документации процесс, если он доступен
1
Написать текст
Введите сценарий станции, ведущего или диджея либо начните с шаблона Radio ID, Sweeper, Show Tag или DJ Drop.
2
Сгенерировать озвучку
Выберите эфирную роль или доступный клонированный голос, затем создайте речевую версию сценария.
3
Собрать и скачать
Добавьте интро, фоновую подложку и аутро, соберите микс, сравните версии и скачайте выбранный результат в формате MP3 или WAV.
Рабочий процесс работы с голосом и миксом
Продукт разделяет генерацию голоса и сборку микса. Сначала набранный сценарий озвучивается выбранным голосом, после чего полученную озвучку можно объединить со звуковыми элементами, ориентированными на радиостанции.
Документированный процесс сведения включает дакинг по принципу сайдчейна под голосом, обрезку тишины внутри звуковых эффектов и выравнивание громкости до −16 LUFS.
Роли голосов включают винтажного диджея, ведущего ночного эфира, энергичного ведущего, британского ведущего и теплого рассказчика.
Документированная библиотека содержит 45 интро, 28 фоновых подложек и 15 аутро.
Скорость голоса можно настраивать от 0,7× до 1,2×.
Для клонирования голоса принимается запись или загрузка продолжительностью от 8 до 30 секунд.
Цены JingleLark
Коммерческие сведения, предоставленные пользователями или администраторами
creditsfreemium
USD 14.9
Цены могут меняться. Перед покупкой проверьте актуальный тариф и условия оплаты на официальном сайте.
Что проверить перед выбором JingleLark
Проверки на собственных материалах и рабочих процессах
Убедитесь, что доступные роли голосов и библиотека звуков соответствуют предполагаемому формату станции.
Проверьте, укладываются ли запланированные сценарии в документированный лимит 900 символов и дают ли нужную продолжительность речи.
Проверьте звучание сценариев не на английском языке, прежде чем создавать большую серию идентификаторов станции.
До создания клонированного голоса проверьте разрешения на клонирование и условия записи.
Ответы на основе карточки продукта с проверенными источниками
Какой радиозвук может создавать JingleLark?+
Документированные шаблоны и примеры охватывают идентификаторы станции, свейперы, теги шоу, диджейские вставки, интро шоу, новостные отбивки и рекламные блоки спонсоров.
Можно ли добавлять музыку или звуковые элементы к озвучке?+
Да. Документированный процесс сборки позволяет добавить к сгенерированной озвучке интро, фоновую подложку и аутро.
Может ли JingleLark использовать собственный голос пользователя?+
Да. Пользователи могут записать или загрузить от 8 до 30 секунд четкой речи, чтобы создать клонированный голос, озвучивающий набранный сценарий.
Сколько голосов и звуков указано в документации?+
В источнике указаны 24 радиоголоса, распределенные по шести эфирным ролям, а также 88 звуков, состоящих из интро, фоновых подложек и аутро.
На каких языках голоса могут читать тексты?+
В источнике сказано, что голоса могут читать сценарии примерно на 30 языках, а клонированные голоса документированы для английского, испанского, португальского, французского, немецкого, итальянского, русского, китайского, японского и корейского языков.
Другие ИИ-инструменты в категории Аудио
Посмотрите другие недавно добавленные инструменты в этой категории.