JingleLark erzeugt gesprochene Radiobeiträge aus eingegebenen Skripten, ausgewählten Stimmen und Mischelementen wie Intros, Hintergrundbetten und Outros.
AudioGesprochene Radio-Voiceovers aus…Voiceovers mit Intros, Hintergrundbetten…Das Sprechtempo von 0,7× bis 1,2× anpassenGeklonte Stimmen aus kurzen…KI-Generator für SenderkennungenRadio-Voiceover-GeneratorKI-Jingle-MakerRadio-JinglesRadio-ImagingDJ-Drops
Bei AIToolly gelistet
Was ist JingleLark? Produktübersicht
Funktion und offizielle Positionierung des Produkts
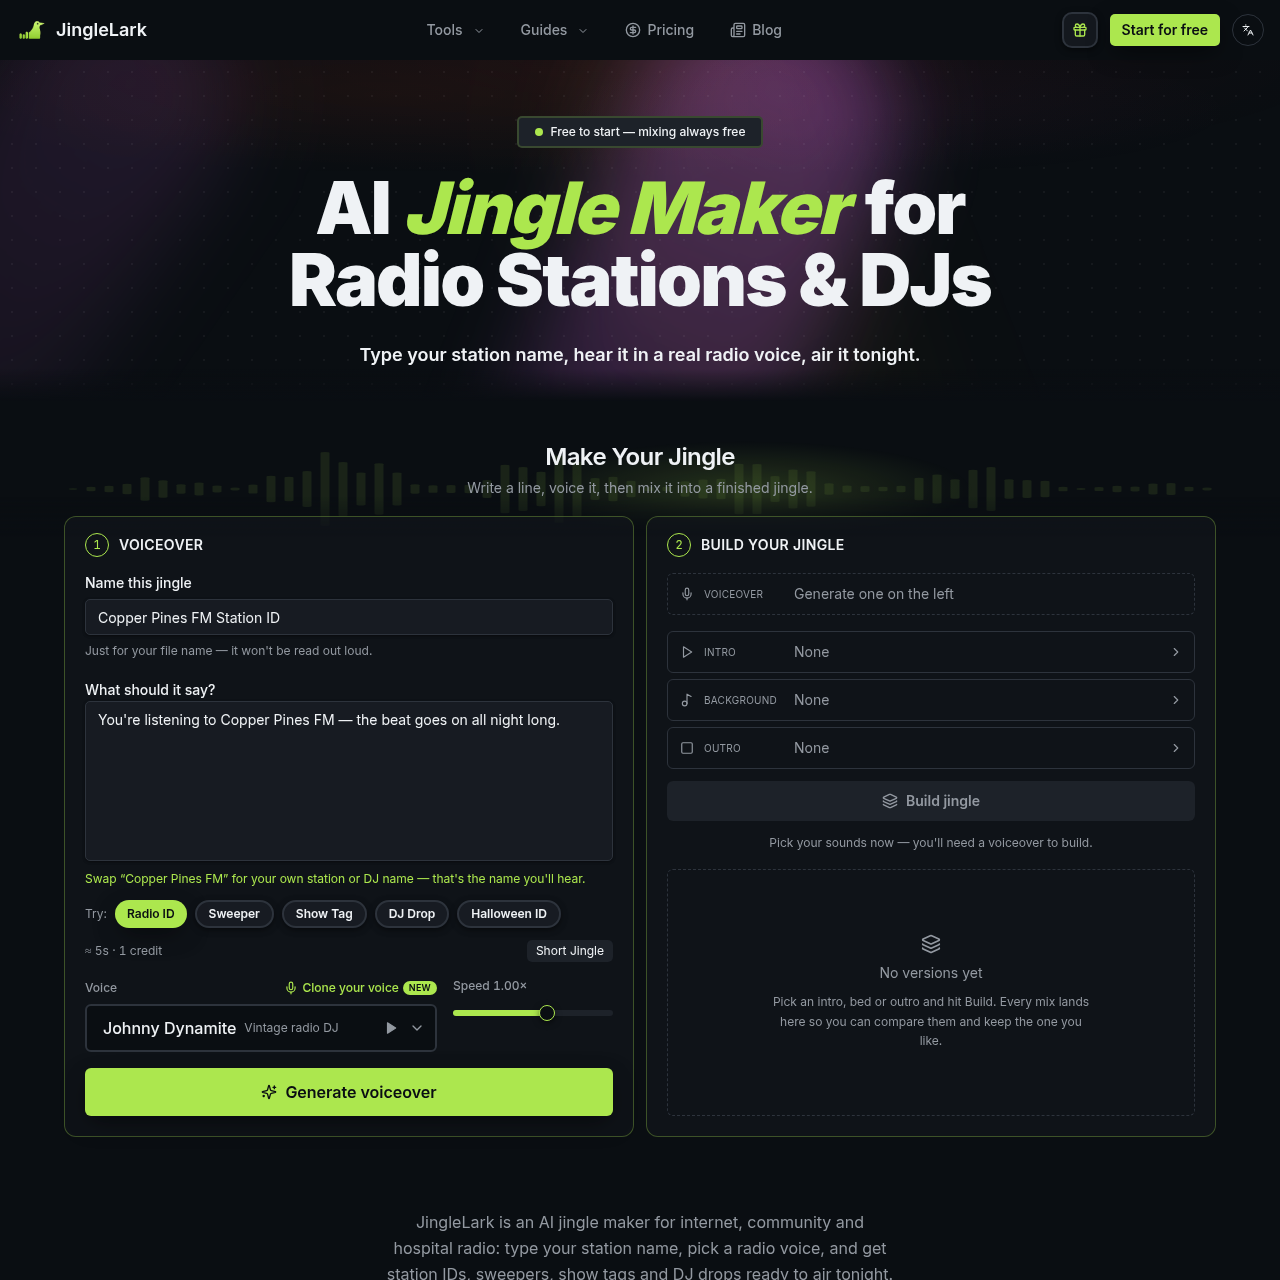
JingleLark (jinglelark.com) ist ein KI-Generator für Senderkennungen und Radio-Voiceovers für kleine Radiosender, einschließlich Internet-, Community- und Krankenhaus-Radios. Du zahlst nur für die Stimme; Mixing, Remixing und Downloads sind kostenlos. Gib deinen Sendernamen oder dein Skript ein, wähle eine Radiostimme und kombiniere sie mit einem Intro, Musikbett und Outro, um eine sendefertige Senderkennung, einen Sweeper, einen Show-Tag oder einen DJ-Drop zu erstellen. Exportiere das fertige Audio als MP3 oder WAV. Einmalige Credit-Pakete beginnen bei $14.90, ohne Abonnement.
JingleLark ist ein KI-Tool zum Erstellen gesprochener Senderkennungen, Sweepers, Show-Tags, DJ-Drops und verwandter Radio-Audios aus von Nutzern verfassten Skripten.
Der Arbeitsablauf kombiniert erzeugte Voiceovers mit auswählbaren Klangelementen, während Vorlagen und optionales Stimmenklonen wiederkehrende Sender- und Moderatorenformate unterstützen.
Wofür kann JingleLark verwendet werden?
Durch offizielle Quellen belegte Anwendungsfälle
Senderproduktion für kleine Stationen
Senderkennungen, Sweepers, Sponsor-Spots und andere gesprochene Elemente für Internet-, Community- oder Krankenhaus-Radio erstellen.
Markenbildung für Moderatoren und Shows
Show-Intros, Moderatoren-Tags und Segment-Stings mit einer ausgewählten Radiostimme oder einer erlaubten geklonten Stimme vorbereiten.
DJ-Drops
Gesprochene DJ-Drops, Namens-Tags und Set-Eröffnungen aus DJ-Namen, Skript und ausgewählter Stimme erzeugen.
So verwenden Sie JingleLark
Der dokumentierte Ablauf, sofern verfügbar
1
Die Zeile schreiben
Ein Sender-, Moderatoren- oder DJ-Skript eingeben oder mit einer Vorlage für Radio-ID, Sweeper, Show-Tag oder DJ-Drop beginnen.
2
Das Voiceover erzeugen
Eine On-Air-Rolle oder eine verfügbare geklonte Stimme auswählen und anschließend die gesprochene Fassung des Skripts erzeugen.
3
Erstellen und herunterladen
Intro, Hintergrundbett und Outro hinzufügen, die Mischung erstellen, Versionen vergleichen und das ausgewählte Ergebnis als MP3 oder WAV herunterladen.
Arbeitsablauf für Stimme und Mischung
Das Produkt trennt die Stimmenerzeugung vom Aufbau der Mischung. Zuerst wird ein eingegebenes Skript mit einer ausgewählten Stimme umgesetzt; anschließend kann das resultierende Voiceover mit senderorientierten Klangelementen kombiniert werden.
Der dokumentierte Mischvorgang umfasst Ducking im Stil eines Sidechain-Effekts unter der Stimme, das Kürzen von Stille innerhalb von Soundeffekten und einen Lautheitsausgleich auf -16 LUFS.
Zu den Stimmrollen gehören Vintage-DJ, Nachtmoderator, Hype-Ansager, britischer Moderator und warmer Sprecher.
Die dokumentierte Bibliothek enthält 45 Intros, 28 Hintergrundbetten und 15 Outros.
Das Sprechtempo kann von 0,7× bis 1,2× angepasst werden.
Zum Stimmenklonen wird eine Aufnahme oder ein Upload von 8–30 Sekunden akzeptiert.
JingleLark Preise
Von Nutzern oder Administratoren gepflegte Preisangaben
creditsfreemium
USD 14.9
Preise können sich ändern. Prüfen Sie vor dem Kauf die aktuellen Tarife und Abrechnungsbedingungen auf der offiziellen Website.
Was Sie vor der Wahl von JingleLark testen sollten
Prüfungen mit eigenen Inhalten und Arbeitsabläufen
Bestätigen, dass die verfügbaren Stimmrollen und die Klangbibliothek zum gewünschten Senderformat passen.
Prüfen, ob die geplanten Skripte die dokumentierte Grenze von 900 Zeichen einhalten und die gewünschte Sprechlänge erzeugen.
Vor der Produktion eines größeren Satzes von Senderkennungen prüfen, wie nicht-englische Skripte klingen.
Berechtigungen für das Stimmenklonen und Aufnahmebedingungen prüfen, bevor eine geklonte Stimme erstellt wird.
Antworten auf Basis des quellengeprüften Produkteintrags
Welche Arten von Radio-Audio kann JingleLark erstellen?+
Die dokumentierten Vorlagen und Beispiele umfassen Senderkennungen, Sweepers, Show-Tags, DJ-Drops, Show-Intros, Nachrichten-Stings und Sponsor-Spots.
Können Nutzer Musik oder Klangelemente zu einem Voiceover hinzufügen?+
Ja. Der dokumentierte Erstellungsablauf ermöglicht es, einem erzeugten Voiceover ein Intro, ein Hintergrundbett und ein Outro hinzuzufügen.
Kann JingleLark die eigene Stimme eines Nutzers verwenden?+
Ja. Nutzer können 8–30 Sekunden klare Sprache aufnehmen oder hochladen, um eine geklonte Stimme zu erstellen, die das eingegebene Skript liest.
Wie viele Stimmen und Sounds sind dokumentiert?+
Die Quelle dokumentiert 24 Radiostimmen in sechs On-Air-Rollen sowie 88 Sounds, bestehend aus Intros, Hintergrundbetten und Outros.
Welche Sprachen können die Stimmen lesen?+
Die Quelle sagt, dass die Stimmen Skripte in etwa 30 Sprachen lesen können. Geklonte Stimmen sind für Englisch, Spanisch, Portugiesisch, Französisch, Deutsch, Italienisch, Russisch, Chinesisch, Japanisch und Koreanisch dokumentiert.
Weitere KI-Tools für Audio
Entdecken Sie weitere kürzlich hinzugefügte Tools derselben Kategorie.