AgentScore
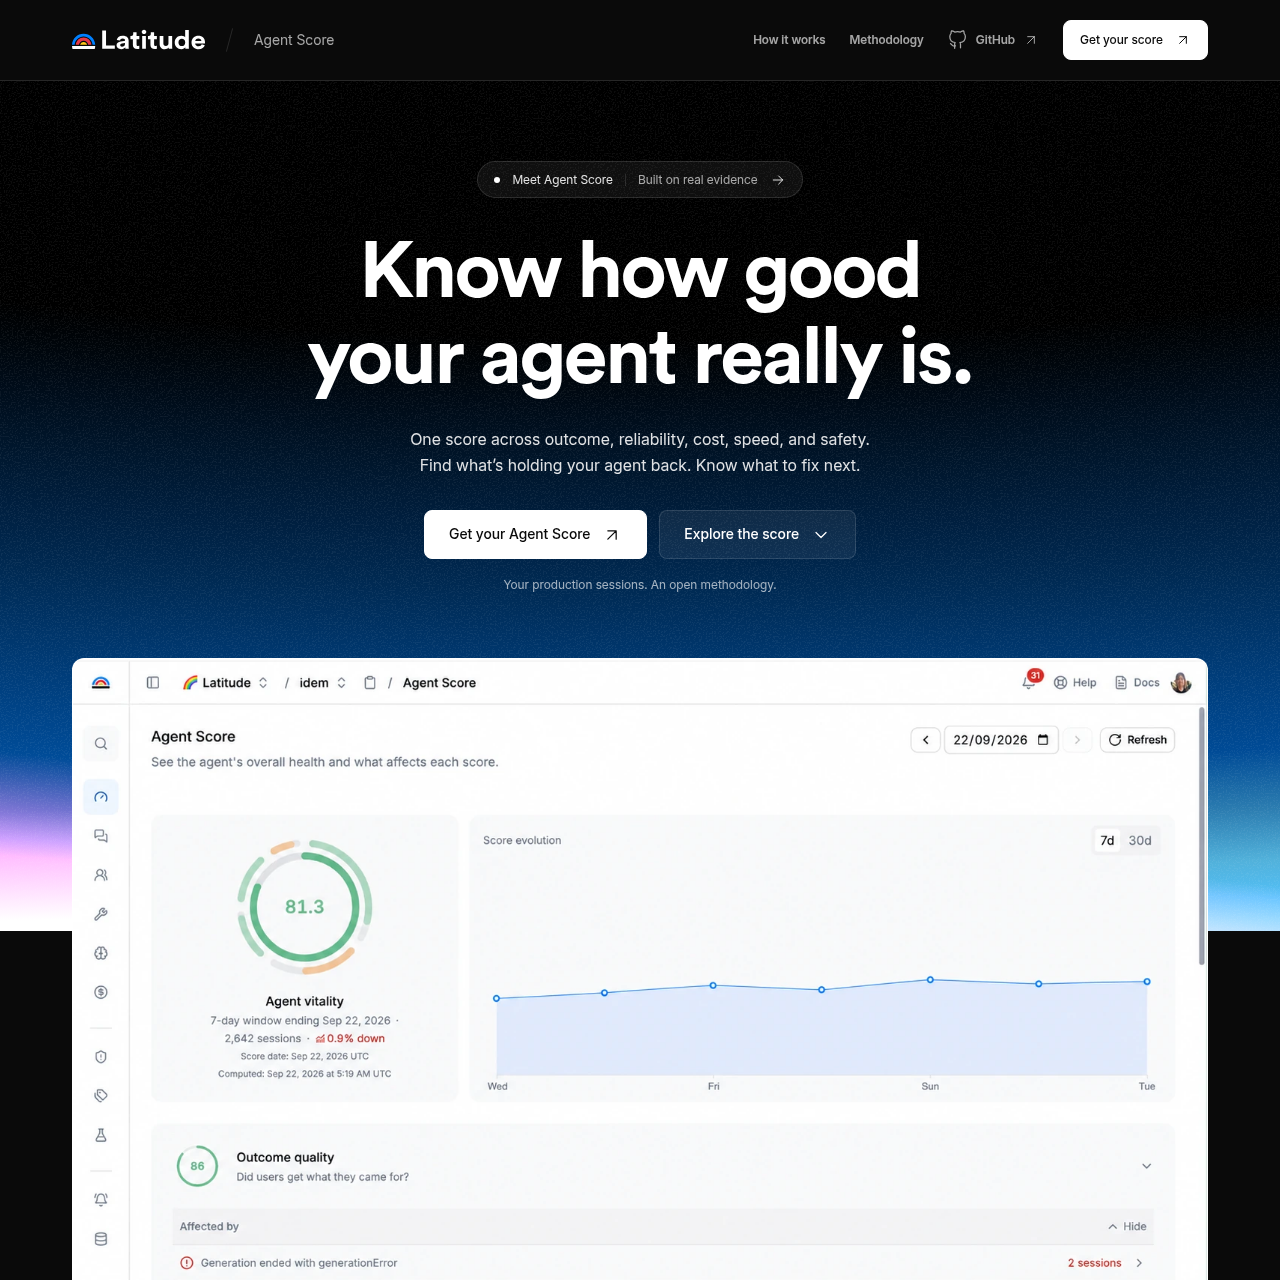
Latitude의 AgentScore는 수집된 트레이스를 활용하여 결과, 신뢰성, 비용, 속도, 안전성의 다섯 가지 차원에서 프로덕션 AI 에이전트를 평가합니다.
코드 및 IT결과, 신뢰성, 비용 전반의 프로덕션 트레이스 증거를 바탕으로 종합…에이전트 실행, LLM 완성, 도구 검색을 포함한 특정 프로덕션…반복적인 실패 패턴을 포착하고 이를 개별 세션으로 역추적관측된 프로덕션 실패 사례를 반복 가능한 평가 벤치마크로 변환
Latitude의 AgentScore는 수집된 트레이스를 활용하여 결과, 신뢰성, 비용, 속도, 안전성의 다섯 가지 차원에서 프로덕션 AI 에이전트를 평가합니다.
제품의 기능과 공식 포지셔닝
AgentScore는 프로덕션 트레이스를 통합 평가 점수로 변환하는 Latitude 플랫폼 내의 평가 기능입니다. 이 기능은 결과, 신뢰성, 비용, 속도, 안전성이라는 다섯 가지 주요 차원에서 AI 에이전트를 평가합니다.
이 도구는 합성 벤치마크에 의존하는 대신 OpenTelemetry나 기존 트레이스 소스를 통해 전송된 실제 프로덕션 증거를 요구합니다. 점수를 표시하려면 에이전트가 최소 1,000개의 적격 세션 전반에서 사전 정의된 커버리지, 트래픽 및 신뢰도 기준을 통과해야 합니다.
공식 출처로 확인된 활용 사례
팀은 OpenTelemetry를 통해 실시간 세션 트레이스를 수집하여 5가지 개별 운영 차원에서 에이전트의 성공 여부를 측정합니다.
엔지니어는 실패한 프로덕션 세션을 검사하여 부정적인 행동 패턴을 식별하고 이를 지속적인 평가 벤치마크로 변환합니다.
개발자는 MCP를 통해 코딩 에이전트에 프로덕션 실패 증거를 입력하여 맞춤형 코드 수정을 구현하고 릴리스 후 영향을 검증합니다.
공식 문서에 안내된 사용 절차
OpenTelemetry를 통해 수동으로 또는 기존 트레이싱 설정을 통해 실시간 에이전트 실행 트레이스를 Latitude로 전송합니다.
트래픽, 커버리지, 신뢰도 게이트를 통과할 때까지 플랫폼이 7일, 14일, 21일 또는 28일 기간 동안 최소 1,000개의 적격 세션을 수집하도록 합니다.
도출된 점수를 검토하고, 에이전트 성능을 저하시키는 차원을 파악하며, 실패한 개별 세부 세션을 면밀히 조사합니다.
식별된 프로덕션 실패 사례를 바탕으로 평가를 구성하여 이후 세션 전반에서 에이전트의 동작을 모니터링합니다.
MCP를 사용하여 코딩 에이전트에 트레이스 증거를 제공하고, 업데이트된 에이전트 코드를 배포한 뒤 후속 프로덕션 세션에 미치는 영향을 추적합니다.
AgentScore는 점수를 보고하기 전에 엄격한 통계적 기준을 적용합니다. 점수가 계산되기 위해서는 에이전트가 최소 1,000개의 적격 프로덕션 세션을 축적해야 합니다. 또한 수집된 증거는 5가지 평가 차원 모두에서 트래픽, 커버리지, 신뢰도 게이트를 통과해야 합니다.
점수 산정은 적격성 요건을 충족하는 가장 짧은 주 단위 기간(7일, 14일, 21일 또는 28일) 동안 진행됩니다. 계산된 각 점수에는 95% 신뢰구간이 함께 제공되므로 성능을 평가할 때 불확실성을 명확하게 파악할 수 있도록 지원합니다.
본인의 자료와 작업 흐름으로 직접 확인할 항목
확인한 출처와 확인 시점
출처를 확인한 제품 정보를 바탕으로 한 답변
AgentScore는 결과, 신뢰성, 비용, 속도, 안전성이라는 다섯 가지 핵심 차원에서 프로덕션 세션을 평가합니다.
트레이스는 OpenTelemetry를 통해 연결하거나 기존 트레이스 설정에서 가져올 수 있으며, Latitude AI 스킬 프롬프트를 사용하여 구성할 수도 있습니다.
에이전트는 최소 1,000개의 적격 프로덕션 세션을 누적해야 하며, 다섯 가지 모든 차원에서 트래픽, 커버리지 및 신뢰도 게이트를 충족해야 합니다.
AgentScore는 요구사항을 충족하는 가장 짧은 적격 주 단위 기간인 7일, 14일, 21일 또는 28일 동안 세션을 평가합니다.
개발자는 실패 세션을 검사하고 이를 평가 항목으로 변환할 수 있으며, MCP를 사용하여 코딩 에이전트에 직접 증거를 전달할 수 있습니다.