AgentScore
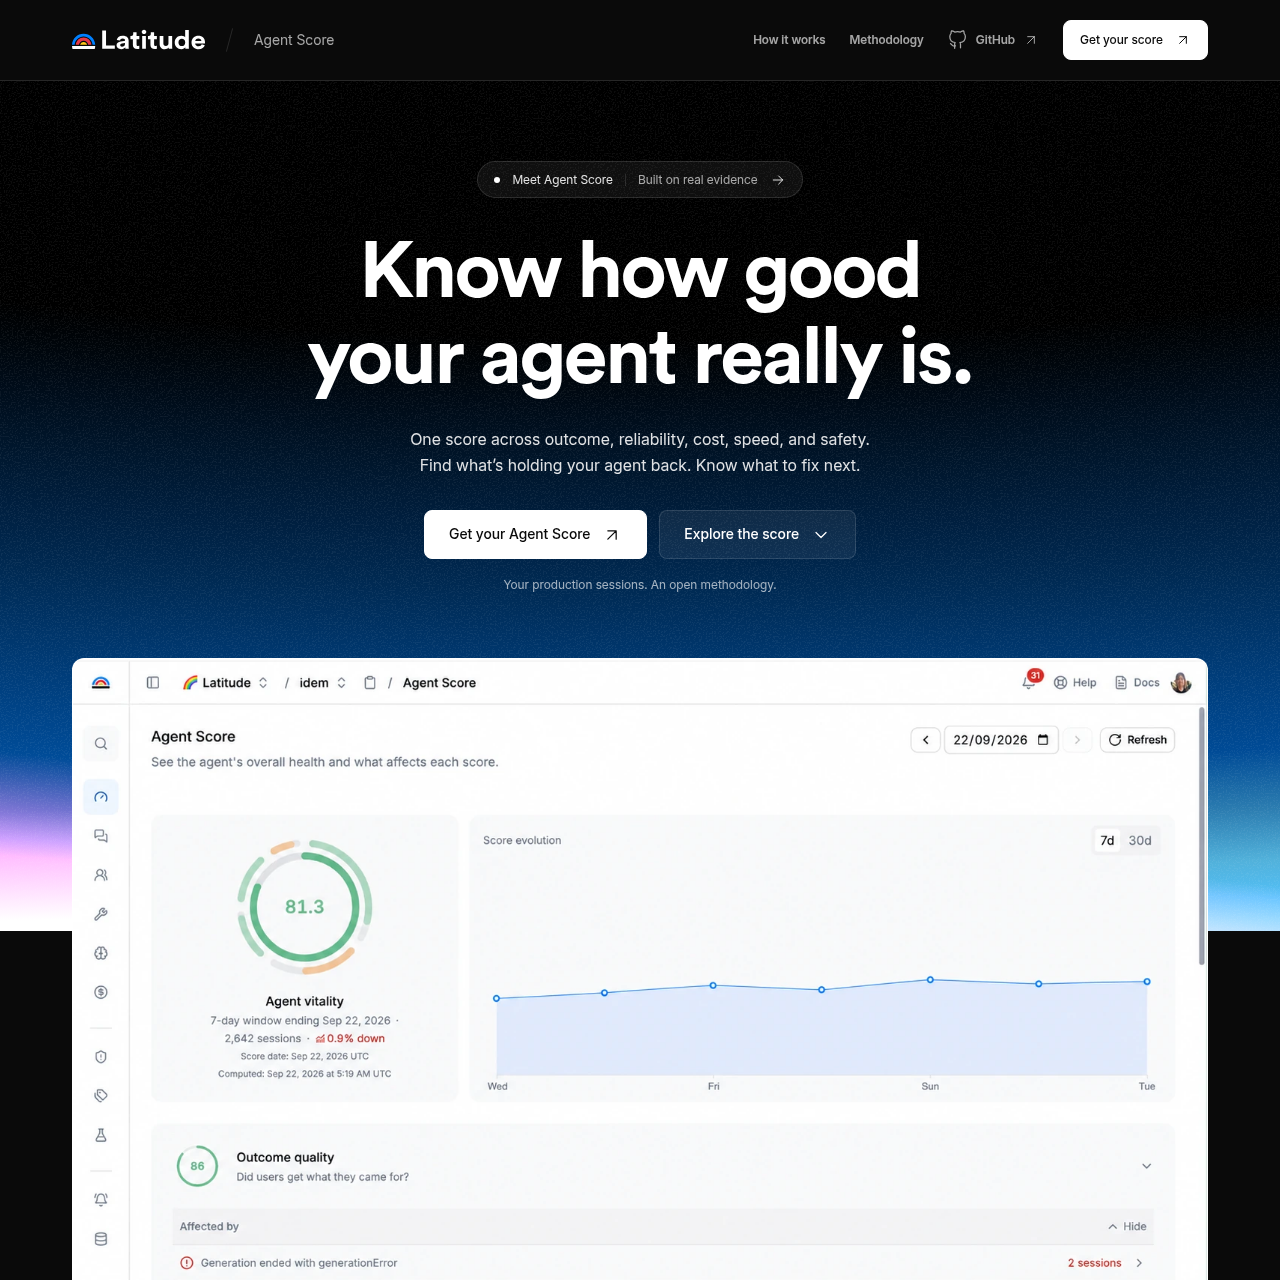
LatitudeのAgentScoreは、取り込まれたトレースを用いて本番AIエージェントを成果、信頼性、コスト、速度、安全性の5つの観点から総合的に評価します。
コードとIT成果、信頼性、コスト、速度、安全性にわたる本番トレースの証拠に基づいて総合スコアを…エージェントの実行、LLM補完、ツール検索など特定の本番トレーススパンを詳細に調査繰り返し発生する失敗パターンを浮き彫りにし、個々のセッションまで追跡観測された本番の失敗を再現可能な評価ベンチマークへと変換
LatitudeのAgentScoreは、取り込まれたトレースを用いて本番AIエージェントを成果、信頼性、コスト、速度、安全性の5つの観点から総合的に評価します。
製品の機能と公式な位置づけ
AgentScoreはLatitudeプラットフォーム内の評価機能であり、本番環境のトレースを統合された評価スコアに変換します。成果、信頼性、コスト、速度、安全性の5つの主要ディメンションにわたってAIエージェントを評価します。
合成ベンチマークに依存するのではなく、OpenTelemetryまたは既存のトレースソース経由で送信される実際の本番証拠を必要とします。スコアを表示するには、エージェントは最低1,000件の適格セッション全体で所定のカバレッジ、トラフィック、信頼性の閾値をクリアする必要があります。
公式情報で確認できる活用例
チームはOpenTelemetryを介してライブセッションのトレースを取り込み、5つの異なる運用ディメンションにわたってエージェントの成功度を測定します。
エンジニアは失敗した本番セッションを詳細に調査して問題のある挙動パターンを特定し、それらを継続的な評価ベンチマークへと変換します。
開発者は本番の失敗証拠をMCP経由でコーディングエージェントに提供し、ピンポイントなコード修正の実装とその後のリリース影響の検証を行います。
公式情報に記載された利用手順
OpenTelemetryを手動で設定するか既存のトレーシング構成を利用して、ライブエージェントの実行トレースをLatitudeに送信します。
7日、14日、21日、または28日間のウィンドウでプラットフォームが最低1,000件の適格セッションを収集し、トラフィック、カバレッジ、信頼性の基準を通過するまで待機します。
算出されたスコアを確認し、エージェントのパフォーマンスのボトルネックとなっているディメンションを特定して、個々の失敗セッションへとドリルダウンします。
特定された本番の失敗事例に基づいて評価を設定し、その後のセッションにわたってエージェントの挙動を継続的に監視します。
MCPを使用してトレースの証拠をコーディングエージェントに提供し、更新されたエージェントコードをデプロイして、その後の本番セッションへの影響を追跡します。
AgentScoreはスコアを報告する前に厳密な統計基準に依存します。スコアを算出するには、エージェントが最低1,000件の適格な本番セッションを蓄積する必要があります。また、その証拠は5つの評価ディメンションすべてにわたってトラフィック、カバレッジ、および信頼性のゲートを通過しなければなりません。
スコアリングは、適格要件を満たす最短の週単位の期間(7日、14日、21日、または28日)にわたって実施されます。算出された各スコアには95%の信頼区間が付随し、パフォーマンスを評価する際に不確実性が明確に示されます。
自分の素材とワークフローで確認したい項目
確認した情報源とその日時
情報源を確認した製品情報に基づく回答
AgentScoreは、成果(outcome)、信頼性(reliability)、コスト(cost)、速度(speed)、安全性(safety)という5つの主要なディメンションにわたって本番セッションを評価します。
トレースはOpenTelemetry経由で接続するか、既存のトレーシング設定から引き継ぐか、あるいはLatitude AIスキルプロンプトを使用して構成することで取り込むことができます。
エージェントは最低1,000件の適格な本番セッションを蓄積し、5つのディメンションすべてにわたってトラフィック、カバレッジ、信頼性のゲートを満たす必要があります。
AgentScoreは、要件を満たす最短の週単位のウィンドウ(7日間、14日間、21日間、または28日間)にわたってセッションの評価を行います。
開発者は失敗セッションを精査して評価項目へと変換し、MCP(Model Context Protocol)を使用してコーディングエージェントに直接証拠を渡して問題解決に役立てることができます。