guilds.run
guilds.run 是一款在本地机器上运行的开源多智能体编排平台,提供全流程运行可观测性、持久化记忆、沙盒计算工作区,以及面向异构语言模型的可配置连接器。
编程&IT通过 Docker Compose 在本地执行多智能体自动化例程和调度作业在同一业务团队内的不同智能体之间混用各类前沿模型与开放权重模型在隔离的智能体沙盒中自动化执行网页浏览操作和终端脚本实时追踪智能体间的通信、触发调用关系以及具体执行耗时
guilds.run 是一款在本地机器上运行的开源多智能体编排平台,提供全流程运行可观测性、持久化记忆、沙盒计算工作区,以及面向异构语言模型的可配置连接器。
产品用途与官方定位
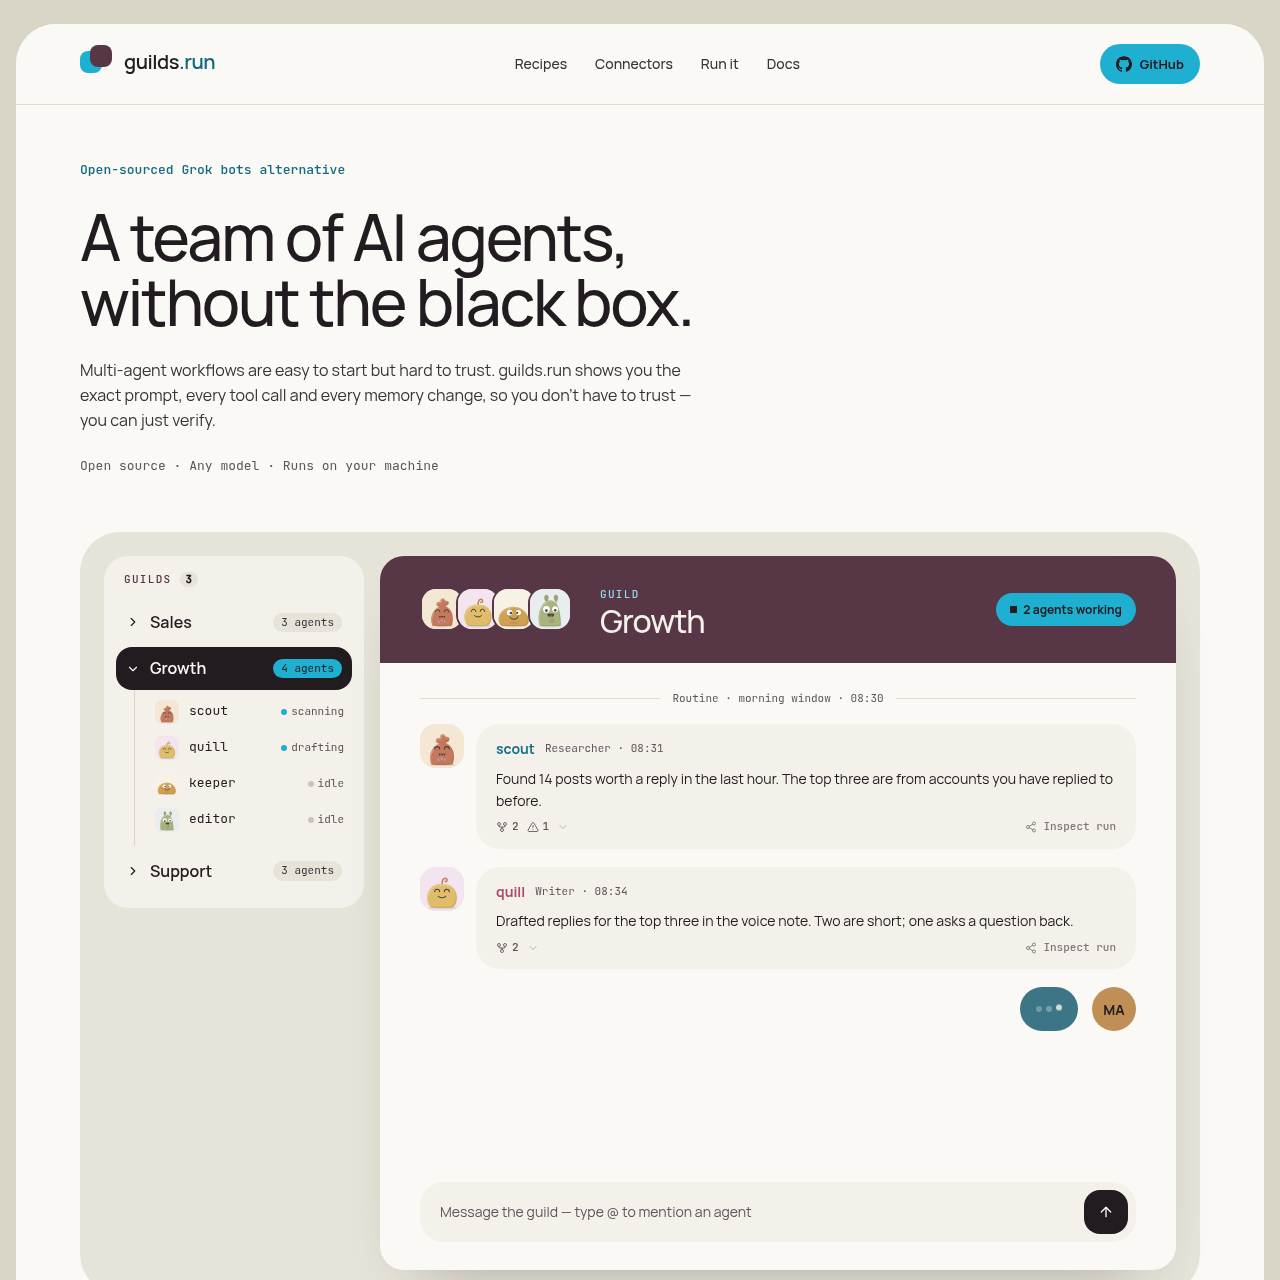
guilds.run 是一套开源系统,专为在用户自主控制的基础设施上部署和管理协作式 AI 智能体团队而设计。该平台通过公开提交给模型的完整提示词、工具执行输出以及跨运行的每次记忆修改,有效解决了多智能体执行过程中的不透明问题。
每个智能体都在配备终端、脚本存储及可选持久化浏览器的独立工作区内运行。组织可以跨不同部门协同调度智能体,挂载限定权限的第三方连接器,并利用内置的 Studio 教练诊断工作流问题并持续优化智能体指令。
有官方来源支持的使用场景
智能体团队扫描社交时间线,根据回复标准对收到的帖子进行评估打分,起草符合特定规范的回复,并将内容排入队列供操作人员审核。
预配置的智能体配方读取共享支持收件箱,对问题进行标记和路由,并准备初步的回复草案以供人工客服审批。
自动化智能体检查代码仓库以整理 issue、审查新提交的拉取请求(PR),并维护开发待办事项列表。
智能体调研外部潜在客户档案,撰写介绍性外联沟通文案,并将交互记录归档至结构化数据库表中。
官网提供的使用流程
克隆开源代码仓库,并使用 Docker Compose 部署本地服务。
直接定义智能体、常驻任务指令、调度计划和共享数据库模式,或直接套用预先配置的团队配方。
提供所选提供商的模型凭据,并将第三方服务连接器分配给组织、公会或单个智能体。
检查实时运行状态,查看工具调用和记忆变更,并采纳由 Studio 教练建议的提示词修正方案。
运行自主智能体团队时,当多步骤输出偏离预期,排查调试往往面临巨大挑战。guilds.run 通过捕获每次运行的全面执行记录来解决这一问题,完整呈现发送给模型的逐字提示词、每个工具调用的参数与返回值,以及最终在记忆中产生的状态变更。
依托这一审计追踪,Studio 功能充当了自动化诊断工具。它分析执行历史、共享笔记和记忆表以检测反复出现的故障(例如智能体编写的文本超出字数限制)。Studio 能为智能体指令生成精确的 diff 修改建议,允许操作人员在对实际生产行为进行任何更改之前完成验证并发布调整。
guilds.run 中的智能体不仅限于无状态的 API 调用;每个智能体都能访问专属的隔离计算环境。工作区包含专用终端、可复用脚本执行功能,以及在预定运行之间保持登录状态的浏览器会话,从而支持连续的基于 Web 的工作流。
集成管理在支持广泛模型提供商灵活性的同时,提供了细粒度的工具权限控制。同一公会内的智能体可以运行不同的模型,涵盖商业前沿 API 到本地端点。连接到 GitHub、Notion、Gmail 及链上工具等服务的连接器可严格限定仅向需要它们的智能体开放。
用自己的素材和工作流完成验证
核对了哪些信息以及核对时间
基于已核对产品资料的回答
guilds.run 是一款开源软件,通过 Docker Compose 在用户本地计算机或自托管服务器上运行,数据与计算完全由用户自主掌控。
该平台支持 Claude、GPT、Gemini 和 Grok 等前沿模型,同时也支持通过本地端点或提供商 API 密钥接入 Qwen、DeepSeek、Kimi、Llama、Mistral 和 GLM 等开放权重模型。
系统会完整记录每个执行步骤,清晰展示模型接收到的准确提示词、每次工具调用及其返回输出,以及跨历次运行发生的所有持久化记忆修改。
每个智能体的工作区都包含一个终端、可复用脚本存储区,以及一个可在多次执行之间保留登录会话状态的可选 Web 浏览器环境。
连接器通过细粒度的访问控制进行统一管理,管理员可以将外部账户的访问权限绑定到整个组织、特定公会或指定的单个智能体。