ElevenLabs Realtime
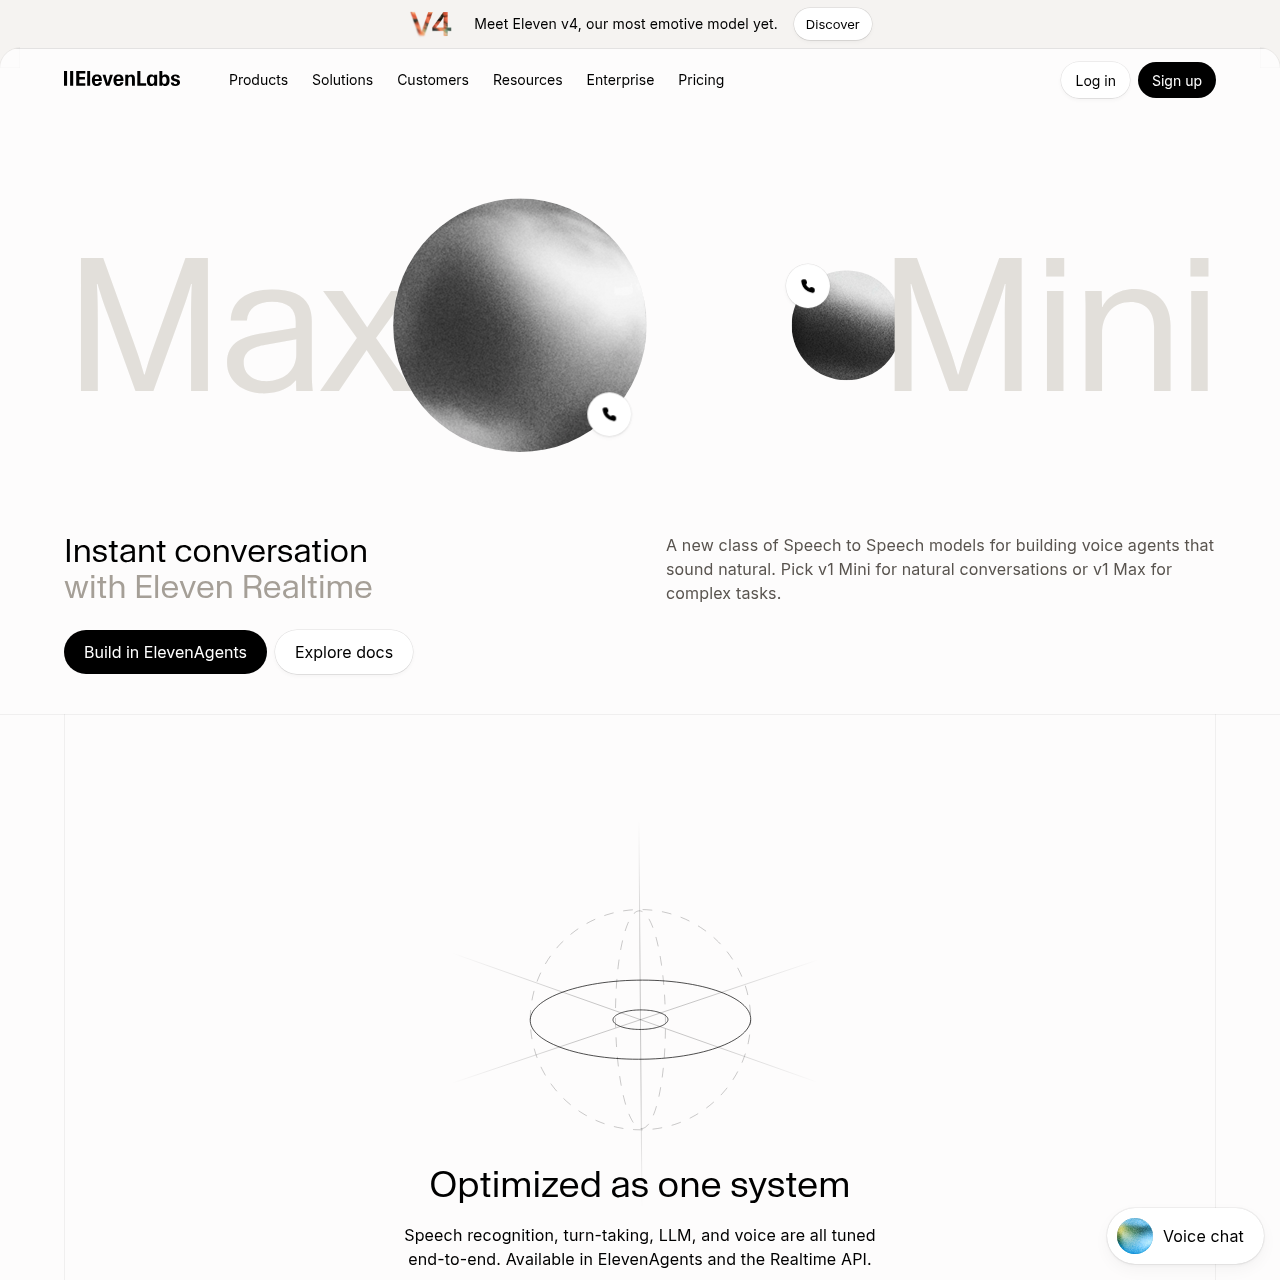
ElevenLabs Realtime 推出了端到端语音到语音模型 v1 Mini 和 v1 Max,将语音识别、轮流发言控制与语音合成深度融合,为对话式智能体提供支持,并提供兼容 OpenAI 的 WebSocket API。
文字转语音实时轮流发言与对话打断处理能力使用 v1 Max 在实时对话中调用工具且不降低响应速度通过模型下拉菜单在 ElevenAgents 中直接集成基于 WebSocket 的实时通信,兼容 OpenAI Agents…
ElevenLabs Realtime 推出了端到端语音到语音模型 v1 Mini 和 v1 Max,将语音识别、轮流发言控制与语音合成深度融合,为对话式智能体提供支持,并提供兼容 OpenAI 的 WebSocket API。
产品用途与官方定位
ElevenLabs Realtime 是一套专为交互式对话语音智能体打造的端到端语音到语音模型系列。该架构将语音识别、轮换发言逻辑、语言模型处理和人声合成无缝整合为一体化系统,旨在发生对话打断时依然保持自然的对话节奏。
该系统提供两种模型配置:面向富有表现力且流畅互动的 v1 Mini,以及面向结构化推理和自动化工具执行的 v1 Max。用户可以通过无代码环境 ElevenAgents 直接部署这些模型,也可以通过兼容 OpenAI Realtime 处理程序的 WebSocket API 进行调用。
有官方来源支持的使用场景
v1 Mini 为互动角色、语音助手以及语言或学科导师提供支持,满足对自然对话节奏和生动语音表达的需求。
v1 Max 可处理复杂的咨询提问、自动日程安排和线索筛选对话,在调用外部工具的同时始终保持顺畅的对话流。
官网提供的使用流程
在 ElevenAgents 界面中初始化新智能体,或使用 Realtime API 配置会话连接。
根据需求在侧重对话流畅度的 v1 Mini 模型与侧重逻辑推理和工具调用的 v1 Max 模型之间进行选择。
从超过 17,500 种音色中挑选合适声音,并在支持的 90 多种语言与口音中完成语言参数配置。
通过 WebSocket 通道建立实时语音对话连接,并在管理控制面板中监控可用于审计的交互日志。
ElevenLabs Realtime 将语音识别、话轮管理、语言理解和语音生成统一集成至单一的端到端流程中。这种设计避免了将独立的外部语音转录、大模型推理和文本转语音服务串联在一起,使得智能体能够自然且即时地响应对话中的插话与打断。
开发者可以通过 ElevenAgents 平台或使用 Realtime API 通过 WebSocket 连接以编程方式接入该系统。由于该 API 与 OpenAI 的 Realtime 协议及客户端事件保持兼容,现有的客户端处理程序、日志记录工具和 SDK 配置只需修改目标端点和模型名称即可完成迁移。
用自己的素材和工作流完成验证
核对了哪些信息以及核对时间
基于已核对产品资料的回答
Eleven Realtime 是一套端到端语音到语音模型系列,将语音识别、轮流发言控制、大语言模型处理和语音合成统一整合为一个单体交互对话系统。
v1 Mini 针对生动表现力与自然的对话节奏进行了专门优化;而 v1 Max 则专为处理复杂任务、逻辑推理以及在商务交互中调用外部工具而构建。
Eleven Realtime 提供了兼容 OpenAI 的 API,共享相同的客户端与服务器事件规范。开发者无需重写现有处理程序和工具链,仅需更改请求端点与模型名称即可完成平滑迁移。
该平台提供了超过 17,500 种涵盖多种表达风格的音色,并支持跨 90 多种语言及其不同地区口音的低延迟实时语音对话互动。
该平台对传输中和静态数据实施全程加密,符合 SOC 2 Type II、ISO 27001、ISO 42001、HIPAA、PCI DSS Level 1 和 GDPR 规范,并提供欧盟数据驻留与零数据留存选项。