技术教程Scikit-Learn大语言模型机器学习
如何使用Scikit-LLM将大语言模型翻译整合进Scikit-Learn管道
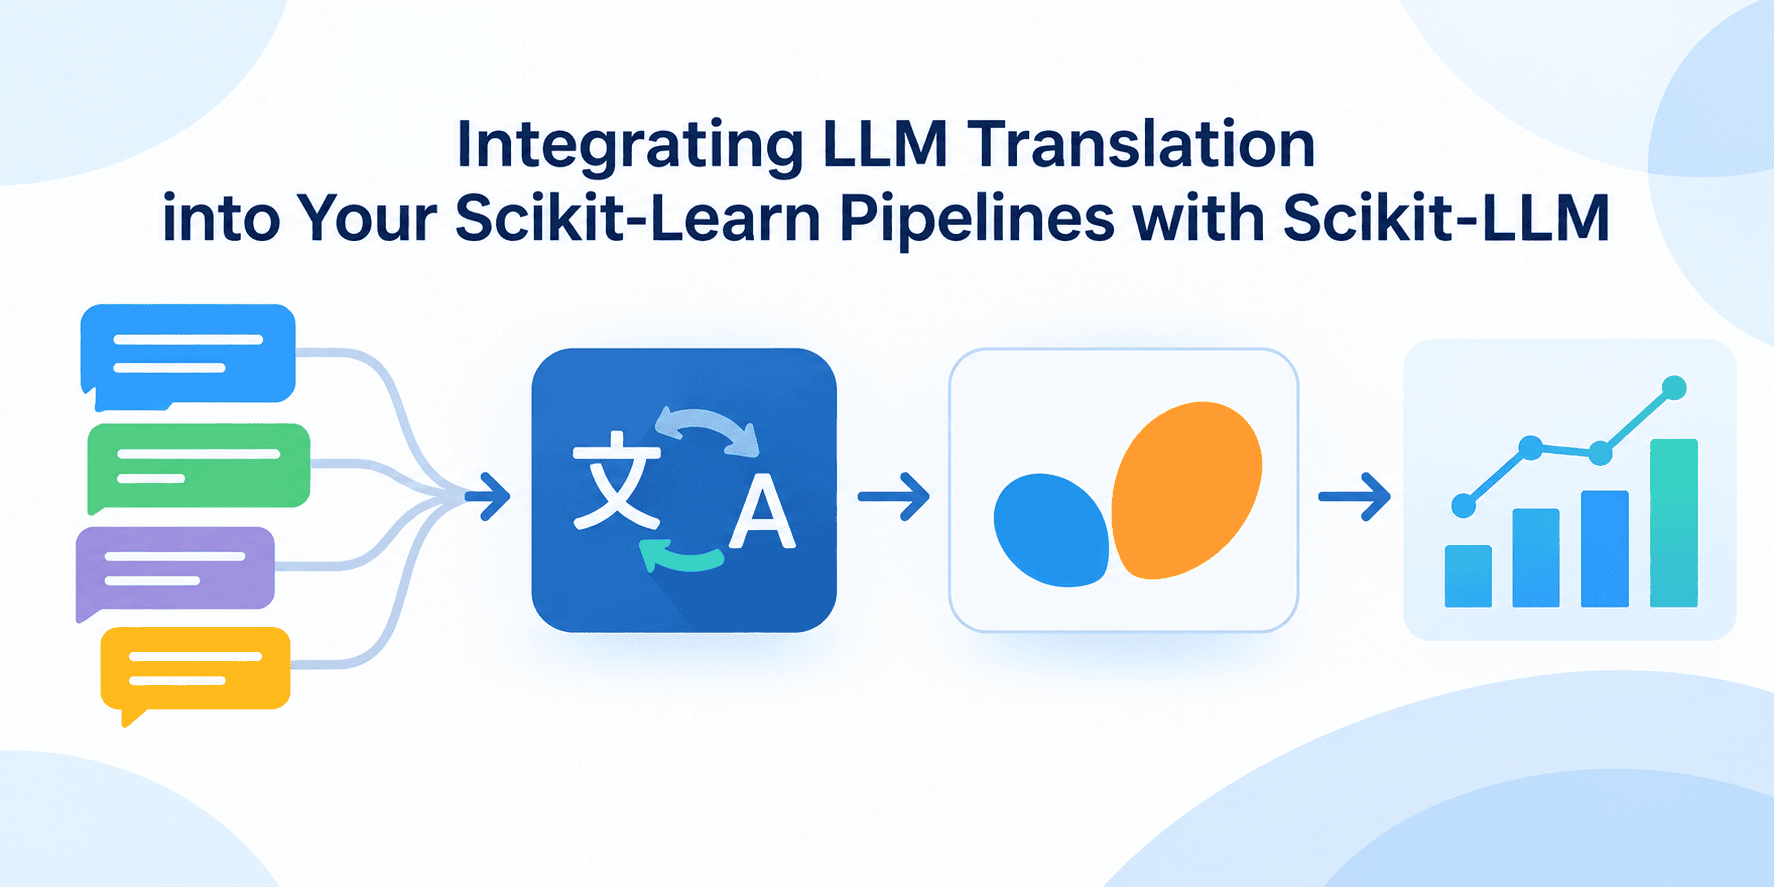
本文介绍了如何通过几个简单的步骤,利用Scikit-LLM处理的两个预训练大语言模型进行翻译和零样本分类,构建一个用于多语言文本分类的两阶段Scikit-Learn机器学习管道。
KDnuggets
核心要点
- 学习构建两阶段的 Scikit-Learn 管道来实现多语言文本分类。
- 利用 Scikit-LLM 处理两个预训练的大语言模型。
- 在管道中结合大语言模型的能力进行翻译和零样本分类。
- 通过简单易懂的步骤完成复杂的多语言文本处理工作流整合。
详细分析
什么是 Scikit-LLM 与管道整合
根据原文,本文主要指导用户如何通过几个简单的步骤,构建一个两阶段的 scikit-learn 管道,专门用于处理多语言文本分类任务。这一过程由两个预训练的大语言模型进行引导,并通过 Scikit-LLM 来处理翻译以及零样本分类的具体操作。
构建多语言文本分类的工作流
在实际应用中,将大语言模型的能力无缝嵌入到传统的机器学习框架中是一个实用的方向。通过 Scikit-LLM,开发者可以在熟悉的 Scikit-Learn 管道生态中,利用大语言模型强大的翻译和零样本分类功能,提升多语言文本分类任务的执行效率和开发体验。
行业影响
该技术和方法论展示了如何将先进的大语言模型工具与经典机器学习库(如 Scikit-Learn)进行结合。这为开发者在现有的机器学习工作流中引入大语言模型(如翻译和零样本分类)提供了切实可行的路径,有助于推动多语言文本处理在实际项目中的落地应用。
常见问题
什么是 Scikit-LLM?
Scikit-LLM 是一个用于处理和集成大语言模型相关任务的工具,文章中它被用于管理和引导预训练的语言模型以实现翻译和零样本分类。
怎样在管道中使用它?
根据文章介绍,可以通过几个简单的步骤构建一个两阶段的 scikit-learn 管道,结合 Scikit-LLM 处理的预训练模型来实现多语言文本分类。