Integration von LLM-Übersetzungen in Scikit-Learn-Pipelines mit Scikit-LLM für mehrsprachige Textklassifikation
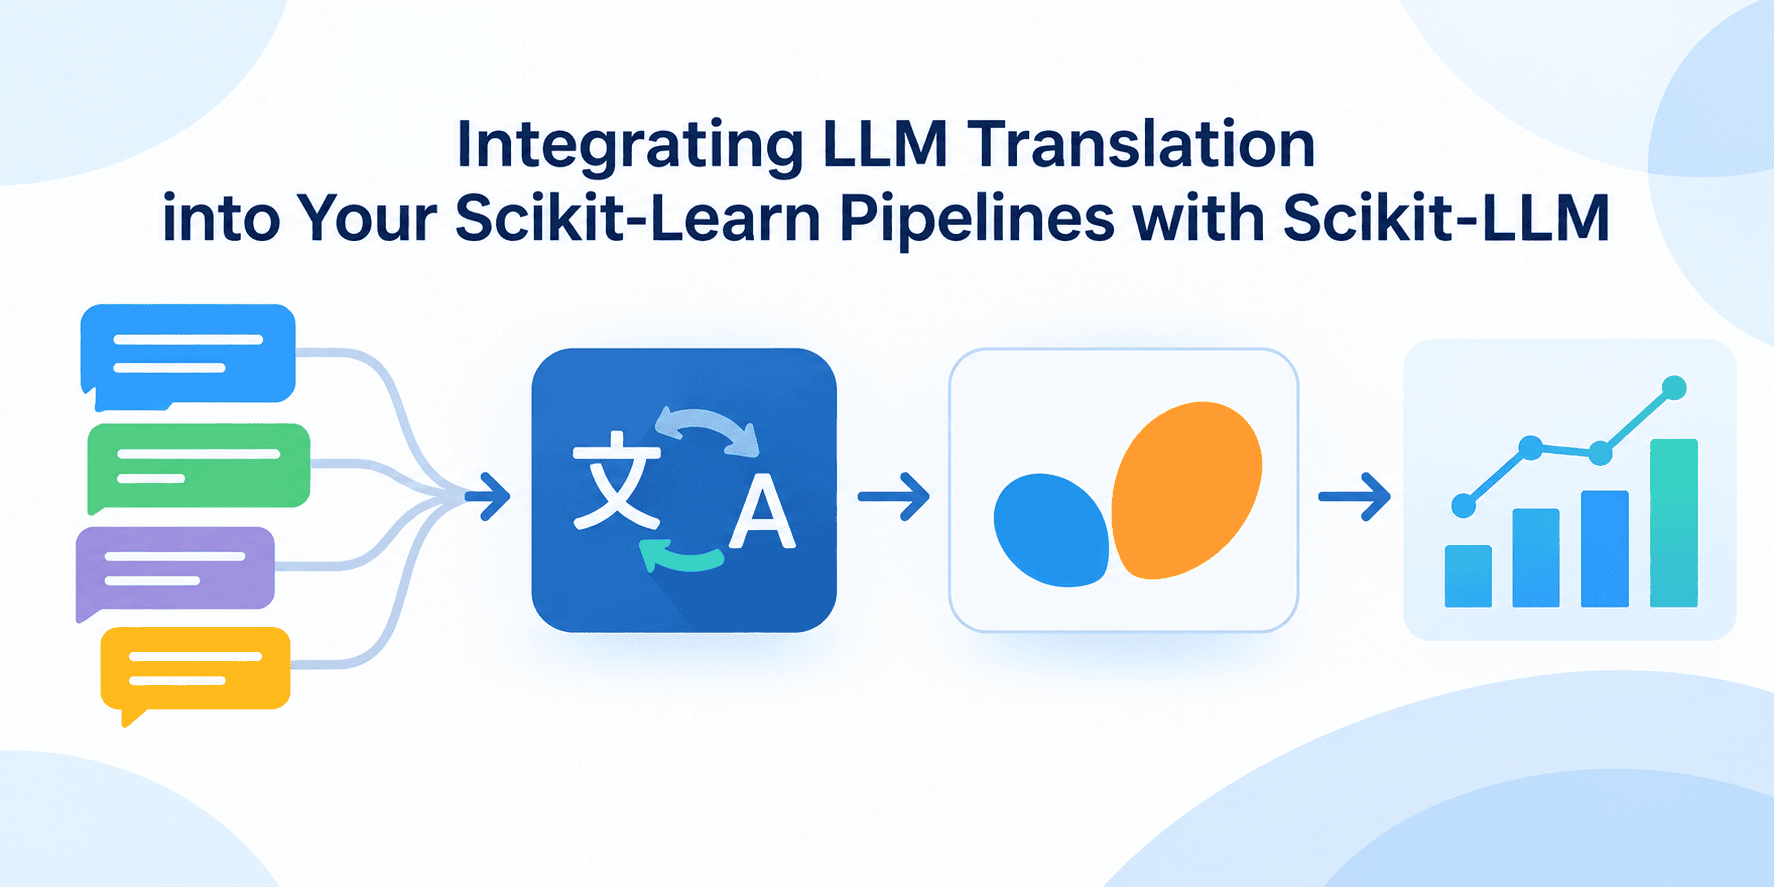
Erfahren Sie in wenigen einfachen Schritten, wie Sie eine zweistufige Scikit-Learn-Pipeline für die mehrsprachige Textklassifikation erstellen. Die Anleitung wird durch zwei vortrainierte Sprachmodelle gesteuert, die von Scikit-LLM für die Übersetzung sowie für die Zero-Shot-Klassifikation gehandhabt werden. Dieser strukturierte Ansatz zeigt, wie moderne Werkzeuge kombiniert werden können, um textbasierte maschinelle Lernprozesse zu optimieren und umzusetzen, basierend auf den von Scikit-LLM bereitgestellten Funktionen.
Die wichtigsten Punkte
- Erstellung einer zweistufigen Scikit-Learn-Pipeline für mehrsprachige Textklassifikation.
- Nutzung von Scikit-LLM zur Handhabung von zwei vortrainierten Sprachmodellen.
- Durchführung von Aufgaben wie Übersetzung und Zero-Shot-Klassifikation in wenigen Schritten.
Analyse
Kombination von Scikit-Learn und Scikit-LLM
Die Integration von fortschrittlichen Sprachmodellen in traditionelle Workflows des maschinellen Lernens stellt Entwickler oft vor Herausforderungen. Durch den Einsatz von Scikit-LLM wird es möglich, vortrainierte Sprachmodelle nahtlos zu handhaben. Die Originalmeldung beschreibt konkret die Erstellung einer zweistufigen Scikit-Learn-Pipeline, die speziell auf die Anforderungen der mehrsprachigen Textklassifikation ausgerichtet ist.
Übersetzung und Zero-Shot-Klassifikation
Ein zentraler Aspekt dieses Ansatzes ist die Aufteilung oder Nutzung der Modelle für spezifische Aufgaben. Dabei werden zwei vortrainierte Sprachmodelle eingesetzt, die jeweils für die Übersetzung und für die Zero-Shot-Klassifikation verantwortlich sind. Diese strukturierte Methode ermöglicht es, sprachübergreifende Daten effizient innerhalb einer vertrauten Pipeline-Umgebung zu verarbeiten.
Bedeutung für die KI-Branche
Die Verknüpfung von etablierten Bibliotheken für maschinelles Lernen wie Scikit-Learn mit modernen Large Language Models über Frameworks wie Scikit-LLM zeigt einen praktischen Weg auf, wie Entwickler bestehende Systeme erweitern können. Dies erleichtert die Implementierung mehrsprachiger Textklassifikationen, ohne dass dafür gänzlich neue Architekturparadigmen von Grund auf neu entwickelt werden müssen.
Häufig gestellte Fragen
Was ist der Zweck dieser Integration?
Der Zweck ist die Erstellung einer zweistufigen Scikit-Learn-Pipeline für mehrsprachige Textklassifikation unter Verwendung von Scikit-LLM.
Welche Funktionen werden durch die Sprachmodelle abgedeckt?
Die beiden vortrainierten Sprachmodelle werden für die Übersetzung und für die Zero-Shot-Klassifikation eingesetzt.