
产品发布LiquidAI模型量化深度学习
LiquidAI 发布 LFM2.5 Q4_0 检查点:基于量化感知蒸馏技术
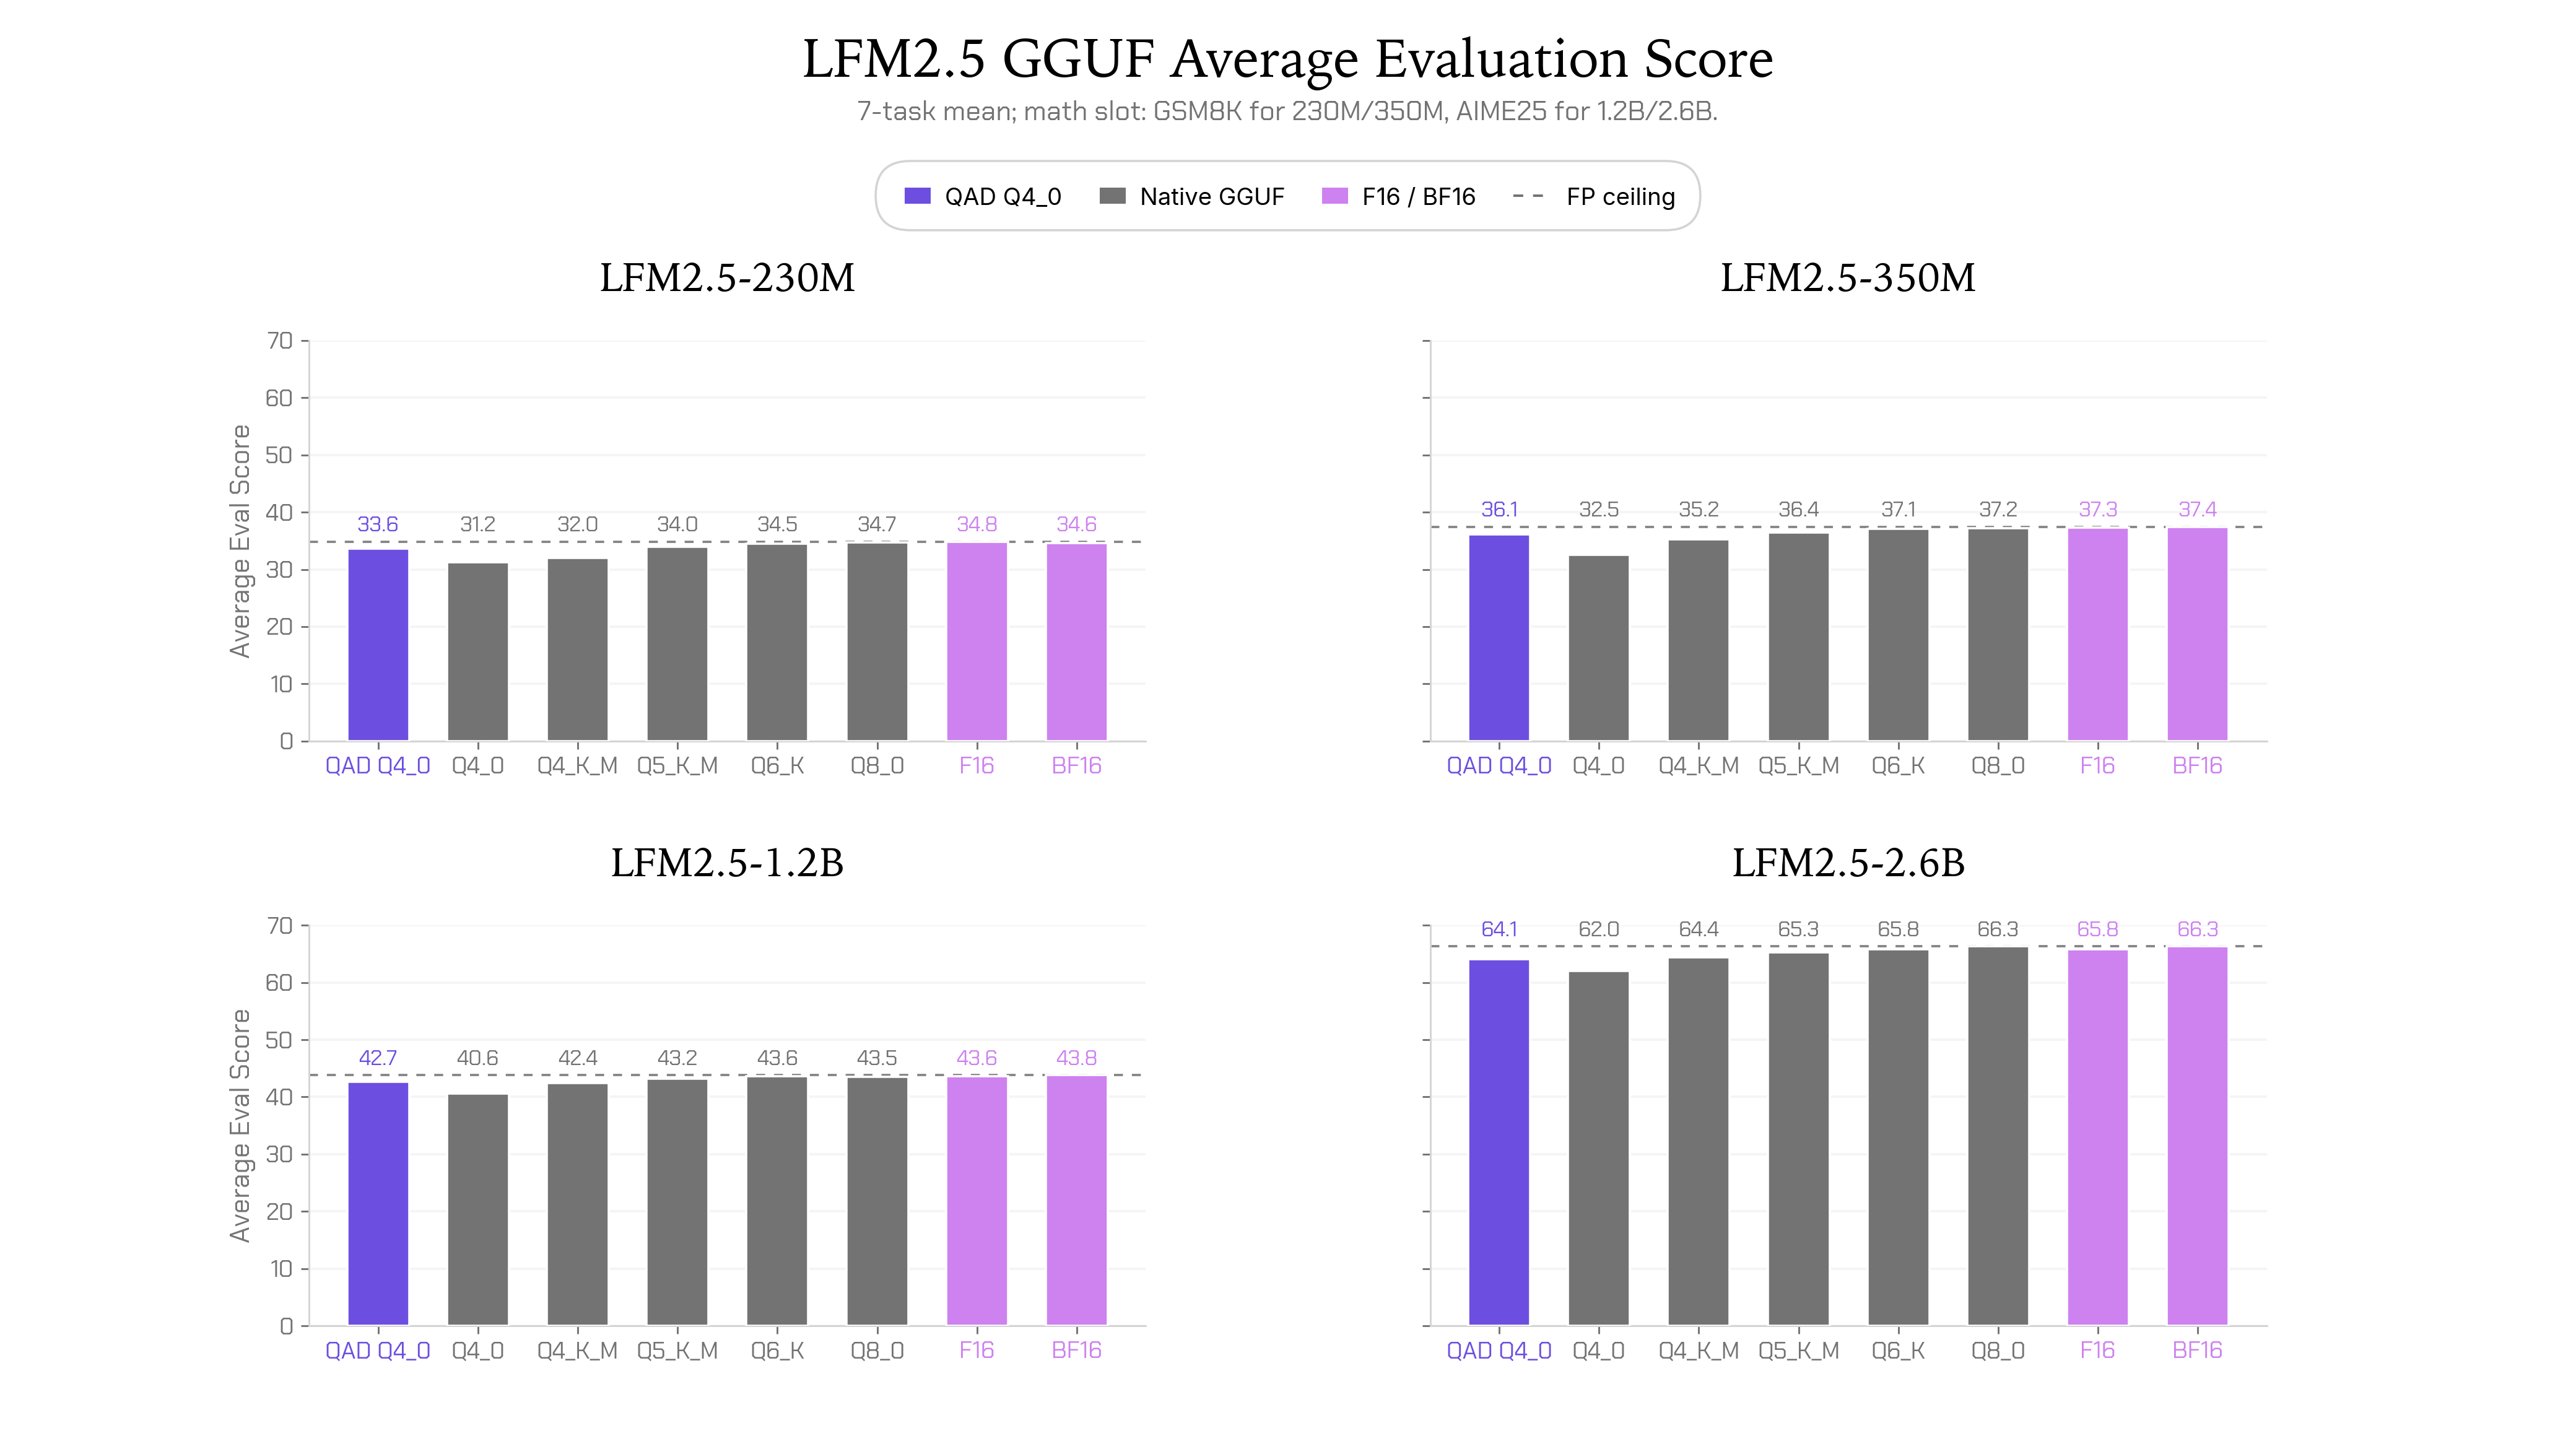
LiquidAI 在 Hugging Face 平台上正式发布了 LFM2.5 模型的 Q4_0 版本检查点。该版本采用了量化感知蒸馏(Quantization-Aware Distillation, QAD)技术,旨在通过先进的蒸馏手段优化模型在低比特量化环境下的性能表现,为高效推理提供支持。
Hugging Face Blog
核心要点
- 模型发布:LiquidAI 发布了 LFM2.5 模型的 Q4_0 量化版本检查点。
- 核心技术:该版本通过量化感知蒸馏(QAD)技术构建,而非传统的后量化方法。
- 平台支持:相关权重已在 Hugging Face Blog 及模型库中同步上线。
- 优化目标:旨在降低模型部署门槛,同时尽可能保留原始模型的精度。
详细分析
LFM2.5 Q4_0 检查点的推出
根据 LiquidAI 在 Hugging Face 发布的最新动态,LFM2.5 模型现已提供 Q4_0 格式的检查点。Q4_0 是一种主流的 4-bit 量化方案,能够显著减少模型运行时的显存占用并提升推理速度。这一发布为需要在资源受限环境下部署高性能模型的开发者提供了新的选择。
量化感知蒸馏(QAD)的技术应用
本次发布的核心亮点在于使用了“量化感知蒸馏”技术。传统的量化通常在模型训练完成后进行,往往会导致精度损失。而 QAD 技术在蒸馏过程中引入了量化感知机制,通过教师模型的指导,使学生模型在 4-bit 量化状态下依然能够学习到高精度的特征表达,从而在压缩体积的同时,最大程度地缓解精度下降问题。
行业影响
LiquidAI 对 QAD 技术的应用展示了模型压缩领域的新趋势。随着大模型规模的不断扩大,如何在不牺牲性能的前提下实现轻量化部署成为行业痛点。通过量化感知蒸馏,开发者可以更有效地将复杂模型迁移至端侧设备或低成本服务器上,这将进一步推动 AI 技术的普及和落地应用。
常见问题
什么是 Q4_0 量化?
Q4_0 是一种将模型权重压缩至 4 位的量化格式。它通过降低数值精度来换取更小的模型体积和更快的计算速度,是目前大模型本地化部署中常用的技术手段。
量化感知蒸馏(QAD)与普通量化有何区别?
普通量化通常是静态的后处理过程,而 QAD 是在模型蒸馏(训练)阶段就考虑了量化带来的影响。通过这种方式,模型能够提前适应量化带来的精度损失,从而在最终的量化检查点中表现出更强的鲁棒性。
