LFM2.5 Q4_0 Checkpoints: LiquidAI veröffentlicht neue Modelle mittels Quantization-Aware Distillation
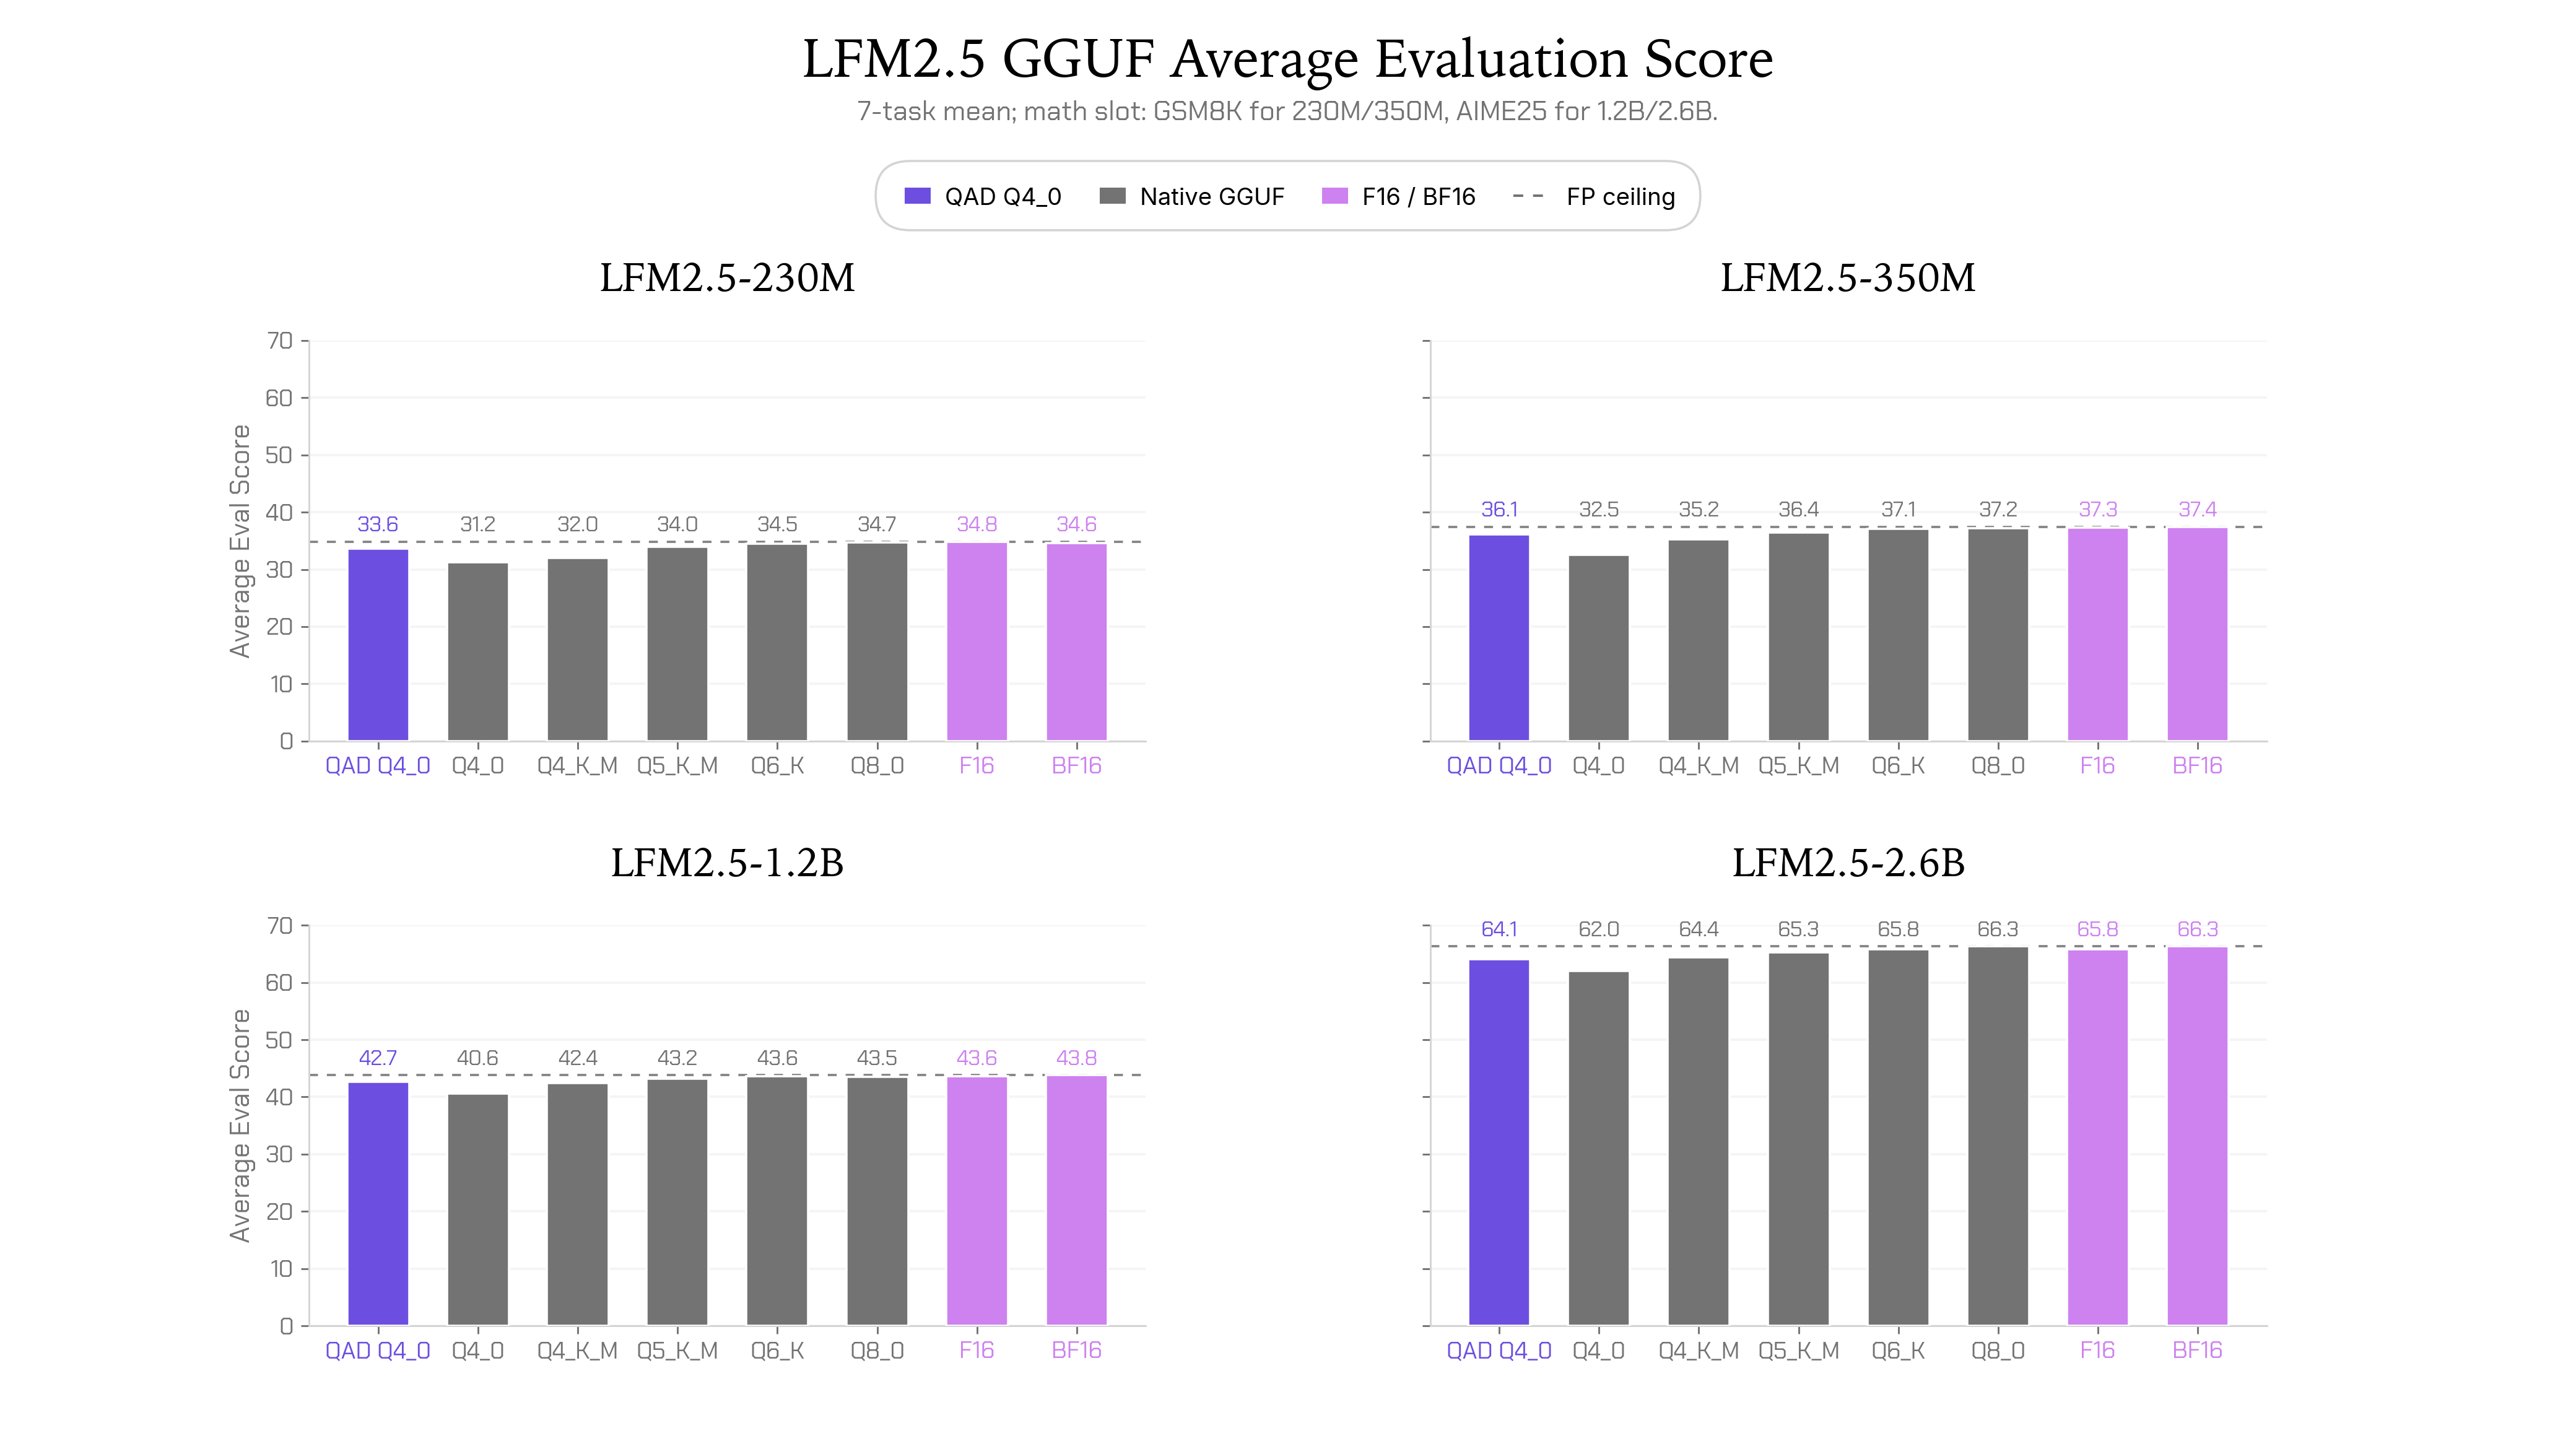
Am 19. August 2026 wurden neue Checkpoints für das Modell LFM2.5 auf dem Hugging Face Blog angekündigt. Diese speziellen Modellversionen nutzen das Q4_0-Quantisierungsformat und wurden durch das Verfahren der Quantization-Aware Distillation (QAD) optimiert. Die Veröffentlichung durch LiquidAI markiert einen technischen Fortschritt in der Bereitstellung effizienter KI-Modelle. Der Fokus liegt hierbei auf der Kombination von Quantisierung und Destillation, um leistungsfähige Checkpoints im Q4_0-Standard anzubieten. Diese Entwicklung unterstreicht die Bemühungen, hochperformante Modelle in ressourcenschonenden Formaten für die Community auf Hugging Face zugänglich zu machen.
Die wichtigsten Punkte
- Veröffentlichung von LFM2.5 Checkpoints: Neue Modellversionen für LFM2.5 sind verfügbar.
- Q4_0-Quantisierung: Die Checkpoints liegen im spezifischen Q4_0-Format vor.
- Quantization-Aware Distillation (QAD): Die Modelle wurden durch ein kombiniertes Verfahren aus Quantisierung und Wissensdestillation erstellt.
- Plattform-Release: Die Ankündigung und Bereitstellung erfolgten über den Hugging Face Blog.
Analyse
Fokus auf LFM2.5 und das Q4_0-Format
Die aktuelle Veröffentlichung konzentriert sich auf die Bereitstellung von Checkpoints für das Modell LFM2.5. Ein zentraler Aspekt dieser Meldung ist die Verwendung des Q4_0-Formats. Bei diesem Format handelt es sich um eine spezifische Form der Quantisierung, die darauf abzielt, die Modellgröße zu reduzieren und gleichzeitig die Effizienz bei der Ausführung zu steigern. Die Bereitstellung dieser Checkpoints ermöglicht es Nutzern, LFM2.5 in einer optimierten Form einzusetzen, die weniger Speicherplatz beansprucht als unkomprimierte Versionen.
Die Tatsache, dass diese Checkpoints explizit als Ergebnis einer technischen Optimierung ausgewiesen werden, deutet auf einen hohen Standard in der Modellpflege hin. Durch die Konzentration auf das Q4_0-Format wird eine Balance zwischen Rechenaufwand und Modellpräzision angestrebt, die für verschiedene Anwendungsszenarien in der KI-Entwicklung von Bedeutung ist.
Methodik: Quantization-Aware Distillation
Ein wesentliches Merkmal der neuen LFM2.5 Checkpoints ist ihre Entstehungsweise durch Quantization-Aware Distillation (QAD). Laut der Originalmeldung ist dies das primäre Verfahren, mit dem die Q4_0-Checkpoints generiert wurden. Bei diesem Prozess wird die Quantisierung – also die Reduktion der Genauigkeit der Modellparameter – bereits während der Destillationsphase berücksichtigt.
Anstatt ein Modell erst nachträglich zu quantisieren, wird bei der Quantization-Aware Distillation der Wissensstransfer von einem größeren Lehrermodell auf das kleinere LFM2.5-Modell so gestaltet, dass die Verluste, die normalerweise durch eine 4-Bit-Quantisierung (Q4_0) entstehen würden, minimiert werden. Dies führt zu Checkpoints, die trotz ihrer geringeren Bit-Tiefe eine höhere Leistungsfähigkeit beibehalten sollen, als dies bei herkömmlichen Quantisierungsmethoden der Fall wäre.
Bedeutung für die KI-Branche
Die Veröffentlichung der LFM2.5 Q4_0 Checkpoints via Quantization-Aware Distillation zeigt einen klaren Trend in der KI-Branche auf: Die Optimierung von Modellen für den praktischen Einsatz steht zunehmend im Vordergrund. Durch die Kombination von Destillation und Quantisierung wird die Hürde für den Einsatz leistungsstarker Modelle gesenkt.
Für Entwickler und Unternehmen bedeutet dies, dass spezialisierte Modelle wie LFM2.5 in Formaten vorliegen, die auch auf Hardware mit begrenzten Ressourcen effizient laufen können. Die Nutzung der Hugging Face Plattform als Distributionskanal stellt zudem sicher, dass diese technologischen Fortschritte einer breiten Masse an Forschern und Entwicklern unmittelbar zur Verfügung stehen.
Häufig gestellte Fragen
Was wurde für LFM2.5 veröffentlicht?
Es wurden neue Modell-Checkpoints veröffentlicht, die im Q4_0-Format vorliegen und durch das Verfahren der Quantization-Aware Distillation optimiert wurden.
Welches Verfahren wurde zur Erstellung der Checkpoints genutzt?
Die Checkpoints wurden mittels Quantization-Aware Distillation (QAD) erstellt, einem Prozess, der Quantisierung und Wissensdestillation kombiniert.
Wo sind die LFM2.5 Q4_0 Checkpoints zu finden?
Die Informationen und die entsprechenden Modelle wurden über den Hugging Face Blog von LiquidAI zugänglich gemacht.