MOVO AI
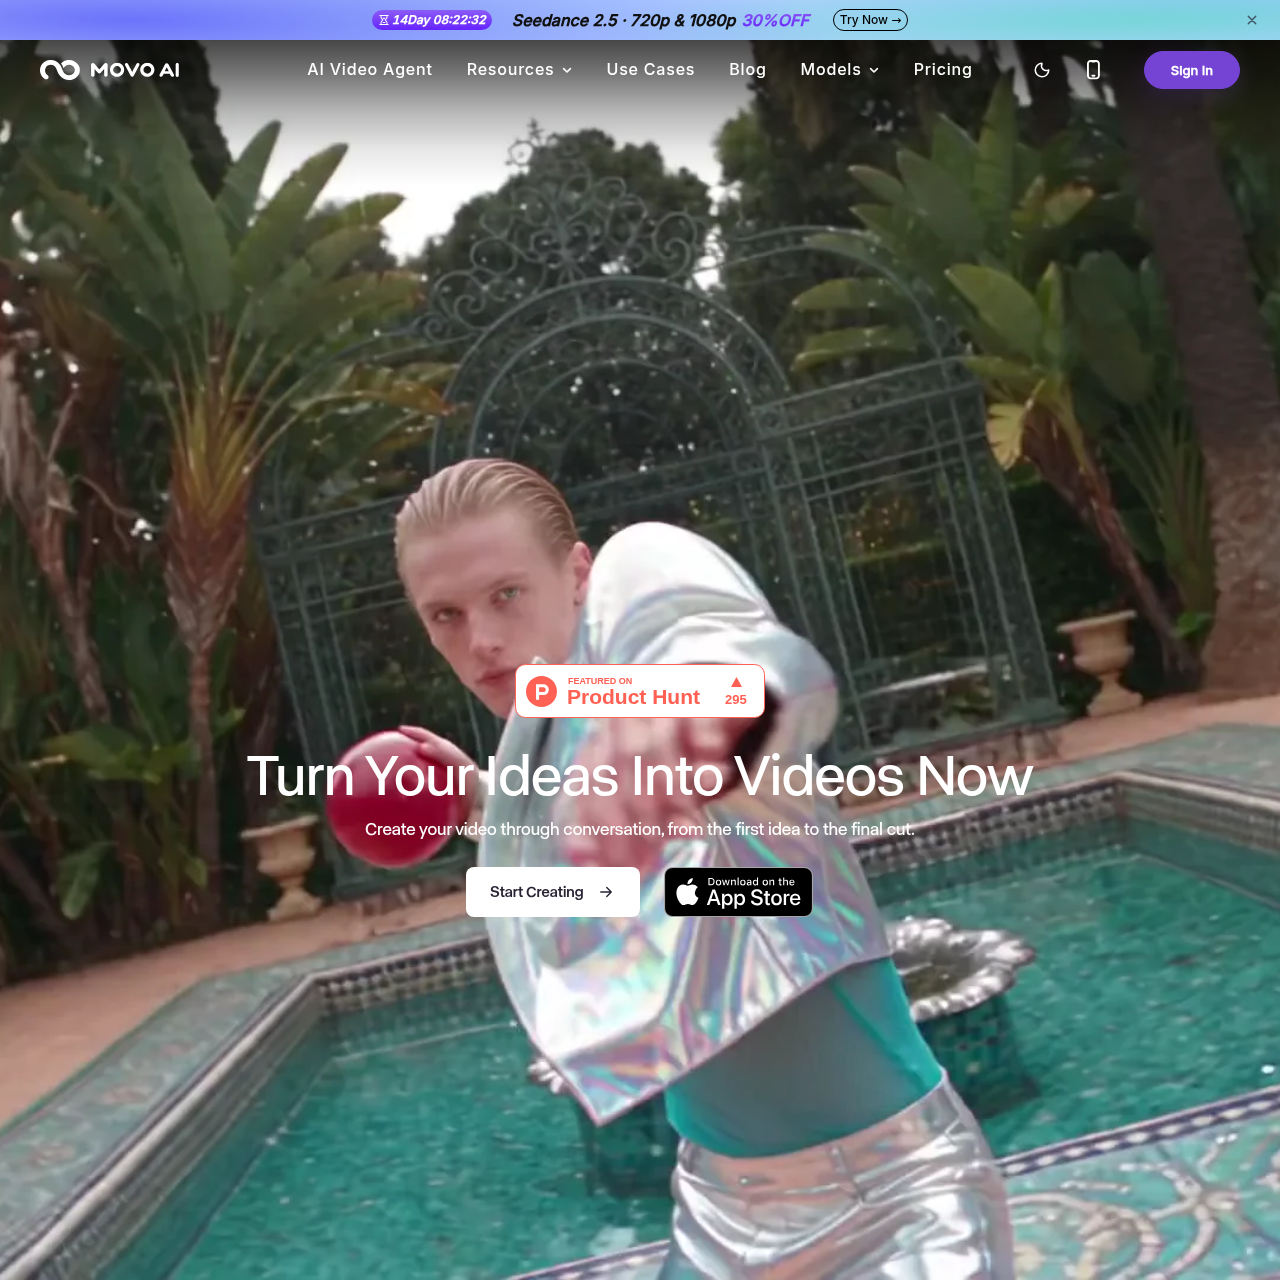
MOVO AIは、テキストプロンプトやリファレンスアセットから、キャラクターや視覚的な一貫性を保ちながら長尺動画や複数シーンで構成されるストーリー動画を制作できる対話型動画生成エージェントです。
製品の機能と公式な位置づけ
MOVO AIは、自然な対話、コンセプトプロンプト、リファレンスアセットを完成された動画コンテンツへと変換するために設計されたエージェント型動画制作システムです。従来のマルチトラックタイムライン編集や個別クリップの生成に依存することなく、対話形式のチャット環境内でシーンの企画、視覚スタイルの調整、動画の合成を統括します。
本プラットフォームは、Seedance 2.5、Seedance 2.0、Nano Banana Pro、GPT Image 2.5、ElevenLabsなどの複数の特化型生成モデルを統合しています。120秒を超えるストーリー動画の生成が可能な長尺制作に焦点を当てており、シーン間で文脈を保持することで、キャラクター、物体、環境の視覚的連続性を維持します。
公式情報で確認できる活用例
クリエイターは、キャラクターやシーンの連続性を損なうことなく、120秒を超える長尺のストーリー動画、エピソード形式のコンテンツ、または短編映画を制作できます。
マーケティングや制作チームは、スタイルのリファレンスを提供し、チャットを通じた対話的なフィードバックを繰り返すことで、プロモーション動画やブランド広告を作成できます。
公式情報に記載された利用手順
入力されたプロンプト、参考情報、アップロードされたアセットを分析し、シーン、雰囲気、視覚的な展開の方向性を想定します。
コンセプトを個別のシーンへと構造化し、ユーザーからのフィードバックを活用してペース配分、スタイル、視覚的な詳細を調整します。
エージェントが選定された動画クリップを統合し、統一感のある1本の完成された映像作品として仕上げます。
過去に登場したキャラクター、製品、シーン、視覚スタイルを記憶し、その後の生成作業に反映させます。
MOVO AIは、構想の立案からシーンの企画、最終的なクリップの合成に至るまでを網羅する自律型エージェントワークフローを通じて動画生成を行います。ユーザーはチャットインターフェース上でテキストによる指示、参考メディア、段階的なフィードバックを直接提供できるため、従来の動画編集タイムラインや断片的な生成ツールを経由する必要がありません。
本プラットフォームが強調する中核的な技術力の一つが、シーンと被写体の永続性です。一連の生成処理を通じてコンテキストをキャッシュすることにより、エージェントは120秒を超えるストーリー構成においても、キャラクター、舞台設定、登場する製品の外観の一貫性を維持します。
自分の素材とワークフローで確認したい項目
確認した情報源とその日時
情報源を確認した製品情報に基づく回答
MOVO AIは、自然言語とリファレンスメディアを用いた対話型インターフェースを通じて、長尺ストーリーを含む完成された動画を制作できるAI動画制作エージェントです。
MOVO AIはWebブラウザ上で利用できるほか、専用のMOVO AIモバイルアプリケーションを介してモバイルデバイスでも利用可能です。
本プラットフォームには、Seedance 2.5、Seedance 2.0、Nano Banana Pro、GPT Image 2.5、ElevenLabsなど、複数の生成モデルが統合されています。
公式の仕様書によると、MOVO AIはSeedance 2.5モデルを使用する際に720pおよび1080pの動画解像度をサポートしています。
MOVO AIは、キャラクター、製品、シーン、視覚スタイルを記憶するコンテキストメモリ機構を活用することで、長尺動画全体の一貫性を維持しています。