MOVO AI
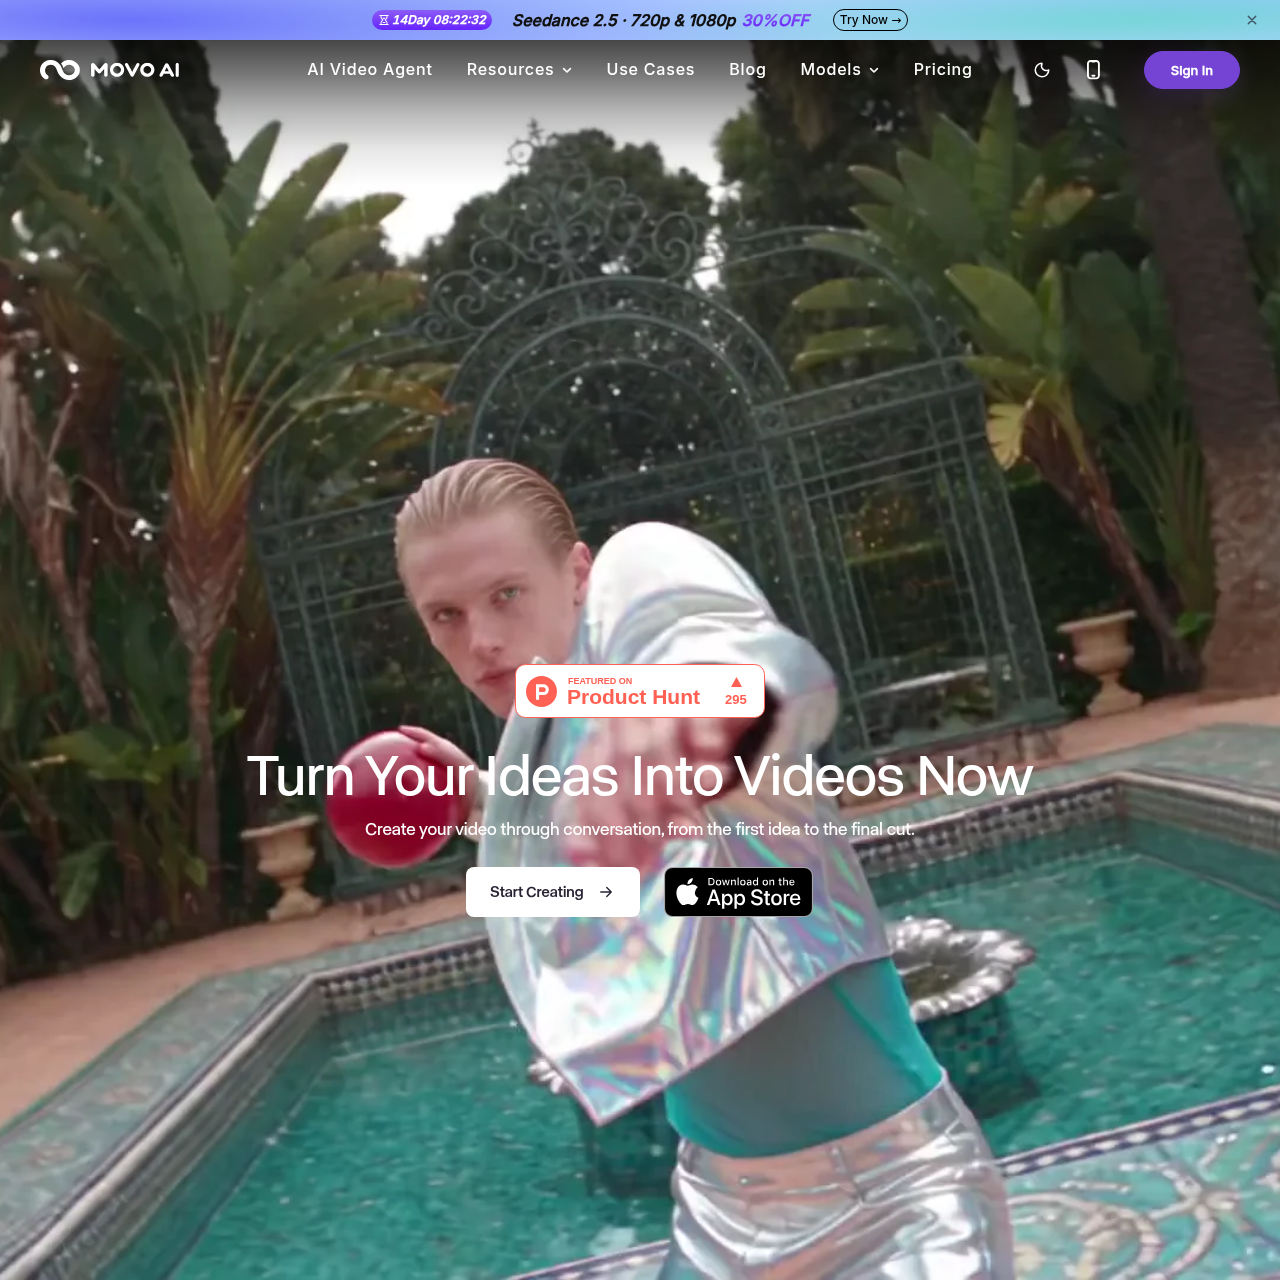
MOVO AI는 텍스트 프롬프트와 참조 에셋을 기반으로 캐릭터와 시각적 일관성을 유지하면서 장편 비디오와 다중 장면 서사를 제작하는 대화형 비디오 생성 에이전트입니다.
제품의 기능과 공식 포지셔닝
MOVO AI는 자연스러운 대화, 콘셉트 프롬프트, 참조 에셋을 완성된 비디오 콘텐츠로 변환하도록 설계된 에이전틱 비디오 제작 시스템으로 작동합니다. 기존의 다중 트랙 타임라인 편집이나 분절된 클립 생성에 의존하는 대신, 대화형 채팅 환경 내에서 장면 기획, 시각적 스타일 매칭, 비디오 구성을 유기적으로 조율합니다.
이 플랫폼은 Seedance 2.5, Seedance 2.0, Nano Banana Pro, GPT Image 2.5, ElevenLabs를 포함한 여러 특화 생성 모델을 통합합니다. 특히 120초를 초과하는 서사를 생성하면서도 장면 간 컨텍스트를 유지하여 캐릭터, 사물, 환경의 시각적 연속성을 보존하는 장편 영상 제작에 중점을 둡니다.
공식 출처로 확인된 활용 사례
창작자는 캐릭터와 장면의 연속성을 유지하면서 120초를 초과하는 긴 서사 비디오, 에피소드형 콘텐츠, 단편 영화를 제작할 수 있습니다.
마케팅 및 프로덕션 팀은 스타일 레퍼런스를 제공하고 반복적인 채팅 피드백을 주고받으며 홍보 영상과 브랜드 광고를 구축할 수 있습니다.
공식 문서에 안내된 사용 절차
시스템은 입력 프롬프트, 참조 자료 및 업로드된 에셋을 분석하여 장면, 분위기, 시각적 방향을 구상합니다.
플랫폼은 콘셉트를 개별 장면으로 구조화하고 사용자의 피드백을 반영하여 템포, 스타일, 시각적 세부 사항을 다듬습니다.
에이전트는 선택된 비디오 클립들을 결합하여 하나의 완성도 높고 조화로운 비디오 프레젠테이션으로 합성합니다.
이 도구는 이전 캐릭터, 제품, 장면 및 시각적 스타일을 기억하여 후속 제작 과정에 일관되게 반영합니다.
MOVO AI는 개념화, 기획, 최종 클립 구성에 이르는 전 과정을 자율 에이전트 워크플로를 통해 비디오 생성에 접근합니다. 사용자는 기존의 비디오 편집 타임라인이나 단편적인 생성 유틸리티를 거치지 않고, 채팅 인터페이스 내에서 직접 텍스트 설명, 참조 미디어, 반복적인 피드백을 제공합니다.
이 플랫폼이 강조하는 핵심 기술적 역량은 장면 및 피사체의 지속성입니다. 순차적인 생성 과정 전반에 걸쳐 컨텍스트를 캐싱함으로써, 에이전트는 120초를 넘어서는 서사 시퀀스 전반에서 캐릭터, 배경, 주요 제품의 외형을 일관되게 유지합니다.
본인의 자료와 작업 흐름으로 직접 확인할 항목
확인한 출처와 확인 시점
출처를 확인한 제품 정보를 바탕으로 한 답변
MOVO AI는 자연어 대화와 참조 미디어를 활용하는 대화형 인터페이스를 통해 장편 서사를 포함한 완성된 비디오를 제작하는 AI 비디오 프로덕션 에이전트입니다.
MOVO AI는 웹 브라우저를 통해 접속할 수 있으며, 전용 MOVO AI 모바일 애플리케이션을 통해 모바일 기기에서도 이용할 수 있습니다.
이 플랫폼은 Seedance 2.5, Seedance 2.0, Nano Banana Pro, GPT Image 2.5, ElevenLabs 등 다양한 특화 생성형 모델을 통합하여 구동됩니다.
공식 문서 사양에 따르면 MOVO AI는 Seedance 2.5 모델을 사용할 때 720p 및 1080p 비디오 해상도 출력을 지원합니다.
MOVO AI는 캐릭터, 제품, 장면, 시각적 스타일을 기억하는 컨텍스트 메모리 메커니즘을 활용하여 장편 비디오 전반의 일관성과 응집력을 유지합니다.