Onepin
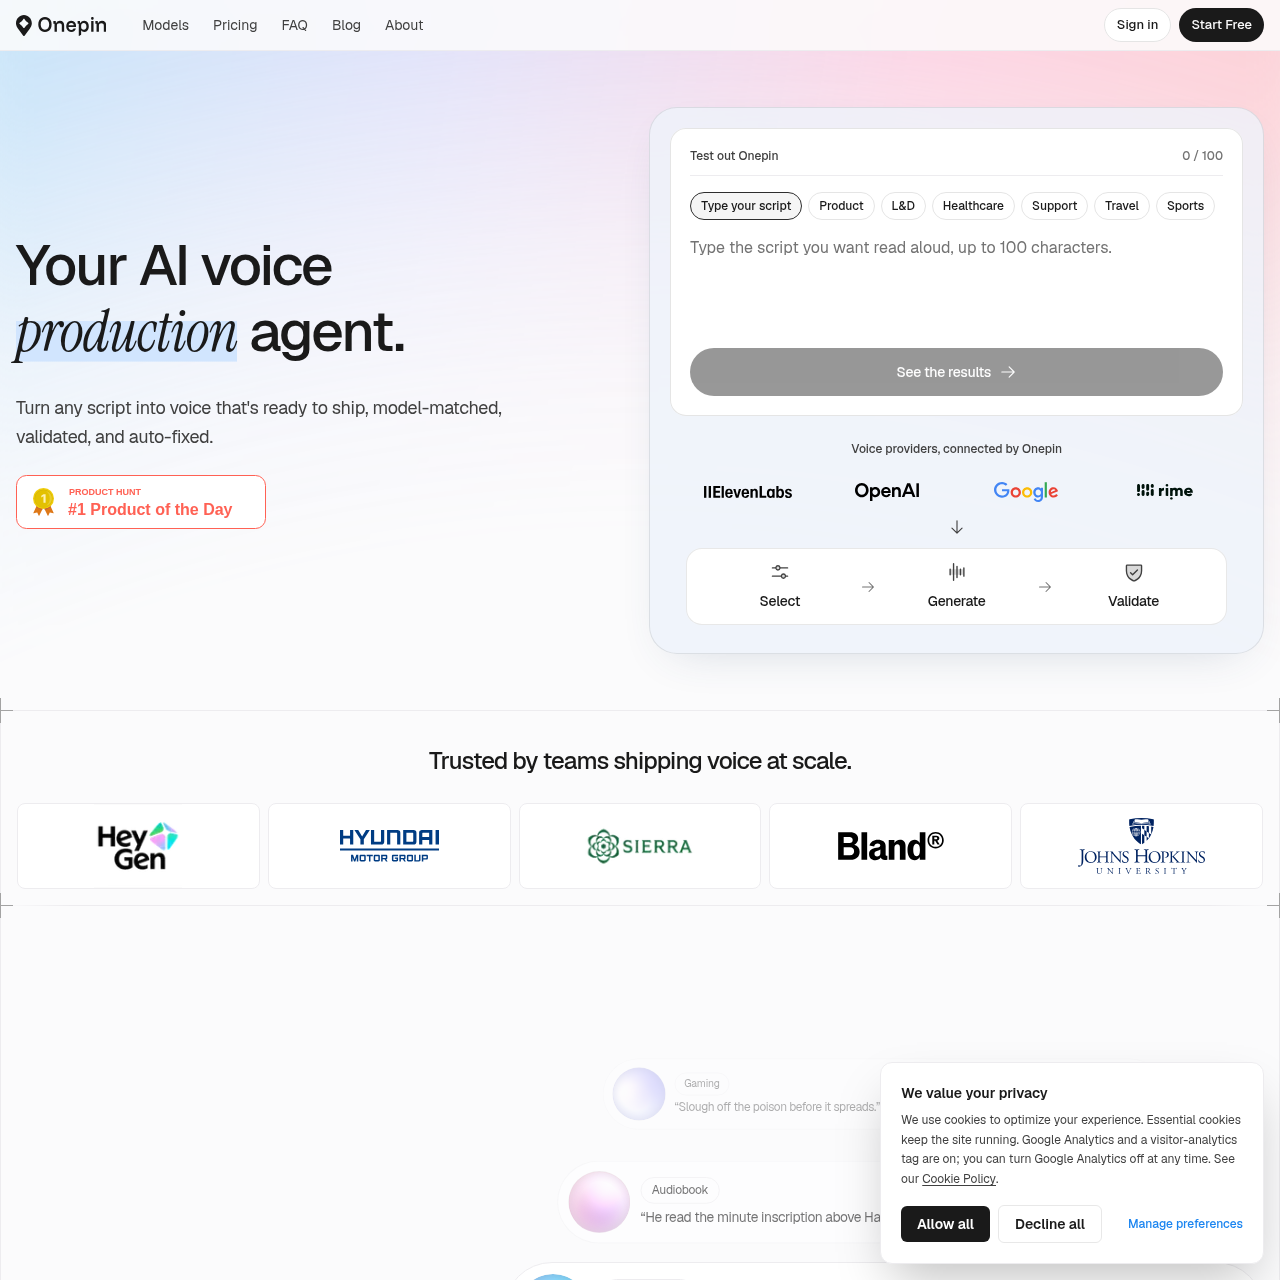
Onepin ist ein KI-Sprachproduktions-Agent, der Textskripte über mehr als 30 Text-to-Speech-Modelle verteilt und automatisierte Textnormalisierung, Aussprachewörterbücher, zeilenweise Qualitätsprüfungen sowie selektive Neuaufnahmen anwendet.
Funktion und offizielle Positionierung des Produkts
Onepin bietet einen automatisierten Sprachproduktions-Agenten, der die Skriptsynthese über externe Text-to-Speech-Anbieter hinweg koordiniert. Anstatt sich auf eine einzelne Engine zu verlassen, vereint der Dienst mehr als 30 Modelle unter einem Konto, sodass Zeilen über unterschiedliche Anbieter hinweg weitergeleitet und generiert werden können.
Die Plattform setzt auf eine Textvorbereitung vor der Synthese sowie eine Qualitätskontrolle im Anschluss. Texteingaben durchlaufen eine automatisierte Bereinigung von Abkürzungen und Datumsangaben, gefolgt von phonetischen Abgleichen mit einem umfangreichen Wörterbuch. Nach der Synthese werden die Ausgaben nach Natürlichkeit, Genauigkeit, Klarheit und Aussprache bewertet, was bei fehlgeschlagener Validierung eine automatische Neuaufnahme auslöst.
Durch offizielle Quellen belegte Anwendungsfälle
Erstellung von Sprachspuren für Lern- und Gesundheits-Skripte, die komplexe Medikamentennamen, anatomische Begriffe oder wissenschaftliche Formulierungen enthalten.
Verteilung von Dialog- und Werbeskripten auf verschiedene Sprach-Engines bei gleichzeitiger Durchsetzung standardisierter Aussprache- und Qualitätsprüfungen.
Der dokumentierte Ablauf, sofern verfügbar
Das System bereinigt Eingabetexte, indem es Straßennamen, Datumsangaben, Zahlenwerte und Abkürzungen ausschreibt, bevor der Text an die Sprach-Engines übergeben wird.
Markennamen, Eigennamen und spezialisierte Fachbegriffe werden mit einem Wörterbuch aus vier Millionen Wörtern abgeglichen, um eine korrekte phonetische Wiedergabe sicherzustellen.
Synthetisierte Audiozeilen werden anhand festgelegter Benchmarks auf Natürlichkeit, Wortgenauigkeit, Klarheit und Aussprache analysiert und bewertet.
Wenn eine Ausgabezeile die Validierung nicht besteht, passt das System Modellparameter an, um die vollständige Zeile neu zu generieren oder das spezifische fehlerhafte Wort zu korrigieren.
Onepin fungiert als Orchestrierungs- und Qualitätskontrollschicht zwischen geschriebenen Skripten und externen Sprachsynthese-Engines. Skripte werden über einen Katalog von mehr als 30 Text-to-Speech-Anbietern verteilt, darunter OpenAI, ElevenLabs, Google, Microsoft, AWS, Cartesia, Murf AI, Deepgram, MiniMax und Inworld.
Der Generierungsworkflow automatisiert gängige manuelle Bearbeitungsschritte durch mehrstufige Vorbereitung und Korrektur. Normalisierungsregeln wandeln komplexe Formate wie Datumsangaben und Straßenadressen vor der Erstellung in gesprochene Ausdrücke um, während die Bewertung nach der Generierung Mängel erkennt und Zeilen automatisch neu aufnimmt.
Prüfungen mit eigenen Inhalten und Arbeitsabläufen
Welche Quellen wann geprüft wurden
Antworten auf Basis des quellengeprüften Produkteintrags
Onepin verwendet einen Normalisierer, der Abkürzungen, Straßenadressen, Datumsangaben und Zahlen über mehrere Sprachen hinweg in ihre gesprochenen Entsprechungen umwandelt, bevor der Text an die Synthese-Engines übergeben wird.
Die Plattform bindet ein Aussprachewörterbuch mit vier Millionen Wörtern ein, das phonetische Aussprachen für Markennamen, Eigennamen sowie spezialisierte wissenschaftliche und pharmazeutische Begriffe bereitstellt.
Onepin vereint mehr als 30 Sprachmodelle unter einem Konto, darunter Engines von ElevenLabs, OpenAI, Google, Microsoft, AWS, Cartesia, Murf AI, Deepgram, MiniMax und Inworld.
Jede generierte Audiozeile wird anhand von vier spezifischen Metriken bewertet: Natürlichkeit, Wortgenauigkeit, Klarheit und Aussprache, basierend auf einheitlichen Bewertungsmaßstäben über alle unterstützten Sprachen hinweg.
Das System leitet automatisch einen Korrekturprozess ein und nimmt entweder die gesamte Zeile mit angepassten Modelleinstellungen neu auf oder generiert ausschließlich das spezifische Wort neu, das die Validierung verfehlt hat.