Offene Modellgewichte oder kommerzielle LLMs: Ein Entscheidungsrahmen für die Modellauswahl 2026
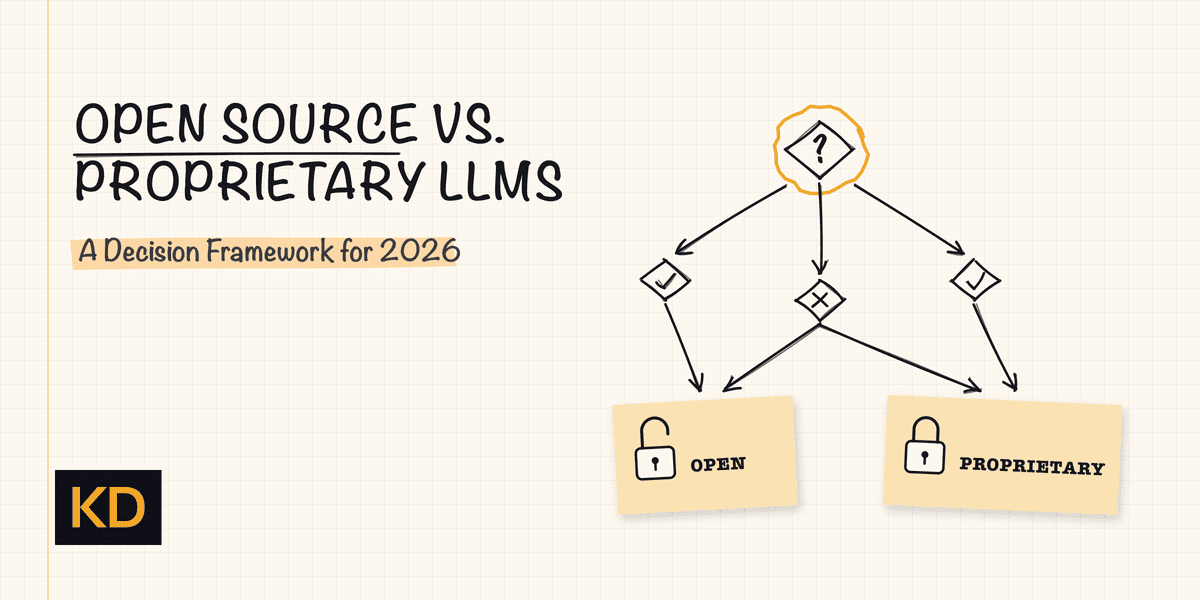
Vinod Chugani stellt bei KDnuggets einen praktischen Leitfaden zur Wahl zwischen großen Sprachmodellen mit offenen Gewichten und kommerziellen Modellen vor. Der für 2026 formulierte Entscheidungsrahmen setzt beim konkreten Anwendungsfall an: Entscheidend ist nicht, welche Modellart allgemein vorzuziehen ist, sondern welche für den jeweiligen Einsatz passt. Dazu baut der Leitfaden auf vier Fragen auf, die laut Ankündigung für die Wahl ausschlaggebend sind. Während der englische Titel den Vergleich als Gegenüberstellung von Open Source und proprietären Sprachmodellen formuliert, spricht der Kurztext von Modellen mit offenen Gewichten und kommerziellen Modellen. Welche vier Fragen der Beitrag stellt und wie er sie auf die Modellauswahl anwendet, geht aus der vorliegenden Kurzmeldung nicht hervor.
Die wichtigsten Punkte
- Der Beitrag von Vinod Chugani erschien am 20. November 2026 bei KDnuggets.
- Er kündigt einen praktischen Leitfaden zur Wahl zwischen Sprachmodellen mit offenen Gewichten und kommerziellen Modellen an.
- Vier Fragen bilden den Entscheidungsrahmen. Maßgeblich ist laut Kurzmeldung der konkrete Anwendungsfall.
- Die Kurzmeldung nennt weder den Wortlaut der vier Fragen noch eine Empfehlung für ein bestimmtes Modell.
Analyse
Die Modellwahl beginnt beim Anwendungsfall
Vinod Chuganis Beitrag behandelt die Wahl zwischen zwei Modellarten. Im englischen Titel stellt er Open Source und proprietäre große Sprachmodelle gegenüber. In der Beschreibung des Leitfadens lautet die Gegenüberstellung anders: Dort geht es um Modelle mit offenen Gewichten und kommerzielle Modelle. In beiden Formulierungen steht die Wahl zwischen den genannten Optionen im Vordergrund. Der Kurztext macht deutlich, worauf diese Wahl ausgerichtet ist: auf den jeweiligen Anwendungsfall.
Damit ist der Leitfaden nicht als Antwort auf die Frage angekündigt, welche Modellart grundsätzlich besser ist. Er soll vielmehr dabei helfen, die passende Option für einen konkreten Einsatz zu bestimmen. Das ist ein Unterschied in der Fragestellung: Eine allgemeine Rangfolge würde die Modellarten unabhängig vom Einsatz bewerten. Der angekündigte Rahmen behandelt dagegen den Einsatz als Bezugspunkt für die Entscheidung. Aus der Kurzmeldung ergibt sich entsprechend kein allgemeiner Vorrang für eine der beiden Seiten.
Der Titel ordnet den Entscheidungsrahmen dem Jahr 2026 zu. Die Beschreibung erläutert jedoch nicht, welche Rolle das Jahr für die Modellauswahl spielt. Sie nennt weder eine Veränderung gegenüber früheren Jahren noch einen Vergleich mit anderen Entscheidungsansätzen. Belegt ist deshalb der zeitliche Bezug im Titel, nicht aber ein Wandel bei den Kriterien für die Wahl. Inhaltlich liegt der Schwerpunkt der Ankündigung auf der praktischen Entscheidung für einen bestimmten Anwendungsfall.
Vier Fragen geben dem Leitfaden seine Struktur
Die Ankündigung beschreibt einen Rahmen, der um vier Fragen herum aufgebaut ist. Diese Fragen sollen laut Kurztext darüber entscheiden, welche Wahl für den jeweiligen Anwendungsfall richtig ist. Die Zahl der Fragen und ihre Funktion sind damit bekannt. Nicht bekannt ist dagegen, was genau gefragt wird und wie die Antworten zur Wahl eines Modells beitragen. Die Kurzmeldung beschreibt also den Aufbau des Leitfadens, ohne seine einzelnen Schritte wiederzugeben.
Das ist für die Einordnung des Beitrags wichtig. Aus der Ankündigung lässt sich ableiten, dass die vier Fragen den Vergleich strukturieren sollen. Sie liefert aber keine Grundlage dafür, einzelne Fragen zu rekonstruieren, sie zu gewichten oder eine Rangfolge zwischen ihnen anzugeben. Ebenso bleibt offen, ob die Fragen in einer bestimmten Reihenfolge beantwortet werden sollen. Eine Anleitung, die sich anhand der Kurzmeldung bereits Schritt für Schritt anwenden ließe, liegt damit nicht vor.
Auch das angekündigte Ziel ist von einem konkreten Ergebnis zu unterscheiden. Der Leitfaden soll zu einer passenden Wahl führen. Das bedeutet nicht, dass die Kurzmeldung diese Wahl für einen bestimmten Fall bereits trifft. Sie nennt keinen Anwendungsfall, für den sich der Autor auf eine Modellart festlegt, und führt kein einzelnes Modell an. Was sich aus der Meldung mitnehmen lässt, ist daher die Struktur der Entscheidung: Die Wahl soll sich am Einsatz orientieren und anhand von vier Fragen getroffen werden.
Titel und Kurztext verwenden unterschiedliche Begriffe
Der englische Titel verwendet die Begriffe „Open Source“ und „proprietär“. Der Kurztext beschreibt die Optionen dagegen als „Modelle mit offenen Gewichten“ und „kommerzielle Modelle“. Für eine quellentreue Wiedergabe ist es sinnvoll, diesen Unterschied sichtbar zu machen. Wer den Titel wiedergibt, beschreibt die dort verwendete Gegenüberstellung. Wer das Ziel des praktischen Leitfadens zusammenfasst, kann sich an die Formulierung des Kurztexts halten.
Die Meldung erklärt nicht, wie der Autor die Begriffe im vollständigen Beitrag voneinander abgrenzt. Sie enthält keine Definition der Modellarten und sagt nicht, ob die Bezeichnungen aus Titel und Beschreibung dort gleich verwendet werden. Aus der unterschiedlichen Wortwahl lässt sich deshalb keine zusätzliche Aussage darüber ableiten, wie bestimmte Modelle einzuordnen sind. Die Gemeinsamkeit beider Formulierungen liegt in der angekündigten Entscheidung zwischen den jeweils genannten Optionen, nicht in einer ausdrücklich erklärten Gleichsetzung der Begriffe.
Bedeutung für die KI-Branche
Für die Einordnung von Entscheidungen über große Sprachmodelle liegt der Schwerpunkt des Beitrags auf der Frage, welche Option zum vorgesehenen Einsatz passt. Der angekündigte Rahmen verbindet den Vergleich von Modellarten mit einer praktischen Auswahlentscheidung. Der Beitrag wird damit nicht als Modellrangliste vorgestellt, sondern als Leitfaden: Vier Fragen sollen dabei helfen, die Alternativen auf einen konkreten Anwendungsfall zu beziehen.
Die Kurzmeldung bietet allerdings keine Grundlage für weitergehende Aussagen über die KI-Branche. Sie dokumentiert weder einen allgemeinen Wechsel hin zu einer der beiden Optionen noch eine Überlegenheit bestimmter Modelle. Auch aus dem Bezug auf 2026 geht keine Prognose hervor. Die Bedeutung der Meldung liegt in dem angekündigten Ansatz zur Modellauswahl, nicht in einem belegten Branchentrend. Wie dieser Ansatz im Einzelnen funktioniert, lässt sich erst anhand der vier Fragen beurteilen, die im Kurztext nicht aufgeführt sind.
Häufig gestellte Fragen
Worum geht es in dem Entscheidungsrahmen für 2026?
Der Beitrag von Vinod Chugani kündigt einen praktischen Leitfaden an, mit dem sich zwischen großen Sprachmodellen mit offenen Gewichten und kommerziellen Modellen wählen lässt. Die Entscheidung richtet sich nach dem jeweiligen Anwendungsfall.
Welche vier Fragen stellt der Leitfaden?
Die vorliegende Kurzmeldung nennt die vier Fragen nicht. Sie sagt lediglich, dass der Leitfaden auf ihnen aufbaut und dass sie für die Wahl der passenden Option ausschlaggebend sein sollen.
Empfiehlt die Meldung offene Modellgewichte oder kommerzielle Modelle?
Nein. Die Kurzmeldung spricht keine allgemeine Empfehlung für eine der beiden Optionen aus. Sie kündigt einen Rahmen an, mit dem sich die Wahl für einen konkreten Einsatz treffen lässt.