Implementierung proaktiver, dauerhafter Agents mit dem Schedules SDK in Managed Deep Agents von LangChain
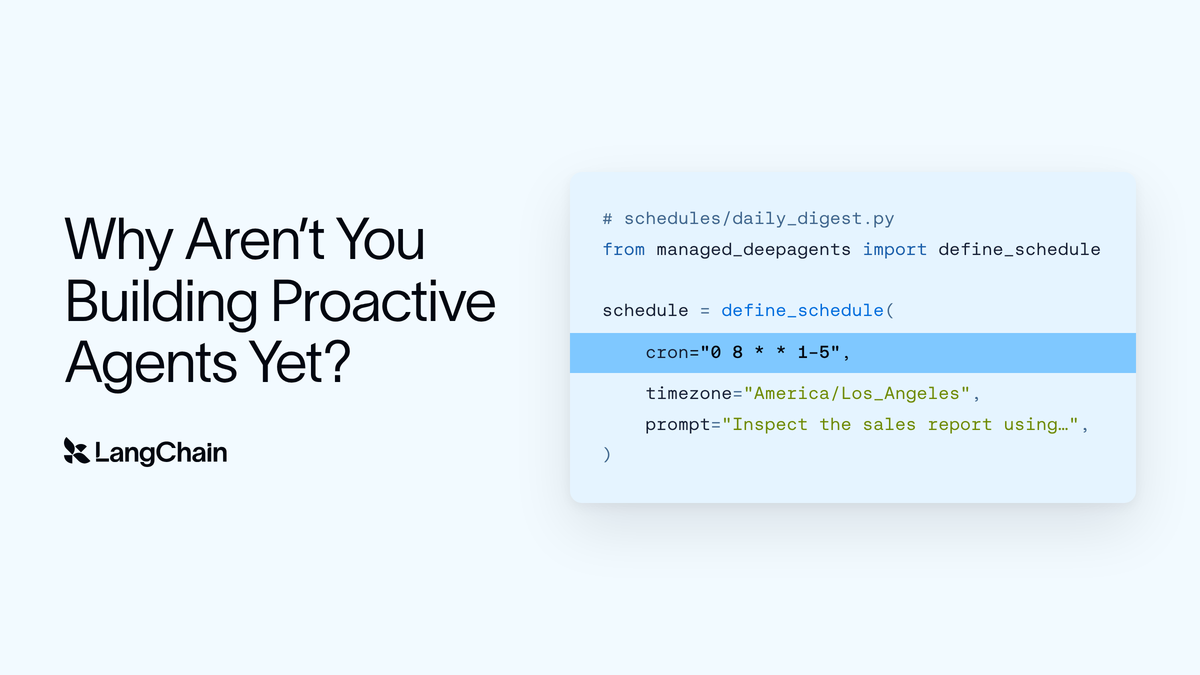
LangChain hat Informationen zur Entwicklung von proaktiven, 'Always-On'-Agents veröffentlicht, die das Schedules SDK innerhalb der Managed Deep Agents nutzen. Während viele dieser Agents bisher auf einfachen Cron-Jobs basierten, bietet das neue SDK erweiterte Möglichkeiten. Der Artikel beleuchtet, wie geplante Ausführungen („Scheduled Runs“) Funktionen wie ein verbessertes Gedächtnis und intelligente Triage-Prozesse freischalten können. Entwickler erfahren, wie sie diese Funktionen in ihre Managed Deep Agents integrieren, um deren Leistungsfähigkeit und Automatisierungsgrad zu steigern. Diese Entwicklung markiert einen Schritt weg von simplen zeitgesteuerten Skripten hin zu robusteren, proaktiven KI-Systemen, die eigenständig agieren und auf komplexe Anforderungen in Echtzeit reagieren können.
Die wichtigsten Punkte
- Nutzung des Schedules SDK für die Erstellung von "Always-On"-Agents.
- Ablösung einfacher Cron-Jobs durch dedizierte SDK-Lösungen für mehr Zuverlässigkeit.
- Aktivierung neuer Funktionen wie erweiterte Speicherverwaltung (Memory) und intelligente Triage.
- Integration in Managed Deep Agents zur Steigerung der Proaktivität.
Analyse
Vom Cron-Job zum dedizierten SDK
Traditionell basieren proaktive KI-Agents häufig auf einfachen Cron-Jobs, um zeitgesteuerte Aktionen auszuführen. Die von LangChain vorgestellte Methode mit dem Schedules SDK in Managed Deep Agents zielt darauf ab, diesen Prozess zu professionalisieren. Anstatt auf rudimentäre Zeitpläne angewiesen zu sein, ermöglicht das SDK eine tiefere Integration, die notwendig ist, um Agents nicht nur zeitgesteuert, sondern kontextbewusst und reaktionsfähig zu halten.
Mehrwert durch geplante Ausführungen
Geplante Ausführungen (Scheduled Runs) sind nicht mehr nur ein Trigger für Skripte, sondern ein Werkzeug zur Freischaltung erweiterter KI-Fähigkeiten. Laut LangChain profitieren Entwickler insbesondere bei der Implementierung von "Memory"-Funktionen und smarter Triage. Dies bedeutet, dass Agents in der Lage sind, Informationen über Zeiträume hinweg zu halten oder eingehende Anfragen intelligenter zu priorisieren, da der Prozess innerhalb des Managed-Deep-Agents-Ökosystems verwaltet wird.
Bedeutung für die KI-Branche
Die Fähigkeit, Agents "Always-On" zu schalten, ist ein entscheidender Faktor für die Skalierbarkeit von KI-Anwendungen in Unternehmen. Durch den Übergang von simplen Cron-Lösungen zu dedizierten SDK-Ansätzen wird die Zuverlässigkeit und Autonomie der Systeme erhöht. Dies ermöglicht KI-Agents, kontinuierlich Aufgaben zu überwachen und auszuführen, ohne dass eine manuelle Interaktion erforderlich ist.
Häufig gestellte Fragen
Was ermöglicht das Schedules SDK?
Das Schedules SDK erlaubt es, proaktive und permanent aktive Agents zu erstellen, die über einfache zeitgesteuerte Cron-Jobs hinausgehen und erweiterte Funktionen wie Speicher und intelligente Triage unterstützen.
Warum sollten Entwickler das SDK anstelle von Cron-Jobs verwenden?
Das SDK bietet eine nahtlose Integration in Managed Deep Agents, wodurch komplexe Aufgaben wie die Gedächtnisverwaltung und Priorisierung (Triage) effizienter umgesetzt werden können, als es bei einer rein externen Zeitsteuerung der Fall ist.