Klassifikator-Wahrscheinlichkeiten in scikit-learn kalibrieren: Fehlkalibrierung erkennen und mit zwei Verfahren korrigieren
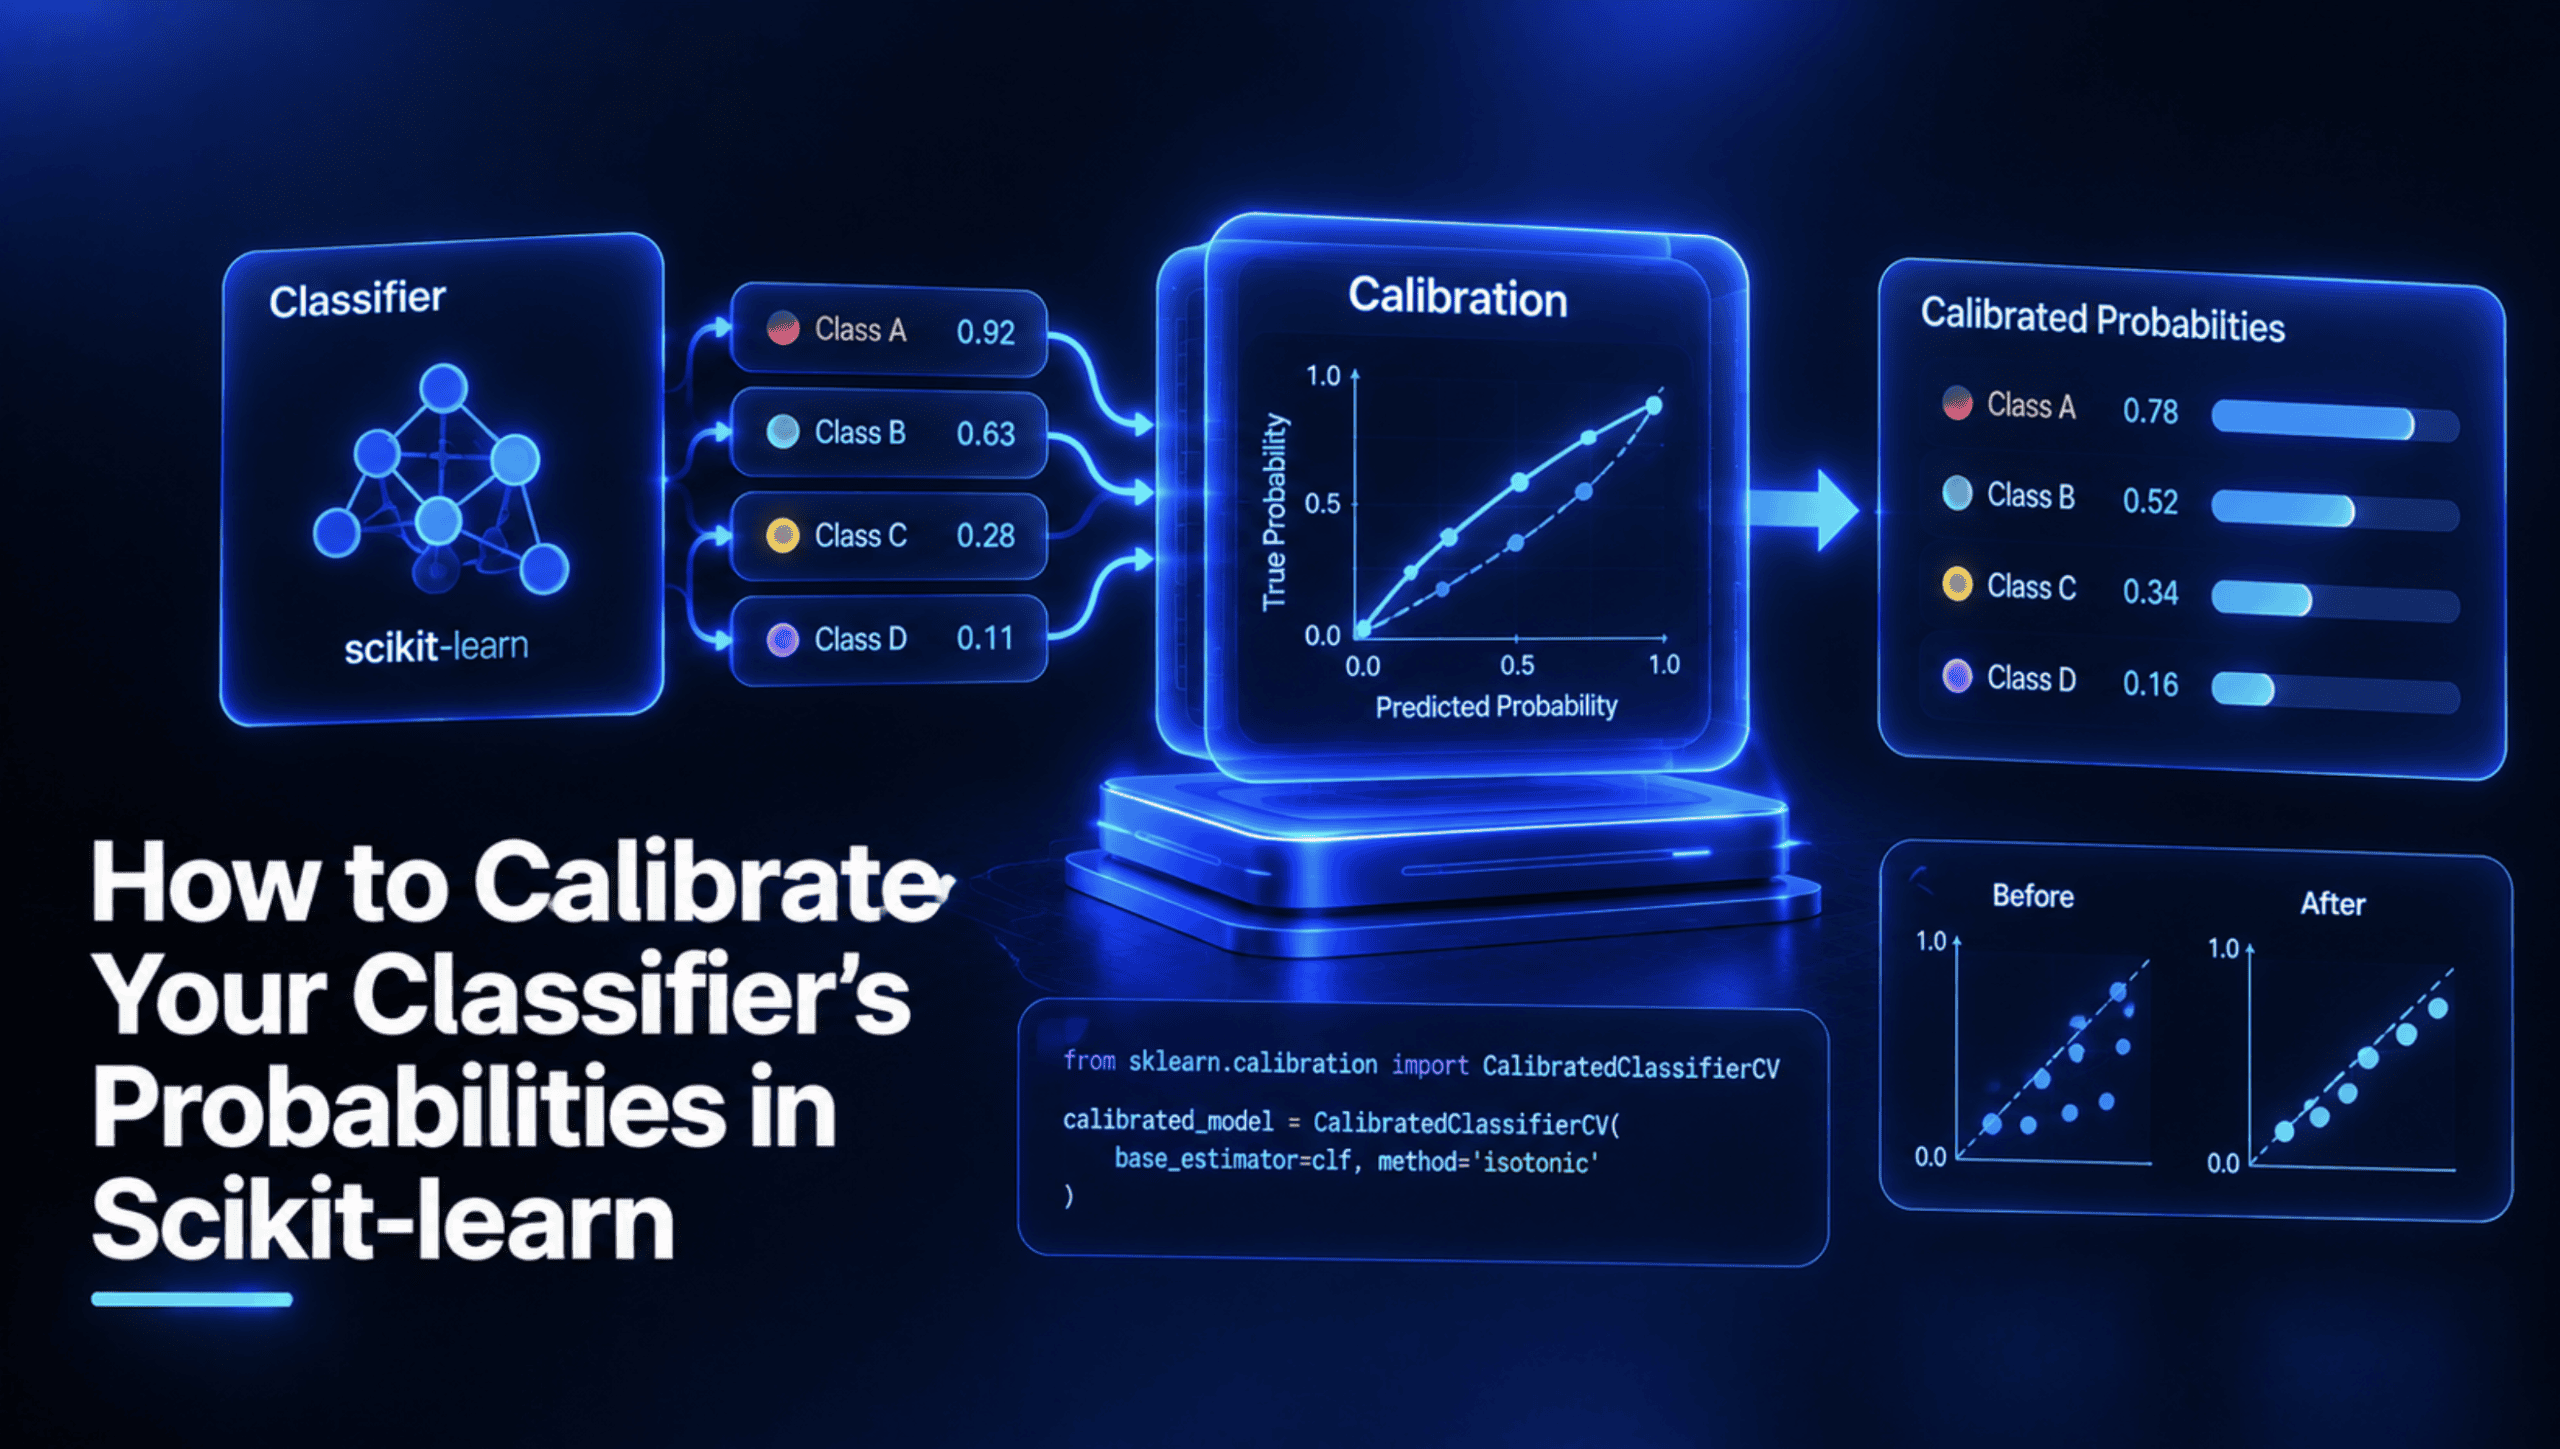
In einem Tutorial für KDnuggets zeigt Shittu Olumide, wie sich die Wahrscheinlichkeiten von Klassifikatoren in scikit-learn überprüfen und kalibrieren lassen. Die Anleitung beginnt mit dem Training zweier Klassifikatoren auf einem realen Datensatz. Anschließend macht sie deren Fehlkalibrierung mit einem Zuverlässigkeitsdiagramm und dem Brier-Score sichtbar. Damit verbindet das Tutorial eine grafische Darstellung mit einer Kennzahl, bevor es zur Korrektur übergeht. Dafür kommen zwei Verfahren zum Einsatz: die Platt-Skalierung und die isotone Regression. Der Ablauf reicht somit vom Modelltraining über die Prüfung der ausgegebenen Wahrscheinlichkeiten bis zu ihrer Kalibrierung. Im Mittelpunkt steht die Frage, wie sich eine Fehlkalibrierung erkennen lässt und welche Verfahren die Anleitung zu ihrer Korrektur einsetzt.
Die wichtigsten Punkte
- Das Tutorial von Shittu Olumide bei KDnuggets behandelt die Kalibrierung von Klassifikator-Wahrscheinlichkeiten in scikit-learn.
- Die Anleitung beginnt mit dem Training zweier Klassifikatoren auf einem realen Datensatz.
- Ein Zuverlässigkeitsdiagramm und der Brier-Score machen die Fehlkalibrierung der Wahrscheinlichkeiten sichtbar.
- Zur Korrektur setzt das Tutorial Platt-Skalierung und isotone Regression ein.
Analyse
Das Training liefert den Ausgangspunkt für die Prüfung
Im Mittelpunkt des Tutorials stehen die Wahrscheinlichkeiten, die Klassifikatoren ausgeben. Der erste Schritt besteht darin, zwei Klassifikatoren mit scikit-learn auf einem realen Datensatz zu trainieren. Die Modellwahrscheinlichkeiten sind damit Teil eines konkreten Ablaufs: Sie stammen aus trainierten Klassifikatoren und werden anschließend daraufhin untersucht, ob sie fehlkalibriert sind. Das Training ist also nicht das abschließende Ergebnis der Anleitung, sondern die Voraussetzung für die Untersuchung, um die es im Titel geht.
Die Originalmeldung nennt weder die konkreten Klassifikatoren noch den verwendeten Datensatz. Fest steht lediglich, dass es sich um zwei Klassifikatoren und einen realen Datensatz handelt. Daraus lässt sich der Aufbau des Tutorials beschreiben, aber nicht ableiten, wie sich bestimmte Modelle oder Datensätze auf die Kalibrierung auswirken. Auch steht in der Meldung nicht, ob die beiden Klassifikatoren unterschiedlich stark fehlkalibriert sind. Die Zahl der Modelle beschreibt den Umfang der Übung, nicht das Ergebnis eines Modellvergleichs.
Zuverlässigkeitsdiagramm und Brier-Score dienen der Diagnose
Nach dem Training wechselt die Anleitung von der Modellerstellung zur Untersuchung der ausgegebenen Wahrscheinlichkeiten. Dafür verwendet sie ein Zuverlässigkeitsdiagramm und den Brier-Score. Das Diagramm übernimmt dabei die grafische Darstellung, während der Brier-Score eine Kennzahl beisteuert. Beide werden in der Meldung ausdrücklich als Mittel genannt, um die Fehlkalibrierung sichtbar zu machen. Sie gehören damit zum Diagnoseschritt und nicht zu den Verfahren, mit denen das Tutorial die Wahrscheinlichkeiten korrigiert.
Diese Trennung ist für das Verständnis des Ablaufs wichtig: Die Anleitung beginnt nicht mit der Frage, welches Kalibrierungsverfahren eingesetzt werden soll. Zunächst zeigt sie, dass die ausgegebenen Wahrscheinlichkeiten fehlkalibriert sind. Erst daran schließt die Korrektur an. Die Originalmeldung gibt allerdings weder das Zuverlässigkeitsdiagramm wieder noch nennt sie Werte für den Brier-Score. Sie beschreibt somit, womit die Fehlkalibrierung untersucht wird, gibt aber keinen Aufschluss darüber, wie die Befunde für die beiden Klassifikatoren im Einzelnen aussehen.
Zwei Verfahren setzen bei der erkannten Fehlkalibrierung an
Für die Korrektur nennt die Anleitung zwei Verfahren: Platt-Skalierung und isotone Regression. Beide stehen im beschriebenen Ablauf nach der Diagnose. Ihre Aufgabe unterscheidet sich damit von der des Zuverlässigkeitsdiagramms und des Brier-Scores. Während Diagramm und Kennzahl die Fehlkalibrierung aufzeigen, kommen die beiden Kalibrierungsverfahren zum Einsatz, um sie zu korrigieren. Die Meldung beschreibt also nicht nur, wie die Anleitung ein Problem sichtbar macht, sondern auch, welche Verfahren sie anschließend darauf anwendet.
Die Nennung zweier Verfahren ist jedoch kein Beleg dafür, dass eines besser abschneidet als das andere. Die Meldung nennt keine Ergebnisse, mit denen sich Platt-Skalierung und isotone Regression gegeneinander abwägen ließen. Ebenso wenig weist sie eines der Verfahren ausdrücklich einem bestimmten der beiden Klassifikatoren zu. Aus dem Original lässt sich deshalb die Rolle der beiden Verfahren im Tutorial erklären, aber keine Empfehlung ableiten, welches Verfahren für ein bestimmtes Modell vorzuziehen ist.
Bedeutung für die KI-Branche
Für die Praxis des maschinellen Lernens liegt der Beitrag der Anleitung darin, dass sie das Training von Klassifikatoren und die Prüfung ihrer Wahrscheinlichkeiten als getrennte Schritte behandelt. Der beschriebene Ablauf endet nicht mit den trainierten Modellen. Er führt weiter zur Frage, was das Zuverlässigkeitsdiagramm und der Brier-Score über die ausgegebenen Wahrscheinlichkeiten zeigen, und erst danach zu den Verfahren, die bei einer Fehlkalibrierung zum Einsatz kommen. So macht die Anleitung deutlich, welche Aufgabe jeder Schritt innerhalb des Beispiels erfüllt.
Die Veröffentlichung ist als technische Anleitung einzuordnen. Ihr Schwerpunkt liegt darauf, den Weg vom Training über die Diagnose bis zur Kalibrierung anhand zweier scikit-learn-Klassifikatoren nachzuvollziehen. Die Meldung liefert dagegen keine Grundlage für eine allgemeine Rangfolge der Kalibrierungsverfahren oder für Aussagen darüber, wie groß der Effekt der Korrektur ausfällt. Die praktische Aussage beschränkt sich auf den vorgestellten Ablauf: Wahrscheinlichkeiten werden nach dem Training untersucht, eine Fehlkalibrierung wird sichtbar gemacht und anschließend mit den beiden genannten Verfahren korrigiert.
Häufig gestellte Fragen
Frage: Was wird in dem scikit-learn-Tutorial trainiert?
Die Anleitung sieht das Training von zwei Klassifikatoren auf einem realen Datensatz vor. Die von ihnen ausgegebenen Wahrscheinlichkeiten bilden die Grundlage für die anschließende Untersuchung der Fehlkalibrierung. Welche Klassifikatoren trainiert werden und um welchen Datensatz es sich handelt, geht aus der Originalmeldung nicht hervor.
Frage: Wie macht das Tutorial die Fehlkalibrierung sichtbar?
Dazu nutzt es ein Zuverlässigkeitsdiagramm und den Brier-Score. Das Diagramm liefert die grafische Darstellung, der Brier-Score die Kennzahl. Beide gehören zur Prüfung der Wahrscheinlichkeiten vor der Korrektur. Die Meldung nennt dabei keine konkreten Werte und zeigt nicht, wie das Diagramm für die beiden Modelle ausfällt.
Frage: Welche Verfahren verwendet die Anleitung zur Kalibrierung?
Die Anleitung setzt Platt-Skalierung und isotone Regression ein, um die zuvor sichtbar gemachte Fehlkalibrierung zu korrigieren. Aus der Meldung geht nicht hervor, ob eines der beiden Verfahren im Beispiel bessere Ergebnisse erzielt. Sie nennt beide als Teil des Tutorials, ohne daraus eine Rangfolge oder eine Empfehlung für die Verfahrenswahl abzuleiten.