技术教程AI开发Python机器学习
Scikit-learn分类器概率校准完全指南:提升模型预测置信度
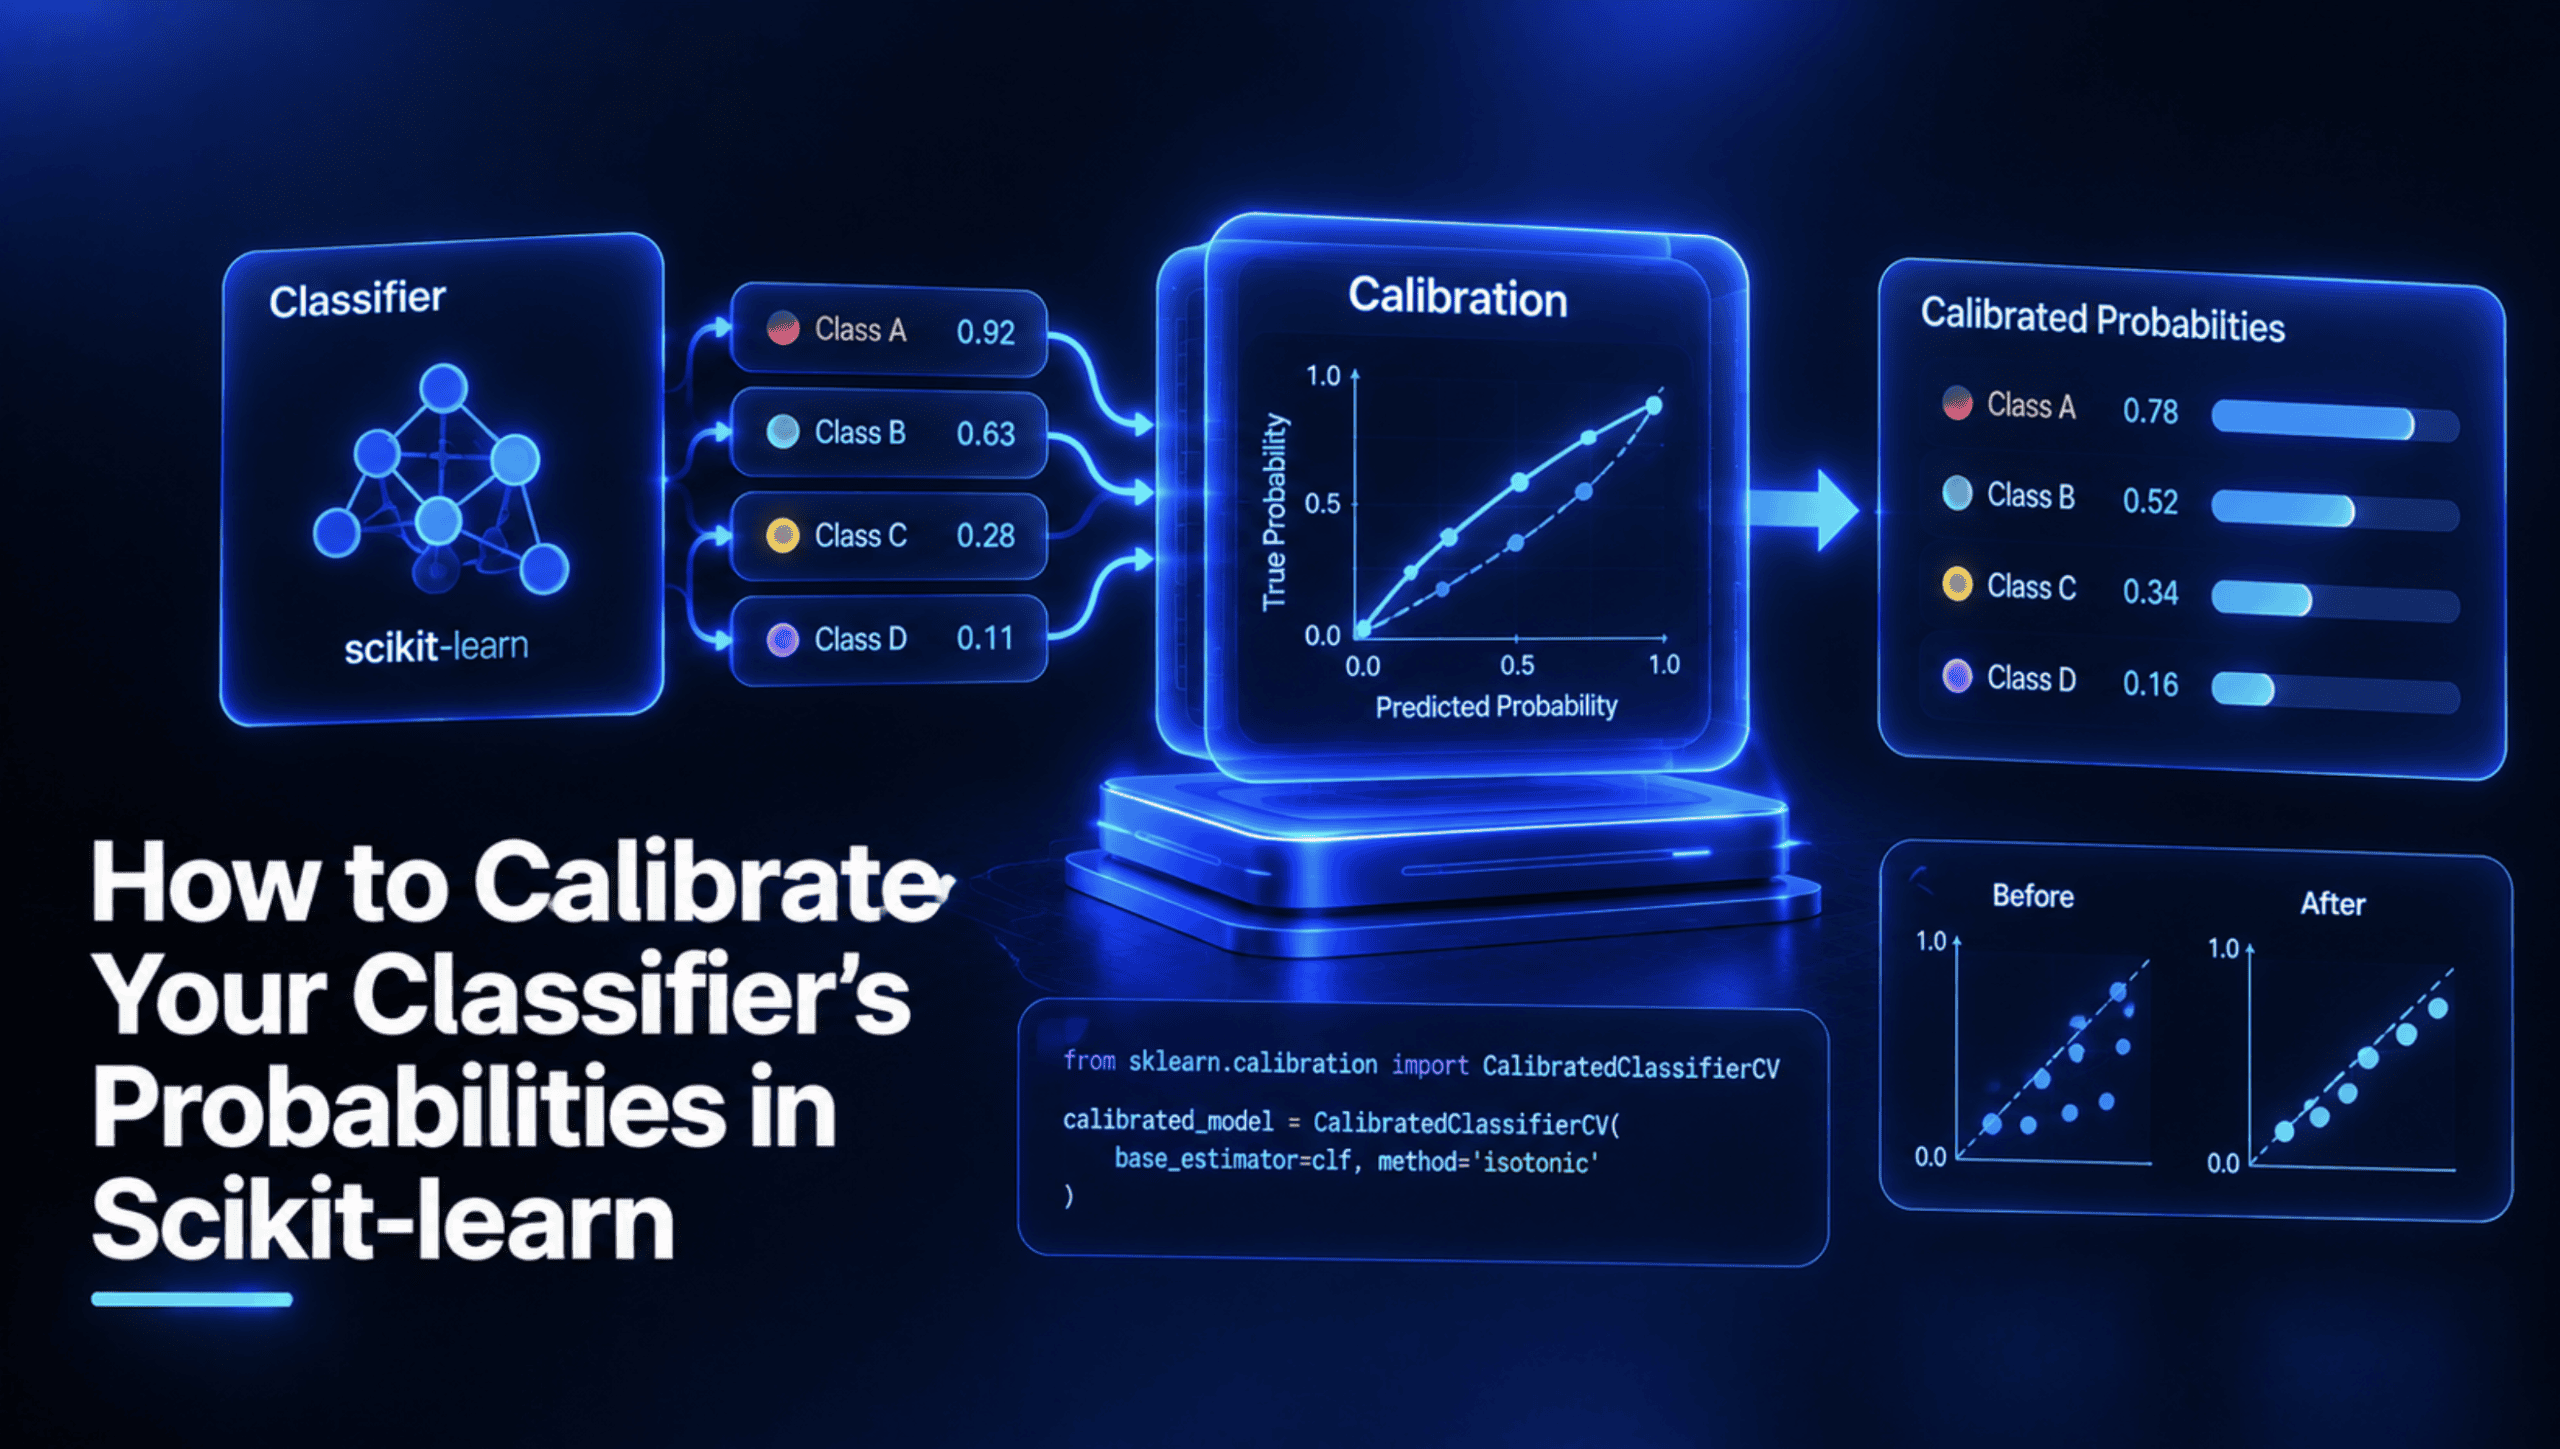
KDnuggets发布最新教程,详细讲解在Scikit-learn中如何通过可靠性图与Brier分数评估分类器概率失准,并利用Platt标度与等渗回归技术进行修复,帮助开发者构建更可靠的AI模型。
KDnuggets
核心要点
- 分类器概率失准:理解模型预测概率与实际结果之间偏差的检测方法。
- 检测工具:利用可靠性图(Reliability Diagram)与Brier分数量化模型表现。
- 校准技术:掌握Platt标度(Platt Scaling)与等渗回归(Isotonic Regression)的实施手段。
详细分析
模型校准的重要性
在机器学习分类任务中,模型输出的概率值不仅代表分类标签,往往还被视为置信度。然而,许多分类器(如SVM、随机森林)输出的原始概率并不等同于真实的频率。如果概率不可靠,下游决策系统可能做出错误的判断。本文探讨了识别这一问题的标准流程。
校准方法解析
教程中重点介绍了两种主要的技术手段:
- Platt标度:通过逻辑回归拟合模型输出来校准概率,适用于样本量较小的情况,具有较好的平滑性。
- 等渗回归:一种非参数方法,通过对预测概率进行非递减转换来校准。它在数据量充足时表现优异,能够捕捉更复杂的非线性校准曲线。
行业影响
随着AI在医疗、金融等高风险决策领域的广泛应用,模型输出的“置信度”是否准确已成为行业关注的焦点。能够通过Scikit-learn等标准库对分类器进行概率校准,是构建可信AI系统的基础能力,能显著提升模型在实际生产环境中的鲁棒性。
常见问题
什么是概率校准?
概率校准是指调整分类器输出的概率值,使其能够反映事件发生的真实频率。例如,对于所有预测概率为0.8的样本,理论上应该有80%的样本属于正类。
什么时候使用Platt标度?
Platt标度通常在数据量较少时使用,因为其具有参数化特性,不容易出现过拟合,能够提供平滑的校准结果。