美团发布SLM推理引擎:20ms超低延迟下吞吐提升10倍
美团技术团队针对搜推场景下0.5~1B小语言模型(SLM)落地难题,发布高并发推理引擎。该引擎专为有界生成负载设计,采用静态DAG、AOTInductor编译与选择性FP8等优化,将端到端时延压缩至20ms以内,吞吐相较SGLang提升10倍,Prefill-only有效MFU达67%,为大规模工业应用提供可靠实践。
核心要点
- 专为有界生成负载定制:针对搜推场景中0.5~1B小语言模型(SLM)的Prefill-Only与固定步数Beam Search需求,界定确定性计算上界,彻底摆脱通用大模型动态调度的冗余开销。
- 极致的超低时延与高吞吐:在平均端到端时延低于20ms的严苛在线约束下,Prefill-only有效MFU达到67%,系统整体吞吐相较SGLang提升高达10倍。
- 全链路软硬件协同优化:采用静态DAG编排完整请求,深度结合AOTInductor编译、Packed Prefill、请求内K/V共享以及选择性FP8量化技术。
- 工业级可复用落地范本:解决了SLM在搜索推荐核心链路上因推理开销过大而难以全面铺开的工程痛点,为高并发在线业务提供了极具参考价值的实践路径。
详细分析
锚定“有界生成负载”,颠覆通用推理引擎设计思路
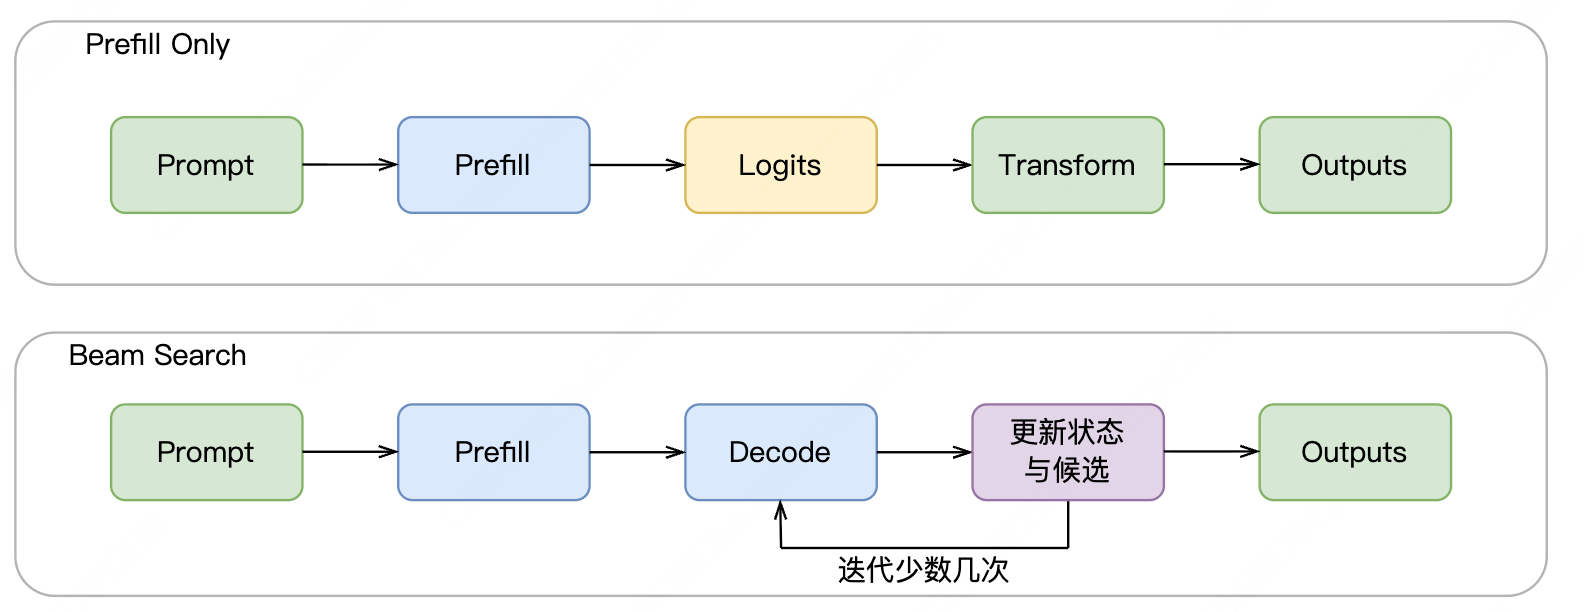
在搜索与推荐等在线高频场景中,SLM(0.5~1B参数量的小语言模型)被广泛应用于意图理解、相关性计算和生成式推荐。尽管这类模型依然保持着Decoder-only结构与Next-Token预测机制,但其实际执行形态与传统开放式文本生成截然不同。美团技术团队将其提炼为“有界生成负载”:一种是直接以Prefill末尾Token位置的Logits做分类或接MLP的Prefill-Only模式;另一种则是限定解码步数与候选宽度的Beam Search模式。这两种模式的输入规模、迭代次数和状态容量均可在部署前严格限定。现有如SGLang等通用大模型推理框架针对无界开放式生成进行了复杂的动态调度设计,反而在搜推的极低延迟约束下带来了显著的调度开销与资源浪费。
静态DAG与深度编译结合,压榨全链路计算与调度极限
为解决通用引擎在严苛时延约束下的性能瓶颈,美团重构了在线推理执行路径。系统采用静态有向无环图(DAG)对端到端业务请求进行全生命周期编排,固化执行拓扑以系统性压缩调度开销。在算力执行层面,引入PyTorch AOTInductor进行深度编译优化,生成高效内核;搭配Packed Prefill消除填充浪费,并结合请求内部的K/V Cache共享策略大幅减少冗余计算。此外,引擎引入选择性FP8低精度推理,在严格控制精度损失的同时实现算力利用率的飞跃,最终将Prefill-only下的有效MFU推高至67%,端到端平均延迟稳定压制在20ms以内。
从实验验证到降本推全,构建高复用工业基座
在技术探索早期,美团通过Triton Inference Server的Python Backend配合SGLang快速完成算法验证并取得显著收益;但随着SLM在搜索推荐中持续铺开,传统方案推全成本剧增,难以支撑更大规模的应用落地。全新的高并发推理引擎不仅将推理吞吐提升了整整10倍,更通过高度可复用的工程架构设计,打通了从快速业务实验到大规模高并发推全的完整链路,有效化解了生成式模型效果创新与线上推理成本之间的冲突。
行业影响
美团该项工程实践标志着大模型推理技术正从“通用型大一统架构”迈向“场景化专用架构”的精细化深水区。对于高频并发、时延极度敏感的本地生活、电商搜推及实时计算业务而言,参数量0.5~1B的SLM具备优秀的语义表征与理解能力,是ROI极高的技术方向。然而,工业级落地往往受困于在线推理引擎的吞吐与延迟瓶颈。美团所展示的静态DAG图编排与深度编译优化范式,证明了对特定负载实施结构固化和软硬协同优化的巨大威力,为整个互联网行业在搜推核心链路全面铺开生成式小模型提供了成熟的工程范本。
常见问题
什么是搜推场景中的“有界生成负载”?
有界生成负载是指在服务部署或调用前,请求的控制流结构、显存状态容量及最大迭代解码步数均可预先确定的工作负载。在搜推中主要表现为两类:一是只执行一次Prefill并提取表征用于分类排序的Prefill-Only模式;二是指定固定解码步数与搜索宽度的Beam Search模式。
通用大模型推理引擎为何在搜推极低时延场景表现不佳?
主流通用大模型推理引擎(如SGLang等)通常针对不定长、多轮对话等无界开放式文本生成设计,具备复杂的动态调度与内存管理机制。在搜推要求平均延迟小于20ms的极端高并发约束下,这些调度反而成为不可忽视的系统瓶颈,导致硬件有效利用率(MFU)偏低。
美团SLM推理引擎实现10倍吞吐提升的核心手段是什么?
核心手段包括:以静态DAG组织完整业务请求以消除动态调度损耗;采用AOTInductor编译生成高性能内核;引入Packed Prefill和请求内K/V共享避免冗余计算;以及通过选择性FP8量化大幅压缩计算开销。