Gemini 3.8 & 3.8 Live Extended Thinking
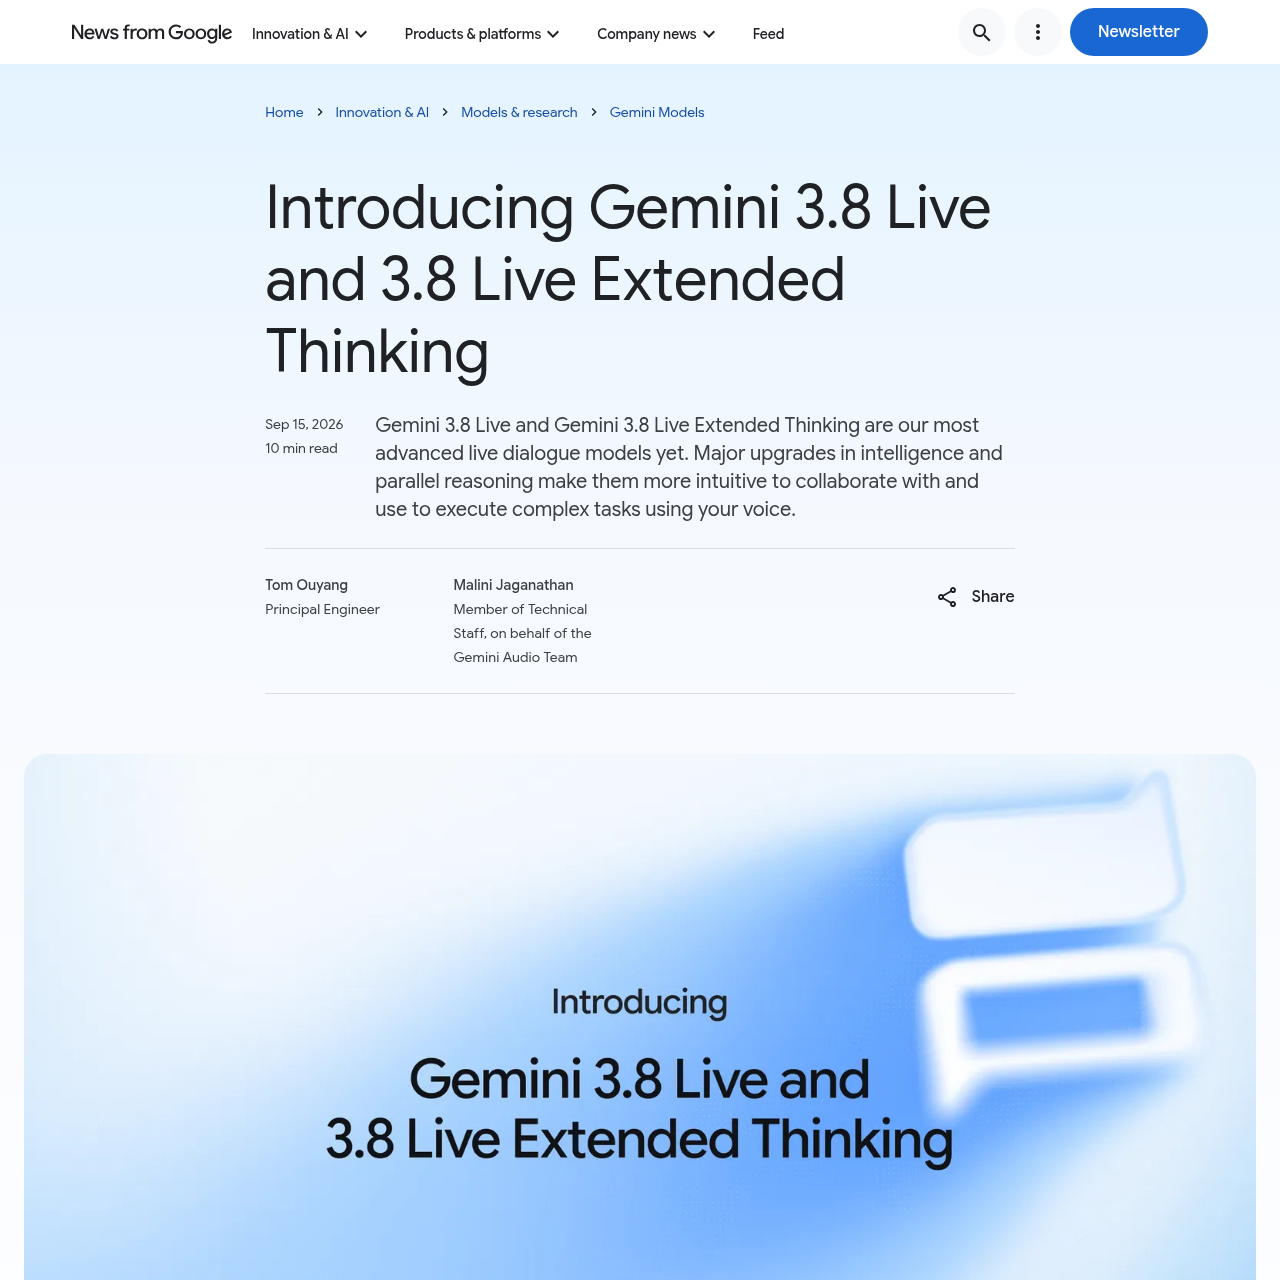
Gemini 3.8 Live 与 3.8 Live Extended Thinking 是专为并发推理、后台工具调用以及实时交互式语音工作流而设计的实时语音与多模态对话模型。
Gemini 3.8 Live 与 3.8 Live Extended Thinking 是专为并发推理、后台工具调用以及实时交互式语音工作流而设计的实时语音与多模态对话模型。
产品用途与官方定位
Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 是专为近实时语音交互、视觉对齐以及多步推理而构建的对话模型。
Gemini 3.8 Live 专注于支持 97 种语言自动切换的可扩展对话智能,而 3.8 Live Extended Thinking 则提供同步并行推理、早期对话提示以及连续的后台任务解说。
有官方来源支持的使用场景
利用实时视觉上下文解答各类疑问,动态指导员工入职培训流程。
在不中断实时语音对话的情况下,协同处理多步骤预订并执行后台函数调用。
将手绘视觉草图和口头语音指令直接转换为功能完备的 React 组件。
Gemini 3.8 Live Extended Thinking 通过同时进行推理和发声,解决了语音工作流中的中断问题。在处理复杂请求时,该模型不会暂停对话,而是会引入口头确认和进度解说等对话提示。
后台执行能力使这两款模型能够异步发起 API 调用、运行外部工具并处理多步骤操作。在底层任务执行完毕之前,语音交互无需停顿即可持续进行。
用自己的素材和工作流完成验证
核对了哪些信息以及核对时间
基于已核对产品资料的回答
它能够同时进行推理和发声,在后台运行多步骤任务的同时,通过自然的口头确认与实时进度解说来保持对话流畅进行。
这些模型无需手动调整设置,即可在对话过程中自动检测并在 97 种受支持的语言之间进行无缝切换。
模型生成的所有音频输出均直接嵌入了难以察觉的 SynthID 水印,以确保媒体内容始终保持可被检测的人工智能生成归属特征。
开发者可以通过 Gemini API 和 Google AI Studio 访问这两款模型,也可以通过受支持的合作伙伴流式平台进行调用。
可以,Gemini 3.8 Live 能够近乎实时地处理视觉输入,使模型能够基于视觉上下文来结合对话情境并回答用户提出的问题。