9 wichtige Kennzahlen für die LLM-Inferenz in fünf Minuten erklärt
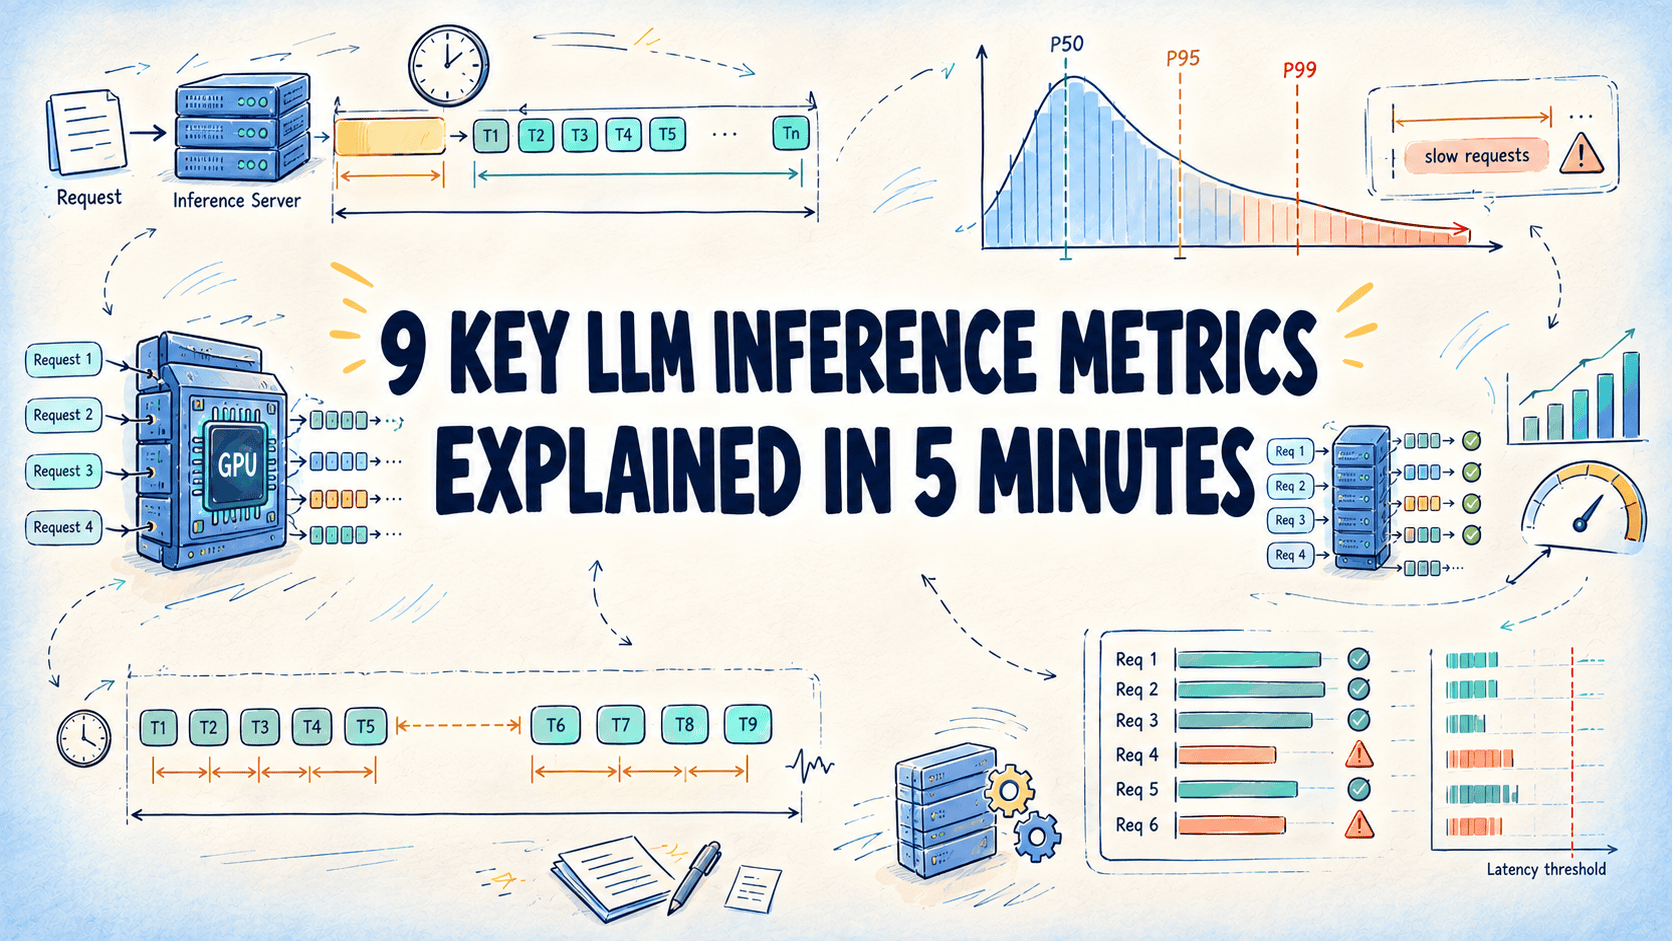
Dieser Analyseartikel beleuchtet die Grundlagen zur Messung der Leistung von Large Language Models (LLMs) bei der Inferenz. Anhand von neun wesentlichen Kennzahlen und Formeln wird veranschaulicht, wie Aspekte wie Latenz, Token-Generierungsgeschwindigkeit und Systemlast präzise erfasst und bewertet werden können. Der Beitrag richtet sich an Entwickler und Fachleute, die die Performance von KI-Inferenzsystemen verstehen und analysieren möchten, ohne dabei spekulative oder externe Details einzubeziehen.
Die wichtigsten Punkte
- Einführung in die Messung der LLM-Inferenzleistung anhand von neun zentralen Kennzahlen.
- Verwendung spezifischer Formeln zur Bestimmung von Leistungswerten.
- Fokus auf Kernbereiche wie Latenz, Token-Generierungsgeschwindigkeit und Systemlast.
Analyse
Grundlagen der LLM-Inferenzmessung
Die Messung der Leistung von Large Language Models während der Inferenzphase ist ein entscheidender Schritt zur Bewertung von Systemen. Der Originalbeitrag von KDnuggets, verfasst von Bala Priya C, bietet eine strukturierte Übersicht über neun wesentliche Metriken. Diese Kennzahlen ermöglichen es, technische Abläufe bei der Ausführung von KI-Modellen quantitativ zu erfassen.
Fokus auf Latenz und Geschwindigkeit
Ein zentraler Aspekt der Analyse dreht sich um die Bestimmung von Antwortzeiten und der Effizienz der Modellausgabe. Dabei spielen Kennzahlen zur Latenz sowie zur Geschwindigkeit der Token-Generierung eine übergeordnete Rolle, um zu bewerten, wie schnell ein Sprachmodell auf Eingaben reagiert und Text sequenziell ausgibt.
Bewertung der Systemlast
Neben den geschwindigkeitsbezogenen Messwerten wird auch die Systemlast betrachtet. Diese Metriken helfen dabei nachzuvollziehen, wie stark Ressourcen beansprucht werden, wenn ein LLM Inferenzaufgaben ausführt. Alle genannten Bereiche stützen sich direkt auf die im Original definierten Grundkonzepte.
Bedeutung für die KI-Branche
Die präzise Erfassung von Leistungsmetriken ist für den Betrieb und die Optimierung von KI-Anwendungen unerlässlich. Durch standardisierte Kennzahlen für Latenz, Token-Generierungsgeschwindigkeit und Systemlast können Entwickler die Effizienz von Large Language Models besser bewerten und vergleichen. Dies trägt dazu bei, die Skalierbarkeit und Ressourcennutzung von Inferenzsystemen in der Praxis nachvollziehbar zu analysieren.
Häufig gestellte Fragen
Welche Kernbereiche werden bei den LLM-Inferenzmetriken gemessen?
Die Messungen konzentrieren sich auf Latenz, Token-Generierungsgeschwindigkeit und Systemlast.
Woher stammen die Grundlagen dieser Kennzahlen?
Die Informationen basieren auf dem Artikel von Bala Priya C auf KDnuggets zur Erklärung von neun wichtigen LLM-Inferenzmetriken.