Quantisierung und Pruning: Methoden zur Optimierung von Large Language Models für geringere Latenz und Kosten
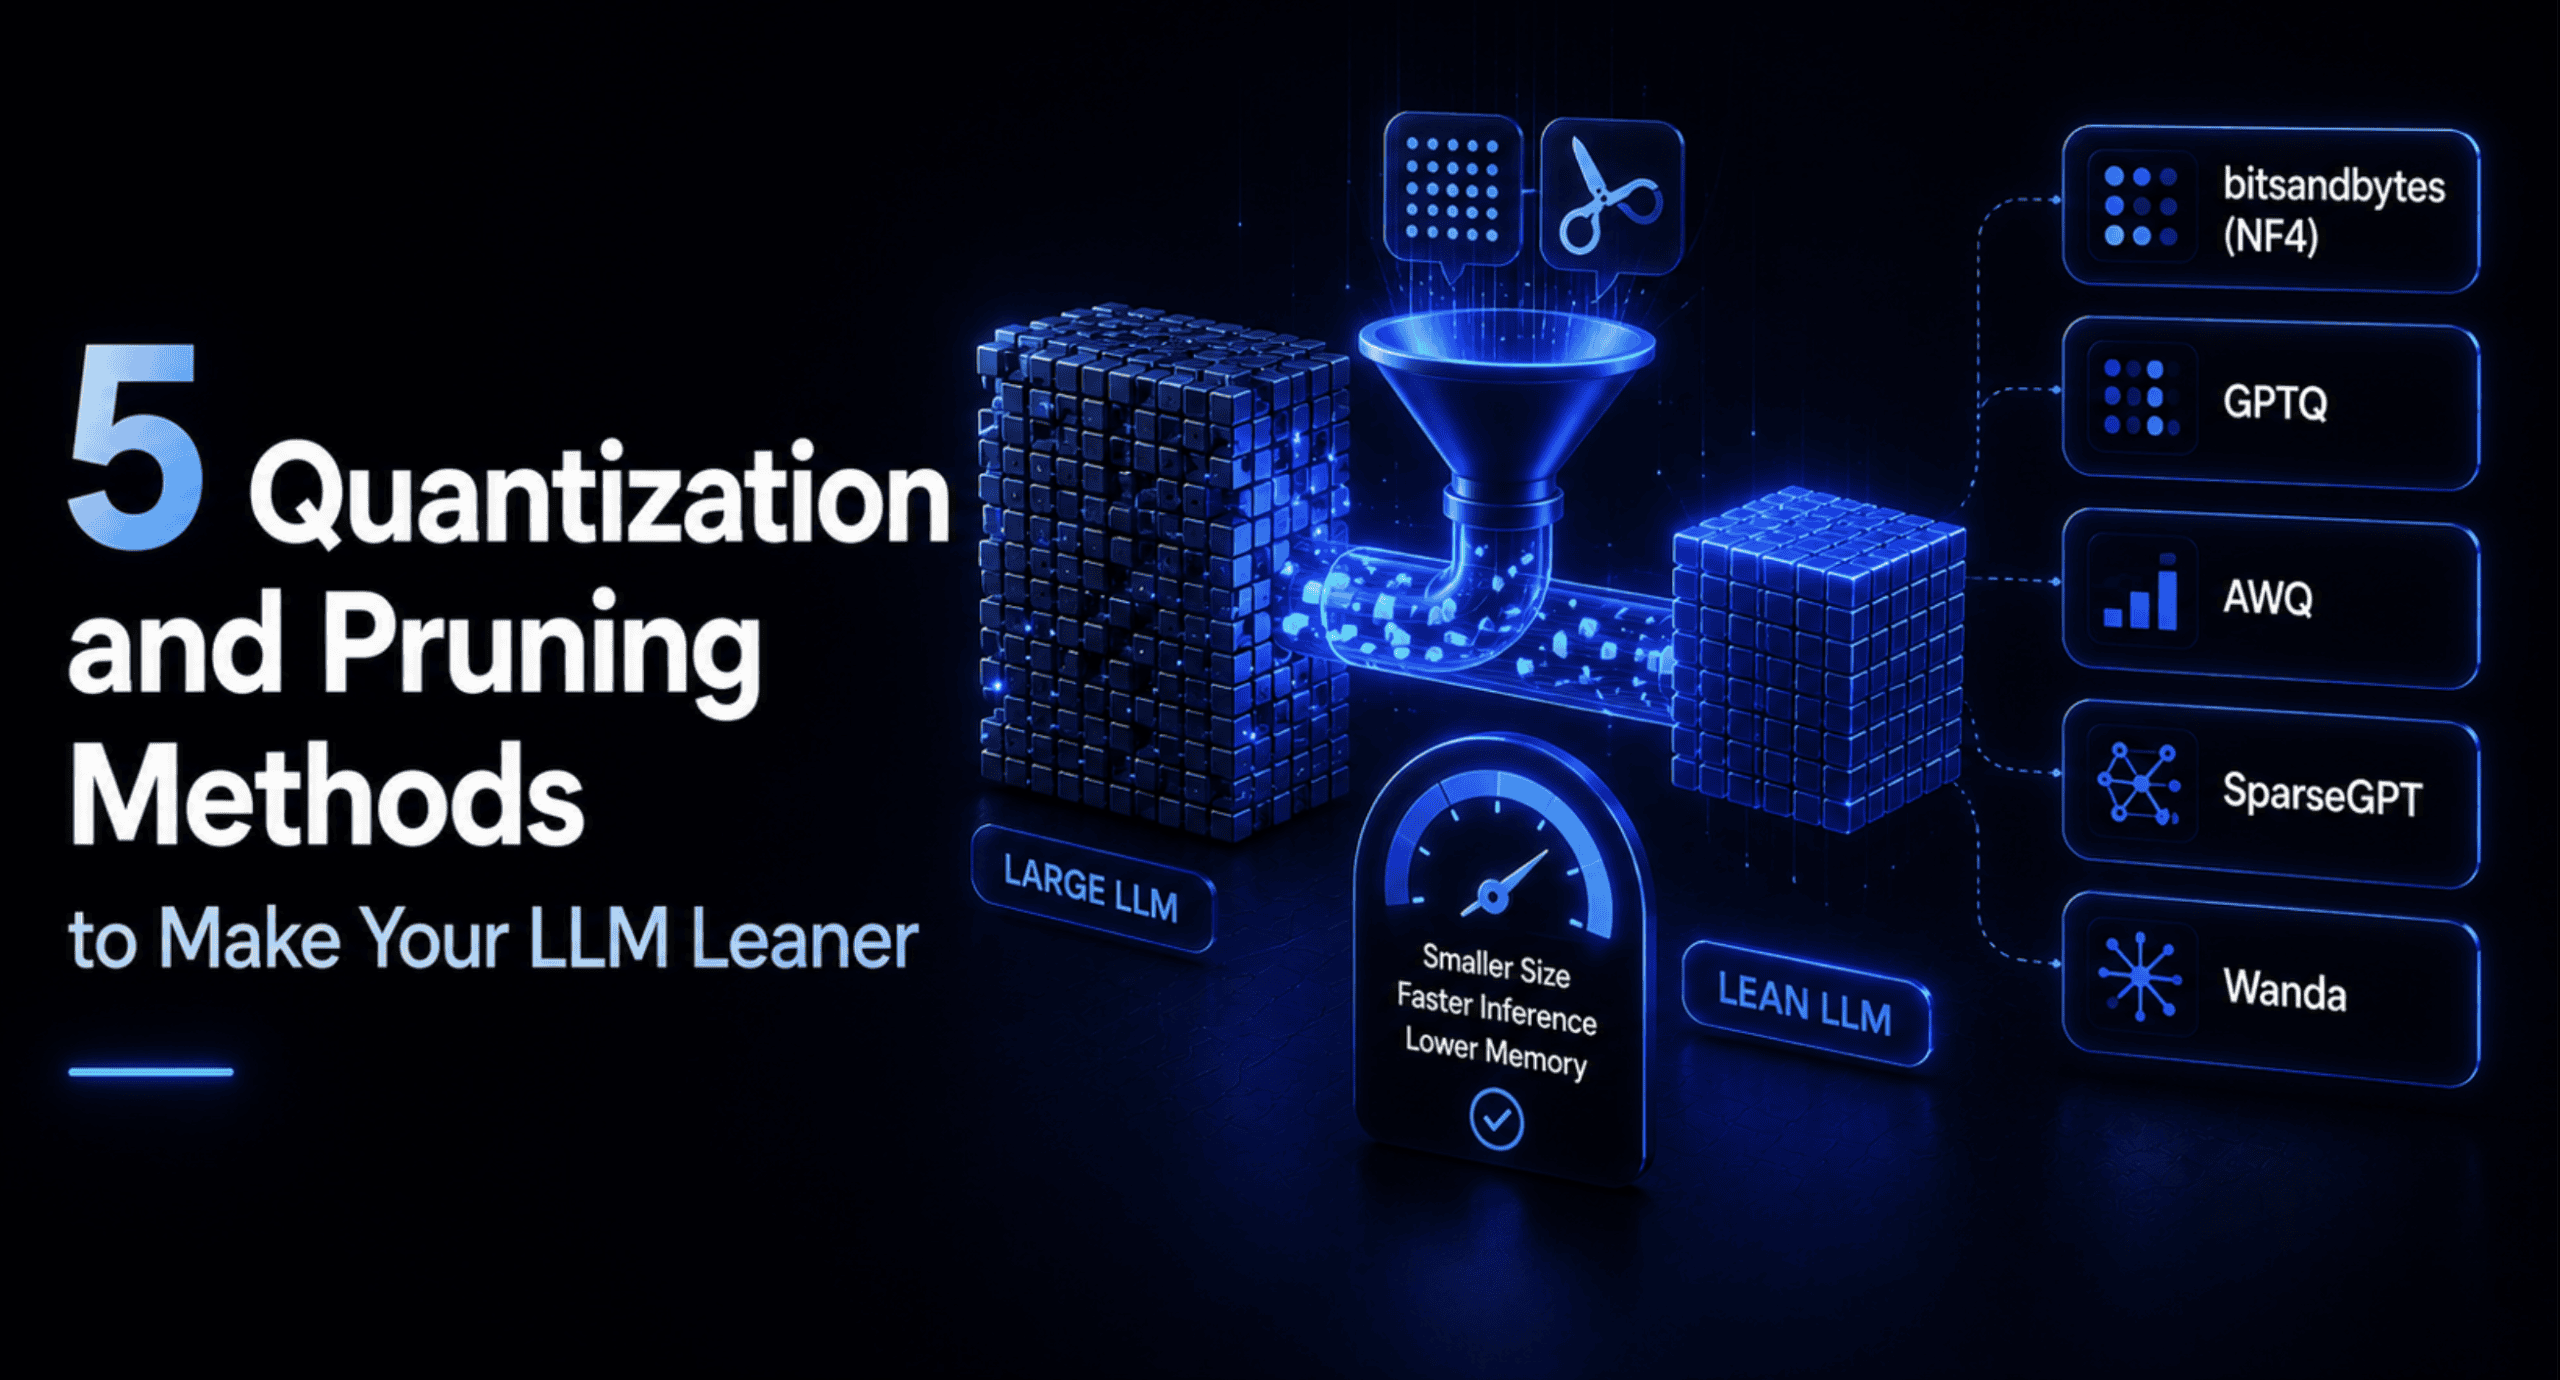
Der Artikel von Shittu Olumide befasst sich mit der Optimierung von Large Language Models (LLMs) durch Quantisierung und Pruning. Diese Techniken sind essenziell, um Modelle „schlanker“ zu machen, was direkt zu einer Reduzierung von Latenzzeiten und Betriebskosten führt. Der Beitrag bietet einen praktischen Einblick in fünf spezifische Methoden, die derzeit in Produktionsumgebungen Anwendung finden, und warnt vor den wirtschaftlichen Folgen, wenn diese Optimierungsschritte vernachlässigt werden. Die Analyse verdeutlicht, dass Effizienzsteigerungen in der KI-Entwicklung nicht nur technische, sondern vor allem wirtschaftliche Vorteile bieten.
Die wichtigsten Punkte
- Effizienzsteigerung: Quantisierung und Pruning sind zentrale Techniken, um Large Language Models (LLMs) ressourcenschonender zu gestalten.
- Kosten- und Zeitersparnis: Die Vernachlässigung dieser Optimierungsmethoden führt zu messbar höheren Betriebskosten und einer gesteigerten Latenz.
- Praxisrelevanz: Es werden fünf spezifische Methoden analysiert, die aktuell erfolgreich in Produktionsumgebungen eingesetzt werden.
- Modellverschlankung: Das Hauptziel besteht darin, Modelle „schlanker“ zu machen, ohne dabei die notwendige Leistungsfähigkeit einzubüßen.
Analyse
Grundlagen der Modelloptimierung: Quantisierung und Pruning
Die Optimierung von Large Language Models ist ein kritischer Schritt für den wirtschaftlichen und technischen Einsatz von Künstlicher Intelligenz. Wie Shittu Olumide in der Analyse darlegt, spielen dabei insbesondere die Verfahren der Quantisierung und des Prunings eine Schlüsselrolle. Diese Techniken zielen darauf ab, die Struktur und die Parameter eines Modells so zu bearbeiten, dass es signifikant weniger Ressourcen verbraucht.
Ein „schlankeres“ Modell ist nicht nur einfacher auf vorhandener Hardware zu handhaben, sondern bietet auch entscheidende Vorteile in der Ausführungsgeschwindigkeit. Die Untersuchung verdeutlicht, dass die Anwendung dieser Methoden kein optionaler Luxus ist, sondern eine technische Notwendigkeit für Unternehmen, die KI-Modelle skalierbar und effizient einsetzen möchten. Dabei geht es primär darum, die mathematische Komplexität der Modelle zu reduzieren, ohne deren fundamentale Fähigkeiten zu verlieren.
Wirtschaftliche Auswirkungen und Performance in der Produktion
Ein wesentlicher Aspekt der Betrachtung ist die Kosten-Nutzen-Analyse. Der Verzicht auf Optimierungstechniken wie Quantisierung und Pruning hat direkte finanzielle Konsequenzen für Unternehmen. Höhere Latenzzeiten bedeuten eine langsamere Verarbeitung von Anfragen, was wiederum die Benutzererfahrung verschlechtert und die benötigte Rechenleistung pro Anfrage in die Höhe treibt.
In realen Produktionsumgebungen entstehen durch ineffiziente Modelle „echte Kosten“. Der Artikel zeigt auf, dass durch den gezielten Einsatz von fünf spezifischen, praxiserprobten Methoden sichergestellt werden kann, dass LLMs sowohl hinsichtlich der Geschwindigkeit als auch der laufenden Betriebskosten optimiert sind. Diese Methoden ermöglichen es, die Lücke zwischen theoretischer Modellleistung und praktischer Anwendbarkeit zu schließen.
Bedeutung für die KI-Branche
Die KI-Branche steht vor der ständigen Herausforderung, immer größere und komplexere Modelle auf begrenzter Hardware effizient auszuführen. Die vorgestellten Methoden zur Modellkompression sind entscheidend für die Demokratisierung und den wirtschaftlich nachhaltigen Betrieb von KI-Technologien. Sie erlauben es, leistungsstarke Modelle auch in Umgebungen mit restriktiven Ressourcen einzusetzen, was die Verbreitung von KI-Anwendungen in verschiedenen Industriesektoren massiv fördert. Die Optimierung ist somit ein wesentlicher Treiber für die Skalierbarkeit moderner KI-Lösungen.
Häufig gestellte Fragen
Warum sollte man LLMs durch Quantisierung und Pruning optimieren?
Die Optimierung reduziert die Modellgröße und die Komplexität. Dies führt direkt zu einer geringeren Latenz bei der Verarbeitung und senkt die Betriebskosten erheblich, was für den produktiven Einsatz von KI-Modellen unerlässlich ist.
Welche Konsequenzen hat das Auslassen dieser Optimierungsschritte?
Das Überspringen dieser Methoden führt zu unnötig hohen Ausgaben für Rechenressourcen und einer schlechteren Performance der Modelle, was sich in längeren Antwortzeiten für den Endnutzer widerspiegelt.
Wie viele Methoden werden für den Einsatz in der Produktion empfohlen?
Der zugrunde liegende Bericht identifiziert fünf spezifische Methoden, die sich aktuell im produktiven Einsatz bewährt haben, um Large Language Models effizienter und kostengünstiger zu betreiben.