
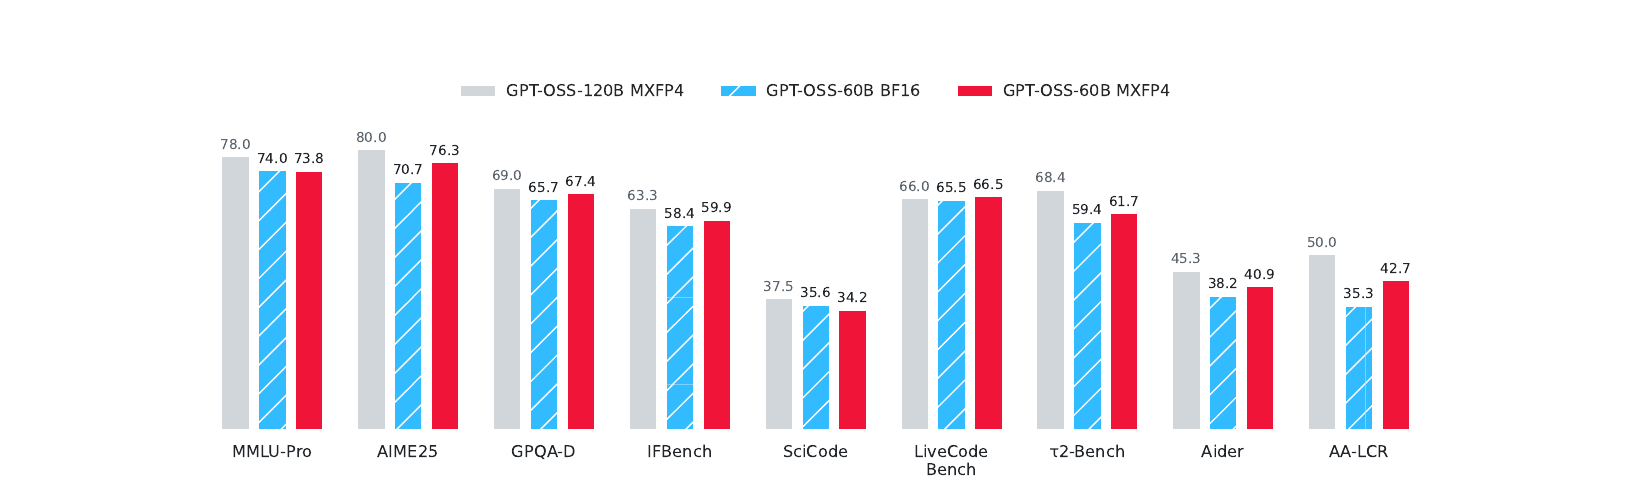
Quantization-Aware Healing: Komprimiertes 4-Bit-Modell übertrifft laut Hugging Face die Full-Precision-Originalversion
Ein neuer Bericht auf dem Hugging Face Blog stellt „Quantization-Aware Healing“ vor, eine innovative Methode zur Modellkompression. Das Besondere an diesem Verfahren ist, dass ein auf 4-Bit reduziertes Modell eine höhere Leistungsfähigkeit aufweist als sein ursprüngliches Modell in voller Präzision (Full-Precision). Während die Quantisierung normalerweise darauf abzielt, die Modellgröße und den Rechenaufwand zu verringern – oft auf Kosten der Genauigkeit –, kehrt dieser Ansatz den Effekt um. Die Technik ermöglicht es, die Effizienz massiv zu steigern und gleichzeitig die Qualität der Ergebnisse über das ursprüngliche Niveau hinaus zu heben. Dies markiert einen bedeutenden Fortschritt in der Optimierung von KI-Modellen, da die Barriere zwischen Ressourceneffizienz und maximaler Performance durchbrochen wird.
Die wichtigsten Punkte
- Vorstellung von „Quantization-Aware Healing“ (QAH) als neue Methode zur Modelloptimierung.
- Ein auf 4-Bit komprimiertes Modell erzielt eine bessere Performance als die ursprüngliche Full-Precision-Variante.
- Die Technik ermöglicht signifikante Einsparungen bei Speicherplatz und Rechenleistung ohne Qualitätsverlust.
- Der Durchbruch zeigt, dass Kompression zur aktiven Verbesserung von KI-Modellen genutzt werden kann.
Analyse
Der Durchbruch durch Quantization-Aware Healing
Die Veröffentlichung auf dem Hugging Face Blog thematisiert eine Entwicklung namens „Quantization-Aware Healing“. Im Kern geht es darum, die Limitationen herkömmlicher Quantisierung zu überwinden. Normalerweise werden bei der Quantisierung die Gewichte eines Modells von einer hohen Präzision (wie 32-Bit oder 16-Bit) auf eine niedrigere (in diesem Fall 4-Bit) reduziert. Dieser Prozess dient dazu, Modelle kleiner und schneller zu machen, führt jedoch in der Regel zu einem messbaren Verlust an Genauigkeit und Vorhersagequalität.
Der Ansatz des „Healing“ (Heilens) scheint diesen Prozess so zu gestalten, dass das Modell während oder nach der Kompression optimiert wird. Das Ergebnis ist ein 4-Bit-Modell, das nicht nur effizienter ist, sondern die Leistungswerte seines eigenen Full-Precision-Originals übertrifft. Dies deutet darauf hin, dass die Methode in der Lage ist, Rauschen zu reduzieren oder die Repräsentationsfähigkeit des Modells trotz geringerer Bit-Tiefe zu schärfen.
Effizienz und Performance im neuen Verhältnis
Die Tatsache, dass ein komprimiertes Modell besser abschneidet als die unkomprimierte Version, stellt ein wichtiges Paradigma in der KI-Entwicklung infrage. Bisher galt die Full-Precision-Version als die theoretische Obergrenze der Genauigkeit, die durch Kompression lediglich so gut wie möglich angenähert werden sollte. Mit „Quantization-Aware Healing“ wird die Kompression von einem notwendigen Übel zur Reduzierung der Hardwareanforderungen zu einem Werkzeug der Qualitätssteigerung.
Da das Modell nun mit nur 4-Bit operiert, benötigt es deutlich weniger Grafikspeicher (VRAM) und ermöglicht schnellere Inferenzzeiten auf gängiger Hardware. Dass dabei die ursprüngliche Qualität nicht nur gehalten, sondern übertroffen wird, macht diese Technik für den praktischen Einsatz in Produktionsumgebungen hochgradig relevant.
Bedeutung für die KI-Branche
Die Einführung von Quantization-Aware Healing könnte die Art und Weise, wie KI-Modelle für den Endnutzer bereitgestellt werden, grundlegend verändern. Für Unternehmen bedeutet dies, dass sie leistungsstärkere Modelle auf kostengünstigerer Hardware betreiben können. In einer Branche, die derzeit stark durch Hardware-Engpässe und hohe Betriebskosten limitiert ist, bietet eine Technik, die gleichzeitig die Effizienz steigert und die Qualität verbessert, einen enormen Wettbewerbsvorteil. Es ist zu erwarten, dass dieser Ansatz das Interesse an spezialisierten Kompressionstechniken weiter befeuern wird, die über die reine Platzersparnis hinausgehen.
Häufig gestellte Fragen
Was genau ist Quantization-Aware Healing?
Es handelt sich um eine Methode zur Kompression von KI-Modellen auf 4-Bit, bei der das resultierende Modell eine höhere Genauigkeit und Leistung erzielt als die ursprüngliche Version in voller Präzision.
Warum ist es ungewöhnlich, dass ein 4-Bit-Modell besser ist als ein Full-Precision-Modell?
Normalerweise geht mit der Reduzierung der Bit-Tiefe (Quantisierung) ein Informationsverlust einher, der die Modellleistung schmälert. Dass ein Modell durch diesen Prozess besser wird, widerspricht dem herkömmlichen Verständnis von Modellkompression.
Welche Vorteile bietet dieses Verfahren in der Praxis?
Durch die 4-Bit-Kompression sinkt der Bedarf an Speicherplatz und Rechenleistung drastisch. Da die Leistung gleichzeitig steigt, erhalten Nutzer schnellere und präzisere KI-Anwendungen bei geringeren Hardwarekosten.
