Warum Simulationen die KI-Entwicklung dominieren: 100-mal günstiger und 10.000-mal schneller bei minimalem Qualitätsverlust
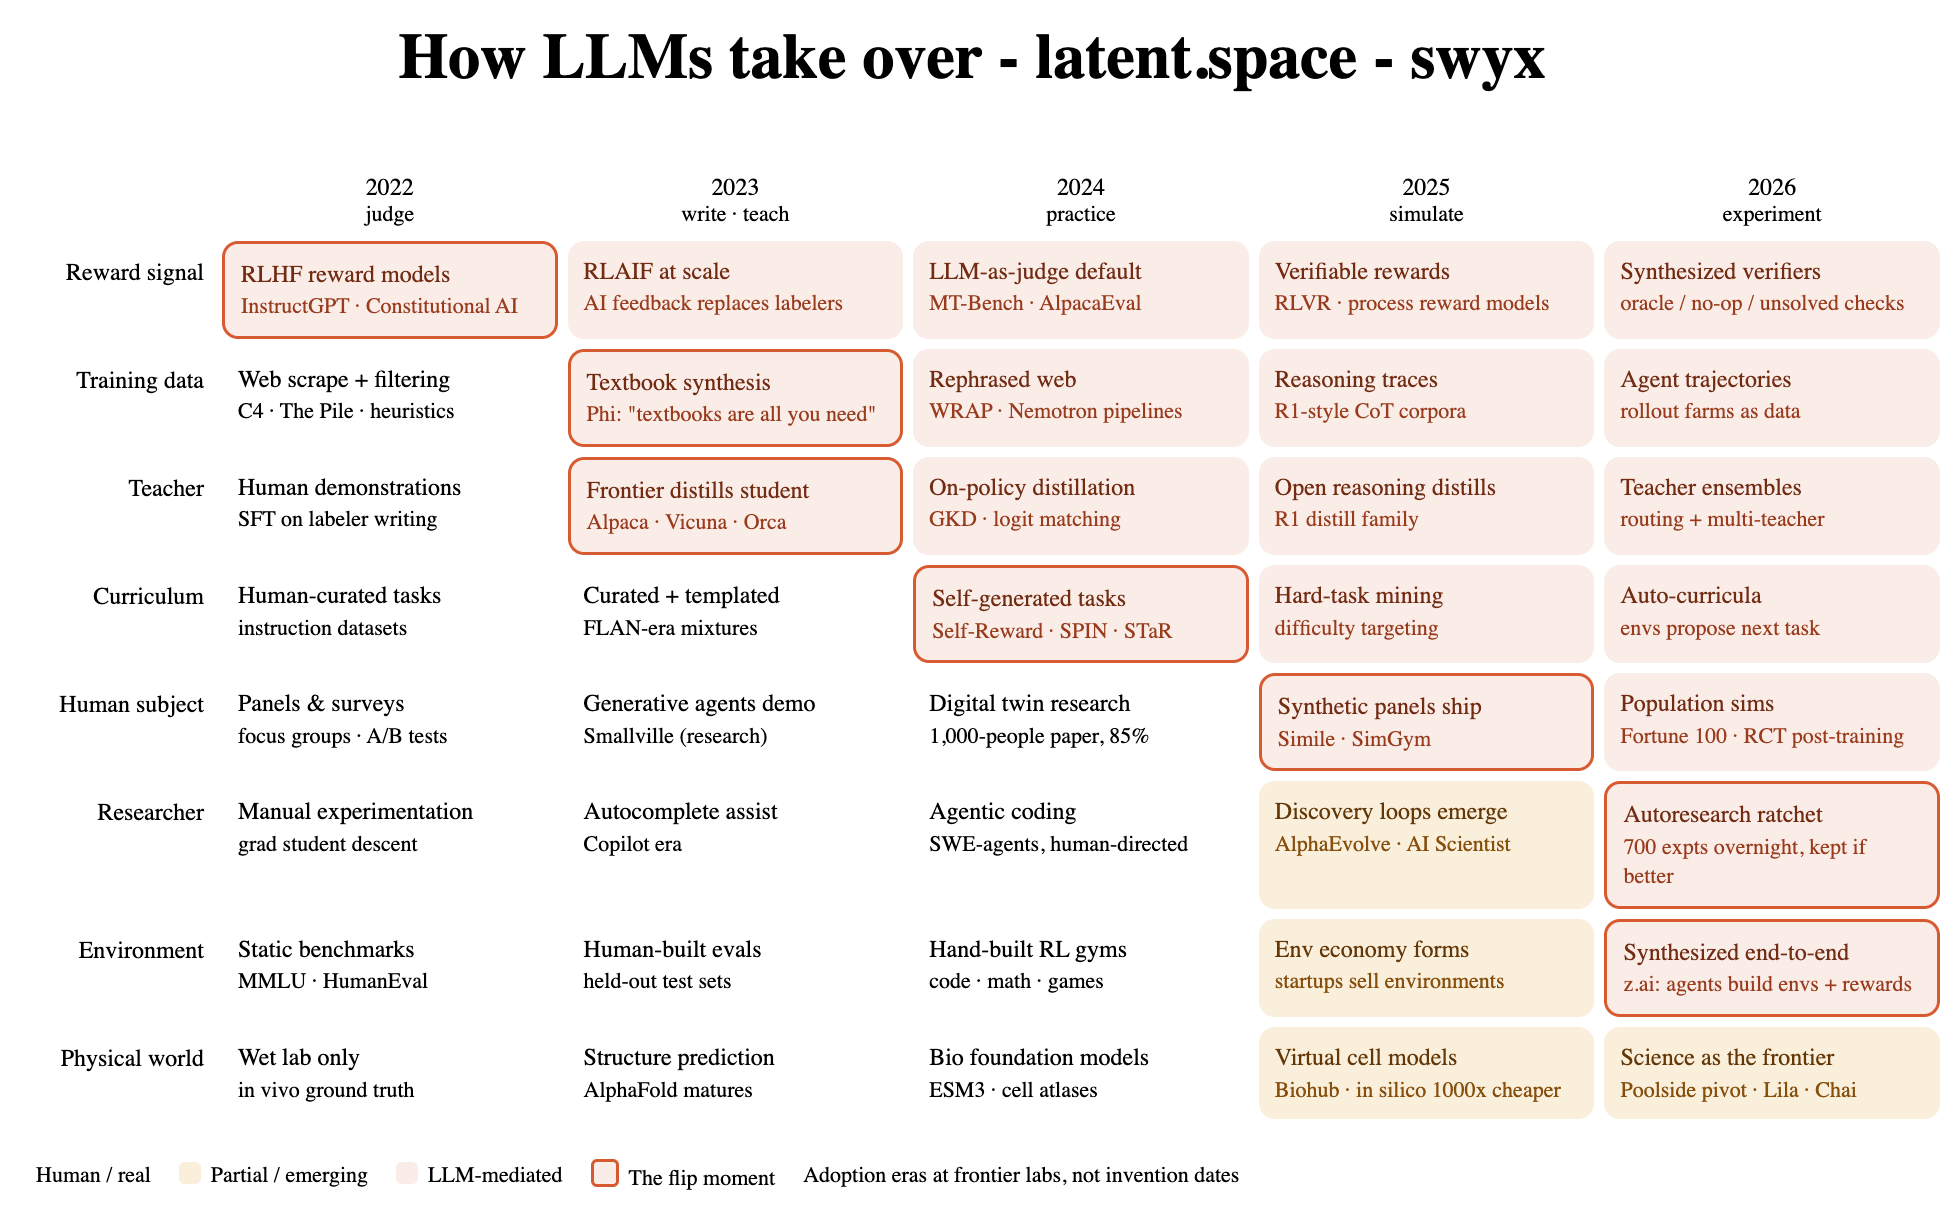
Die aktuelle Analyse von Latent Space beleuchtet einen radikalen Wandel in der KI-Branche: Den massiven Vormarsch von Simulationen. Der Bericht stellt fest, dass Simulationen zwar eine um etwa 10 % geringere Qualität im Vergleich zu herkömmlichen Methoden aufweisen können, diesen Nachteil jedoch durch eine 100-fache Kostenersparnis und eine 10.000-fache Steigerung der Geschwindigkeit mehr als wettmachen. Ein zentraler Aspekt der Untersuchung ist die Erweiterung von RSI (Recursive Self-Improvement). Während RSI bisher primär im Kontext des Modelltrainings betrachtet wurde, deutet die Meldung darauf hin, dass diese Technologie nun auch in anderen Bereichen der KI-Entwicklung Einzug hält. Dieser Trend markiert einen Wendepunkt, an dem Effizienz und Skalierbarkeit gegenüber absoluter Präzision priorisiert werden, um den Fortschritt in der Branche massiv zu beschleunigen.
Die wichtigsten Punkte
- Effizienz-Kompromiss: Simulationen bieten eine 100-fache Kostenreduktion und sind 10.000-mal schneller, bei einem Qualitätsverlust von lediglich 10 %.
- Dominanz der Simulation: Der Einsatz von Simulationen übernimmt zunehmend zentrale Rollen in der KI-Entwicklung.
- Erweiterung von RSI: Recursive Self-Improvement (RSI) beschränkt sich nicht mehr nur auf das reine Modelltraining.
- Skalierbarkeit: Die massiven Geschwindigkeits- und Kostenvorteile ermöglichen eine Skalierung, die mit traditionellen Methoden bisher nicht denkbar war.
Analyse
Das neue Paradigma: Quantität und Geschwindigkeit vor Perfektion
Die von Latent Space präsentierten Zahlen verdeutlichen einen signifikanten Strategiewechsel innerhalb der KI-Forschung und -Anwendung. Die Formel „10 % schlechter, 100-mal günstiger, 10.000-mal schneller“ beschreibt ein neues Paradigma, bei dem die reine Recheneffizienz und die Geschwindigkeit der Iteration über die maximale Genauigkeit gestellt werden.
In der traditionellen KI-Entwicklung wurde oft versucht, jedes Prozent an Genauigkeit durch massiven Einsatz von Ressourcen zu gewinnen. Die Daten von Latent Space legen jedoch nahe, dass die Branche nun Simulationen bevorzugt. Der geringfügige Qualitätsverlust von 10 % wird in Kauf genommen, da die 10.000-fache Geschwindigkeit es ermöglicht, in der gleichen Zeit weitaus mehr Iterationen durchzuführen, als dies mit herkömmlichen, präziseren Methoden möglich wäre. Die 100-fache Kostenersparnis macht diese Technologie zudem für einen breiteren Markt zugänglich und erlaubt Experimente in einem Umfang, der zuvor finanziell nicht tragbar war.
RSI jenseits des Modelltrainings
Ein weiterer entscheidender Punkt der Meldung ist die rhetorische Frage nach dem Einsatzbereich von RSI (Recursive Self-Improvement). Bisher war die allgemeine Annahme, dass RSI vor allem beim Training von Modellen eine Rolle spielt, um deren Fähigkeiten iterativ zu verbessern.
Die Analyse von Latent Space deutet jedoch darauf hin, dass RSI diesen engen Rahmen verlassen hat. Wenn Simulationen die Oberhand gewinnen, wird RSI vermutlich auch in der Generierung von Simulationsumgebungen, der Datenaufbereitung oder der automatisierten Optimierung von Systemarchitekturen eingesetzt. Die Verbindung von Simulation und RSI könnte eine Feedbackschleife erzeugen, die so schnell und kostengünstig ist, dass sie die bisherigen linearen Entwicklungszyklen der KI-Branche vollständig ablöst. Die Simulation fungiert hierbei als Katalysator, der es RSI ermöglicht, in einer geschützten, aber hochgradig skalierbaren Umgebung zu operieren.
Bedeutung für die KI-Branche
Die Verschiebung hin zu Simulationen hat weitreichende Konsequenzen für die gesamte KI-Branche. Unternehmen, die auf hochpräzise, aber langsame und teure Trainingsmethoden setzen, könnten gegenüber Wettbewerbern, die auf schnelle Simulationen setzen, ins Hintertreffen geraten. Die Fähigkeit, Modelle 10.000-mal schneller zu testen und zu verbessern, bedeutet eine drastische Verkürzung der Time-to-Market für neue KI-Produkte.
Zudem verändert die Kostenreduktion um den Faktor 100 die wirtschaftliche Kalkulation hinter KI-Projekten. Es wird möglich, spezialisierte Modelle für Nischenanwendungen zu entwickeln, die zuvor aufgrund der hohen Trainingskosten unrentabel waren. Die Erkenntnis, dass RSI über das Modelltraining hinausgeht, eröffnet zudem neue Forschungsfelder in der Automatisierung der KI-Entwicklung selbst.
Häufig gestellte Fragen
Frage: Warum ist ein Qualitätsverlust von 10 % akzeptabel?
In vielen Anwendungsbereichen der KI ist eine 90-prozentige Genauigkeit, die 10.000-mal schneller erreicht wird, wertvoller als eine 100-prozentige Genauigkeit, deren Erreichung Monate dauert und enorme Summen kostet. Die hohe Geschwindigkeit erlaubt es zudem, durch mehr Iterationen den Qualitätsverlust langfristig wieder auszugleichen.
Frage: Was bedeutet RSI im Zusammenhang mit Simulationen?
RSI steht für Recursive Self-Improvement. Im Kontext von Simulationen bedeutet dies, dass das System nicht nur lernt, Aufgaben besser zu lösen, sondern auch die Simulationen selbst oder die Art und Weise, wie es aus ihnen lernt, eigenständig verbessert. Dies führt zu einer Beschleunigung des gesamten Entwicklungsprozesses.
Frage: Werden traditionelle Trainingsmethoden durch Simulationen ersetzt?
Die Meldung von Latent Space legt nahe, dass Simulationen „übernehmen“. Das bedeutet zwar nicht zwangsläufig das Ende traditioneller Methoden, aber Simulationen werden zum primären Werkzeug für die schnelle Skalierung und Optimierung, während klassisches Training möglicherweise nur noch für finale Feinabstimmungen genutzt wird.